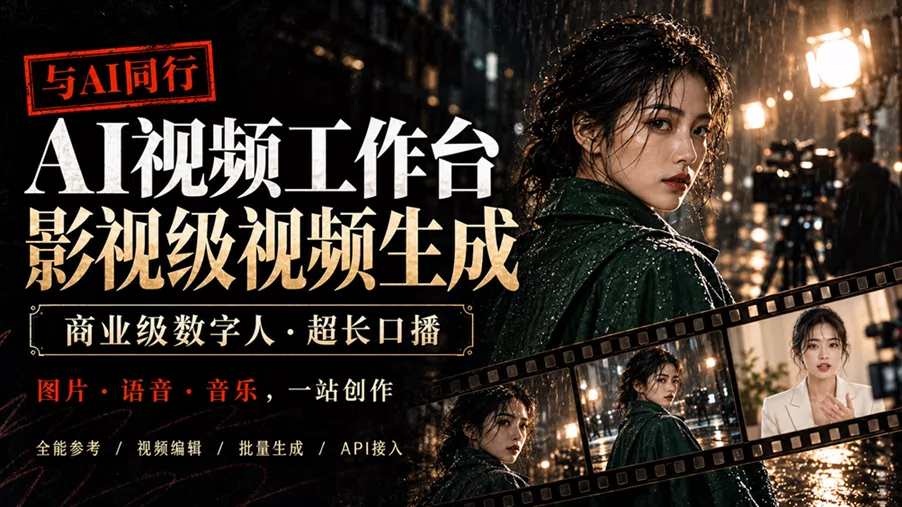
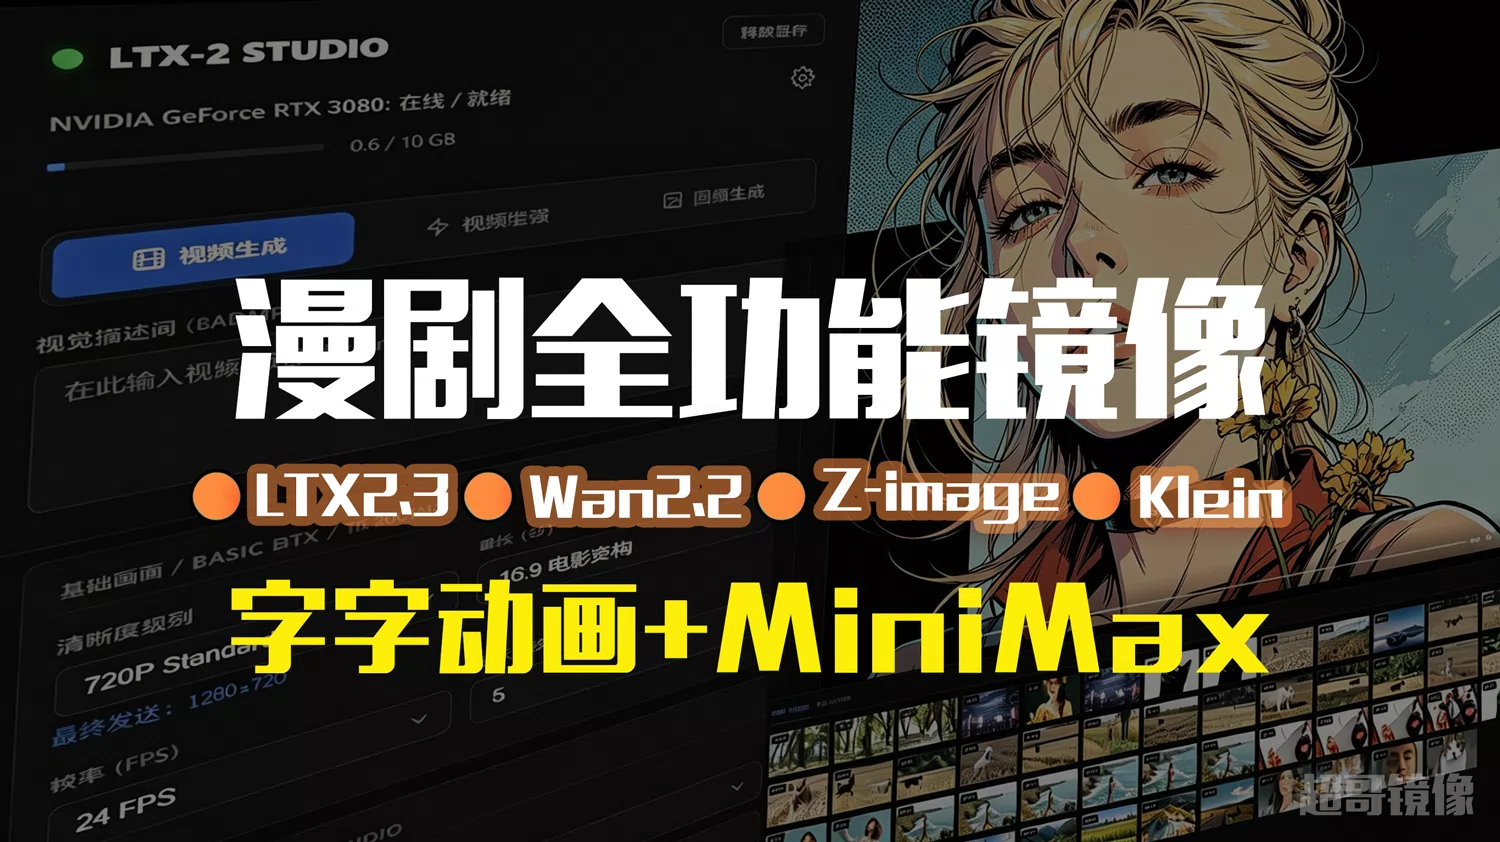
MiniMax-H3-影视级视频工作站
影视级真人质感,文生 | 图生 | 全能参考 | 首尾帧控制,单卡 24G 开箱即用,出片即交付。
运行环境
MiniMax H3 影视级视频工作站 v16
基于 ComfyUI 的 MiniMax H3 视频生成环境,模型、LoRA、依赖全部预装完毕,开机即渲染。 不用装 Python、不用下模型、不用调依赖,省掉最容易卡住的几个小时。
【这个镜像能做什么】
· 文生视频(T2V):一句提示词直接出片 · 图生视频(I2V):给一张图,让它动起来 · 全能参考(R2V):用参考图锁定人物长相、服装、产品外观,换场景不换人 · 首尾帧控制(FL2VA):指定开头和结尾两个画面,中间自动补过渡;首帧、尾帧两个槽位都选填,只给一个也能出
写实人像 LoRA 已内置,人物肤质、光影、微表情接近实拍,适合做口播数字人、产品演示、场景短片。
【已预装内容】
· 运行时:Python 3.12 独立虚拟环境,与系统环境隔离,不污染宿主机 · 引擎:ComfyUI 0.36.0 + MiniMax H3 定制节点 · 主模型:Video-Minimax-H3,已下载并放置到位 · LoRA:h3-realism-people(写实人像,t2v / i2v / r2v 通用)
【怎么用(三步)】
- 开机后等 1~3 分钟,首次加载模型比较慢,别急着判断失败
- 浏览器打开 http://你的实例IP:7860 (门面端口),或直接开 http://你的实例IP:8188 (ComfyUI 原生界面)
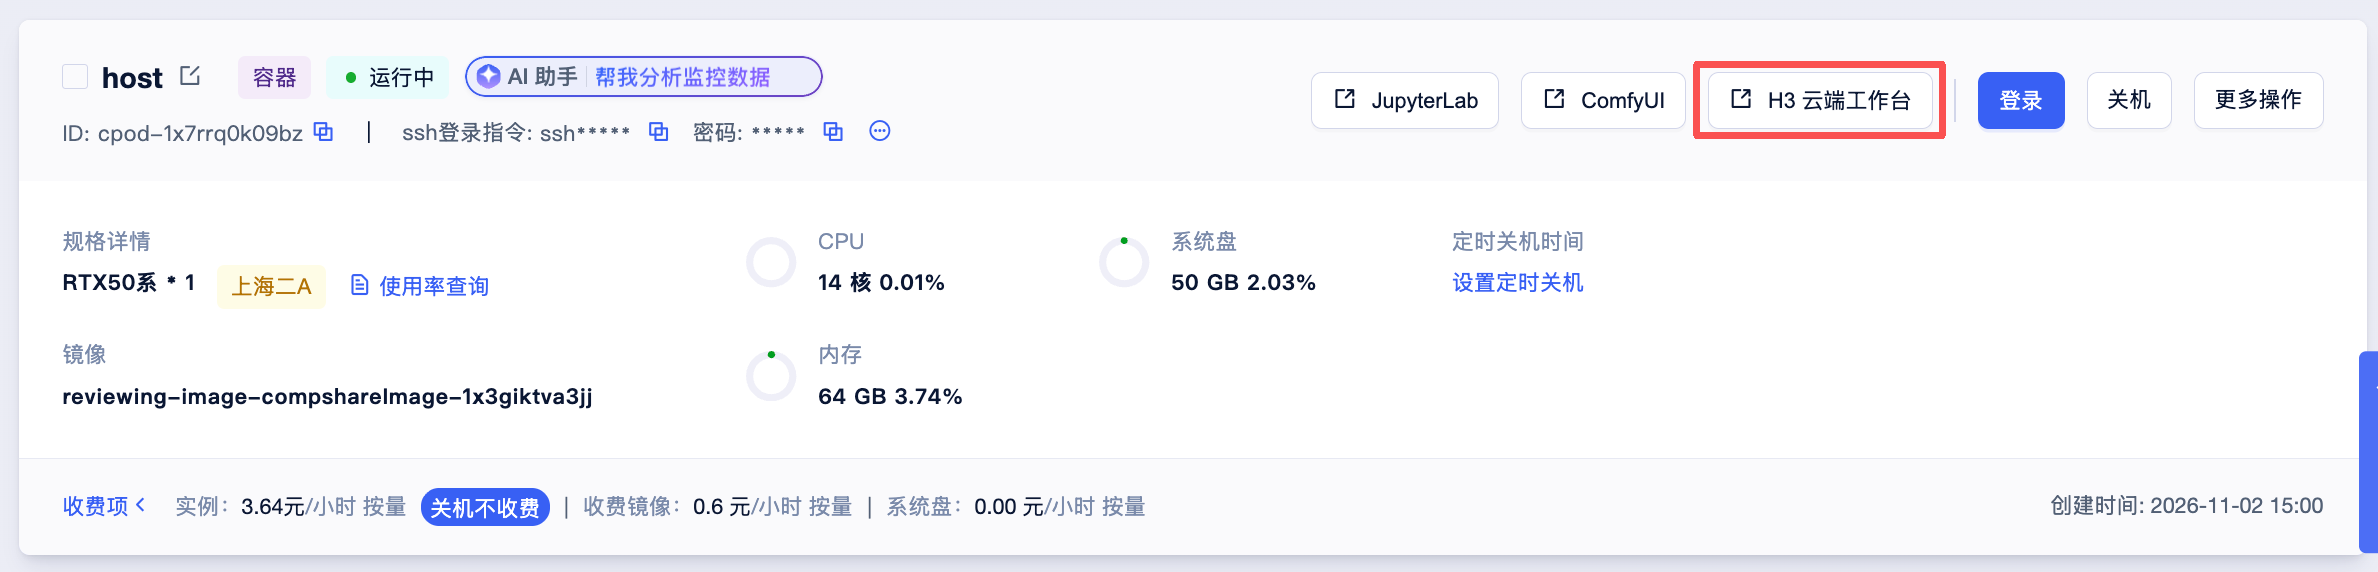
- 加载内置工作流 → 填提示词 / 挂参考图 → 点运行
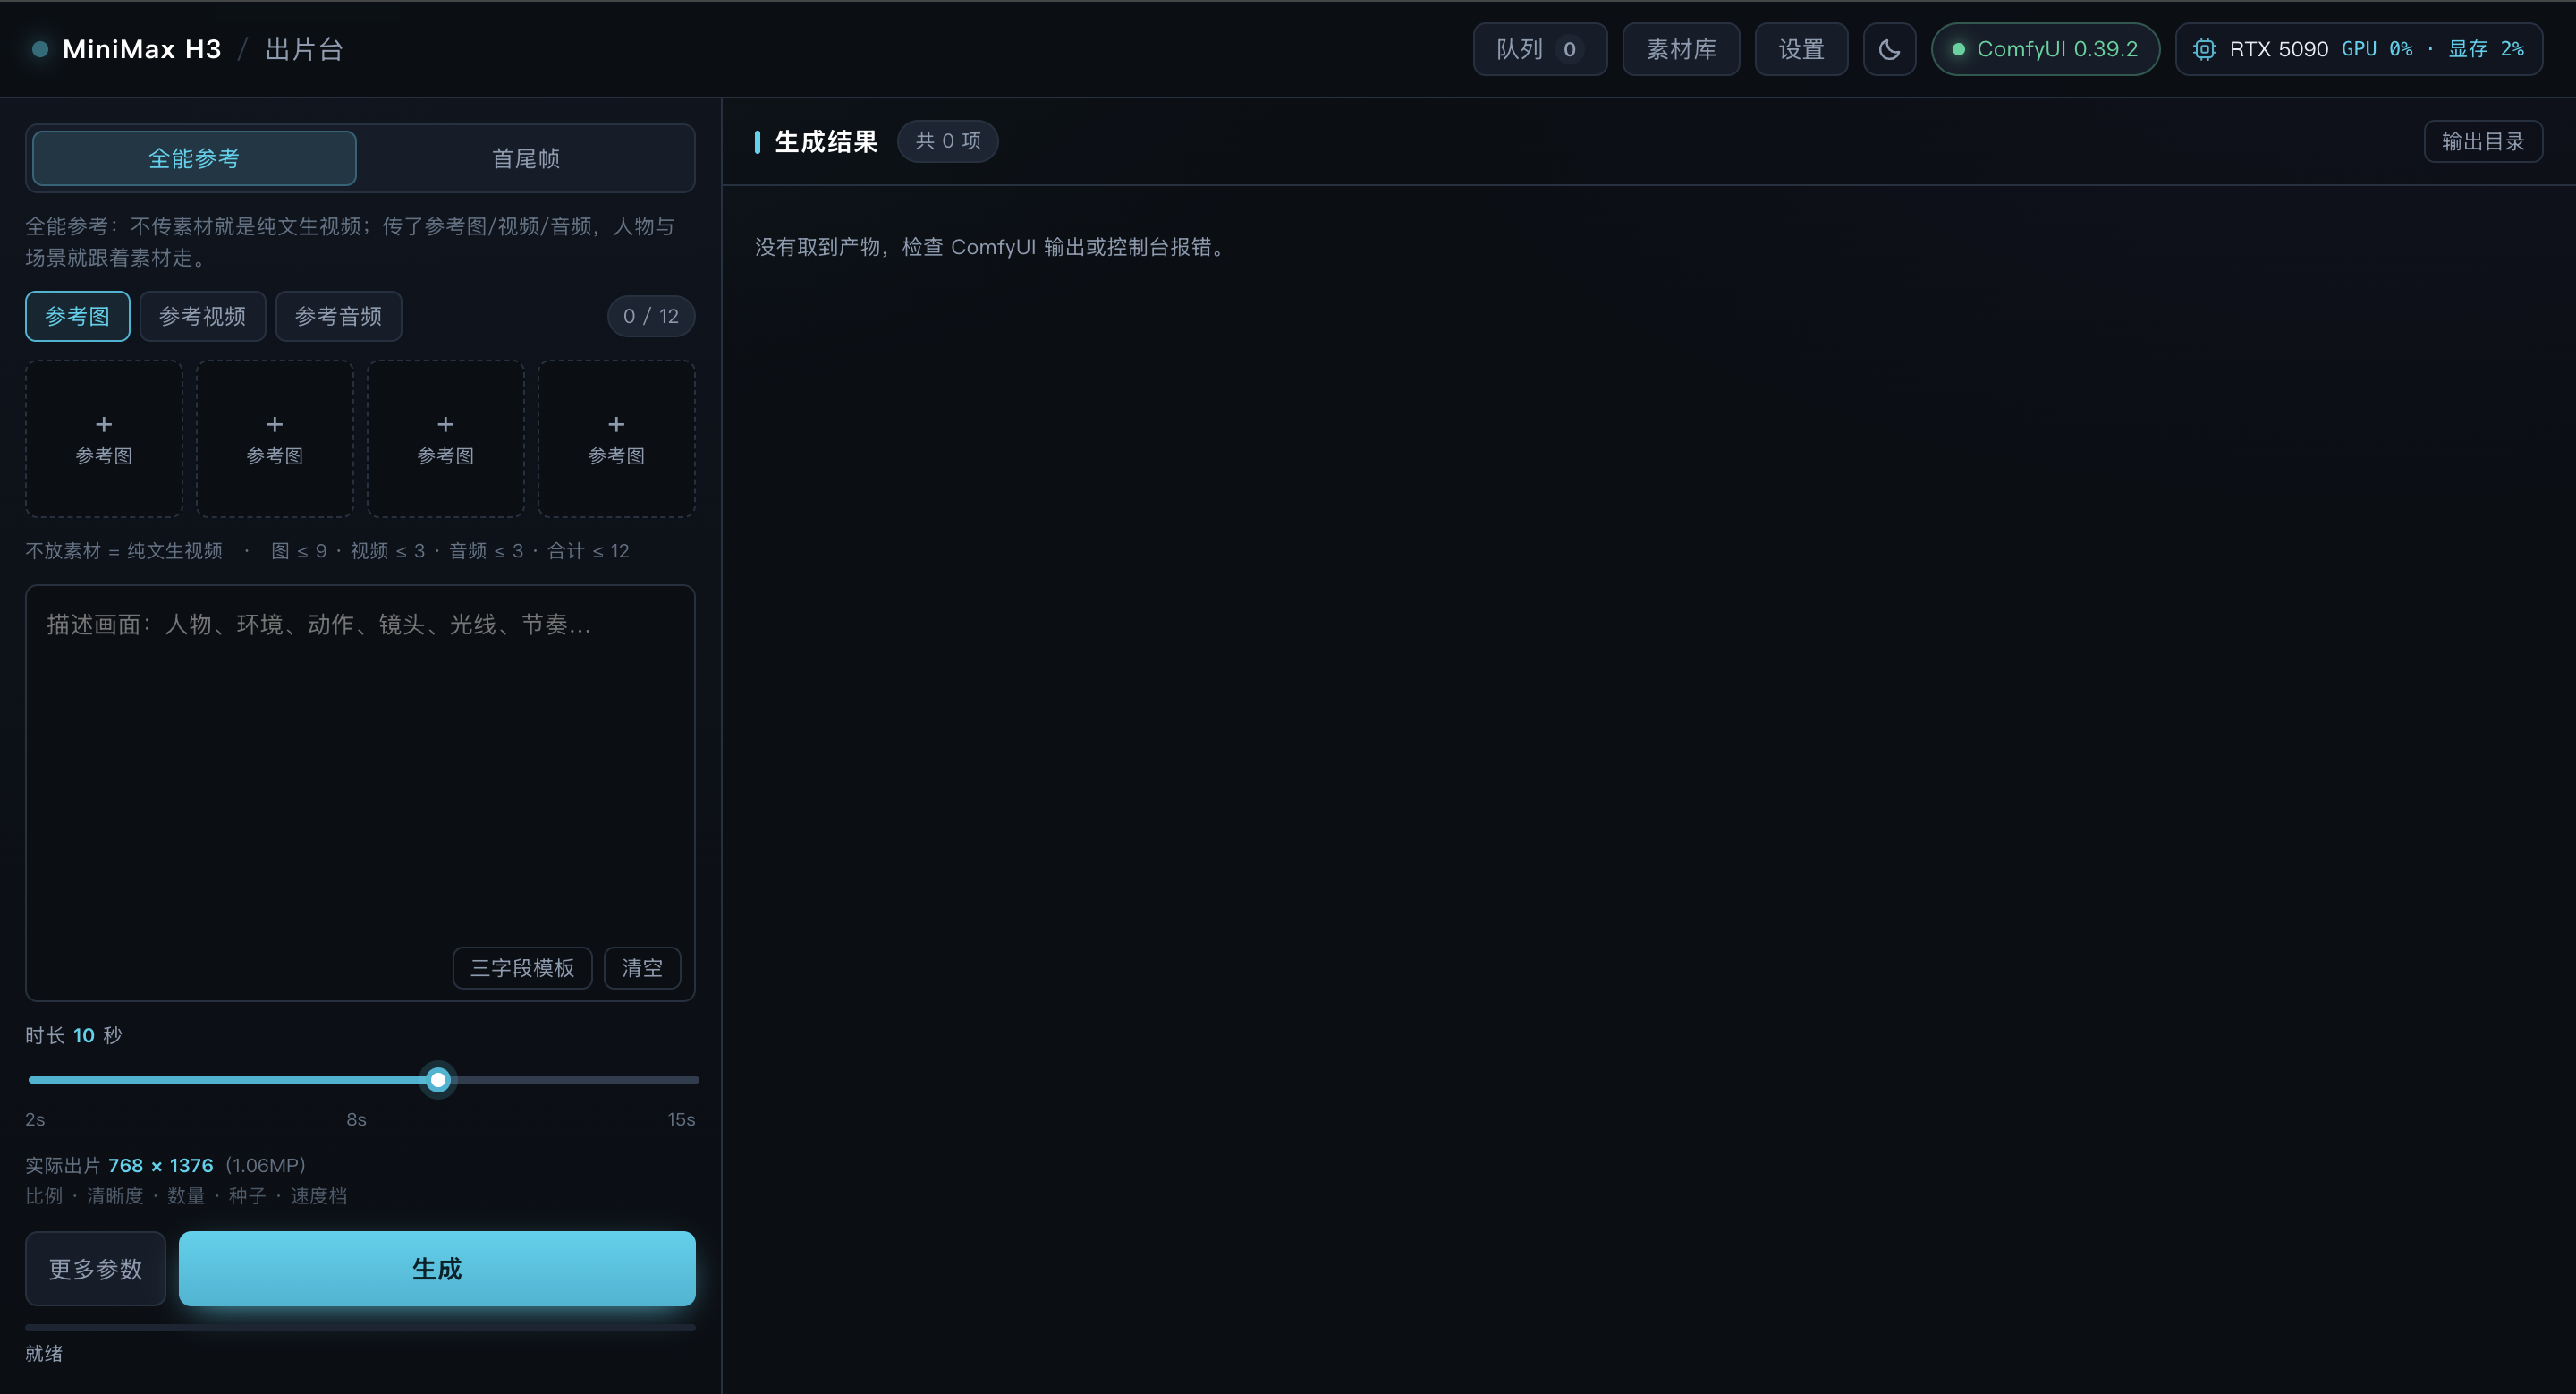
服务已配置开机自启,重启实例不需要手动敲任何命令。
【常用参数参考】
分辨率必须是 32 的倍数,这是最容易踩的坑,填错了会直接报错。
· 720P 竖屏:768 × 1376 · 1080P 竖屏:1088 × 1920 · 720P 横屏:1376 × 768
时长与步数:
· 单条建议 5~10 秒,最稳 · 要做 12 秒以上的长镜头,必须用 20 步;用 8 步 turbo 档跑长视频,模型会无视参考图自由发挥,开头就崩 · 出片耗时参考:720P / 10 步约 1 分钟一条,1080P 约 2~3 分钟一条(实际取决于显卡型号)
提示词写法:H3 对结构化描述响应更好,建议按「画面主体 → 动作 → 镜头运动 → 光线 → 场景细节 → 画质词」的顺序写。 要素清单只写一遍,不要在提示词里反复重复同一段描述。
【端口说明】
· 7860:门面服务,对外访问建议走这个 · 8188:ComfyUI 原生界面,调试和改工作流用这个
【常见问题】
Q:开机后网页打不开? A:先等 3 分钟。如果还是不行,检查实例是否在运行、端口是否放行。首次启动要加载十几 G 的模型权重,慢是正常的。
Q:生成失败或者画面完全不对? A:大概率是分辨率的宽高不是 32 的倍数,或者长视频用了低步数。先把分辨率改成上面的数值,把步数提到 20 再试。
Q:参考图起了作用,但人物长相还是飘? A:R2V 模式下要明确告诉模型「保持哪张图里的人物」,提示词里写清参考图的角色定位,不要让模型自己猜。
Q:能文生视频直接输出产品画面吗? A:不能。产品的具体外观、包装、文字必须走参考图(R2V / I2V),纯文生视频写不出准确的产品。
【版本】
v16 · 2026 年 10 月