烛龙Qwen-Image-2.1
Qwen Image 2.1 高性能 AI 绘图镜像,基于 LightX2V 深度优化,RTX 5090 热请求约 6 秒,支持文生图、图生图、文字编辑、一键比例及 Web/API,开箱即用。
运行环境
Qwen Image 2.1 LightX2V 镜像使用文档
适用镜像:
qwen-image-2.1-lightx2v-fp8-f16-accum-v1本文描述的是已经验证过的 LightX2V + 自建 Gradio/FastAPI 网关,不是 ComfyUI 镜像。
先看速度和运行环境
当前版本在 RTX 5090 32GB 上完成验证。模型加载完成后的热请求参考速度如下:
在模型已经加载完成的情况下,1024×1024 单张图片的参考耗时如下:
- API 文生图:约 6.6 秒。
- 网页文生图:约 7~8 秒。
- 网页图生图:约 8~10 秒,具体取决于参考图和网络。
刚启动实例时,模型需要加载到显卡,还要初始化 CUDA(显卡加速环境)。第一次生成可能等待几十秒到数分钟,这属于启动和预热时间,不是每张图片的正常生成时间。
这个镜像已经包含 Qwen Image 2.1、LightX2V、PyTorch、CUDA 用户态库、网页和 API 网关。使用镜像时不需要再次安装 ComfyUI、CUDA 或模型。
拿到镜像后先做这些
下面的命令默认通过 SSH 登录实例后执行。平台提供的镜像通常使用 root 用户;如果当前不是 root,先执行:
sudo -i
1. 只开放一个公网端口
创建实例或配置端口映射时,只把容器端口 8000 对外开放:
只开放以下公网入口:
8000:网页和 API,必须开放到公网。
以下端口只供实例内部使用,不要映射到公网:
8001:LightX2V 内部推理服务。8002:内部指标服务。
平台通常会生成类似下面的访问地址:
https://8000-你的实例ID.pod.compshare.cn/
2. 运行服务
新实例启动后,Supervisor(服务管理器)通常会自动启动两个程序。先查看状态:
qwen21-status
如果状态不是 RUNNING,手动启动:
supervisorctl start lightx2v-backend
supervisorctl start lightx2v-web
然后再次检查:
qwen21-status
curl http://127.0.0.1:8000/health
看到下面类似结果,说明网页网关和内部后端都已经准备好:
{"status":"ok","backend":{"status":"ok"}}
模型第一次加载需要时间。启动后如果暂时显示 degraded,先等待一会儿,再重新执行健康检查。
3. 查看网页用户名、网页密码和 API 密钥
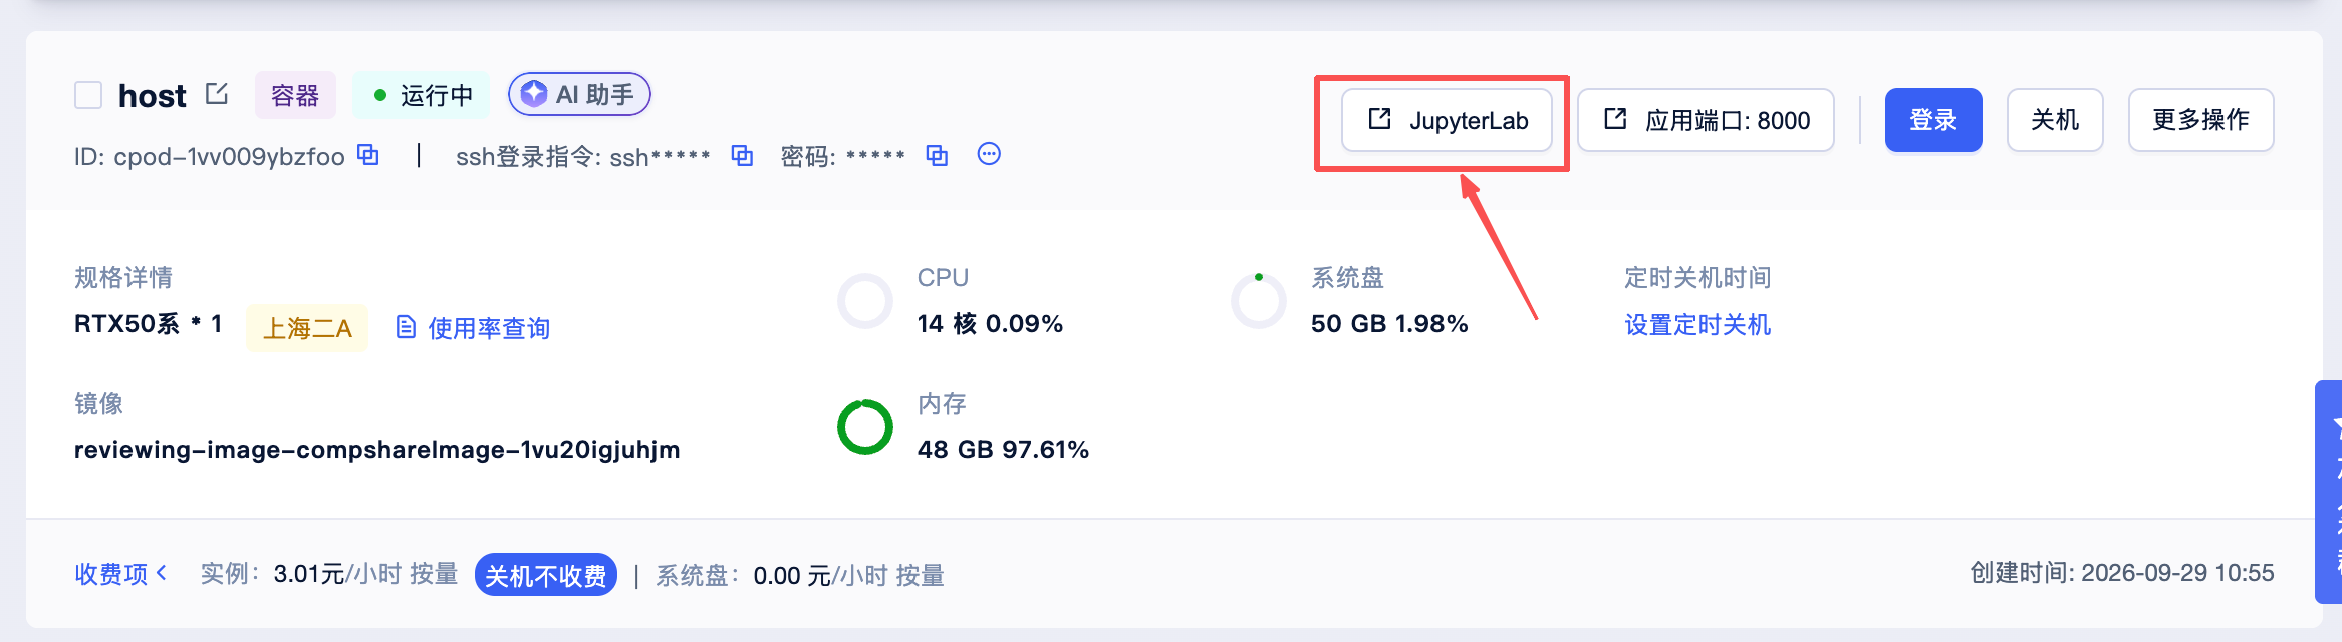
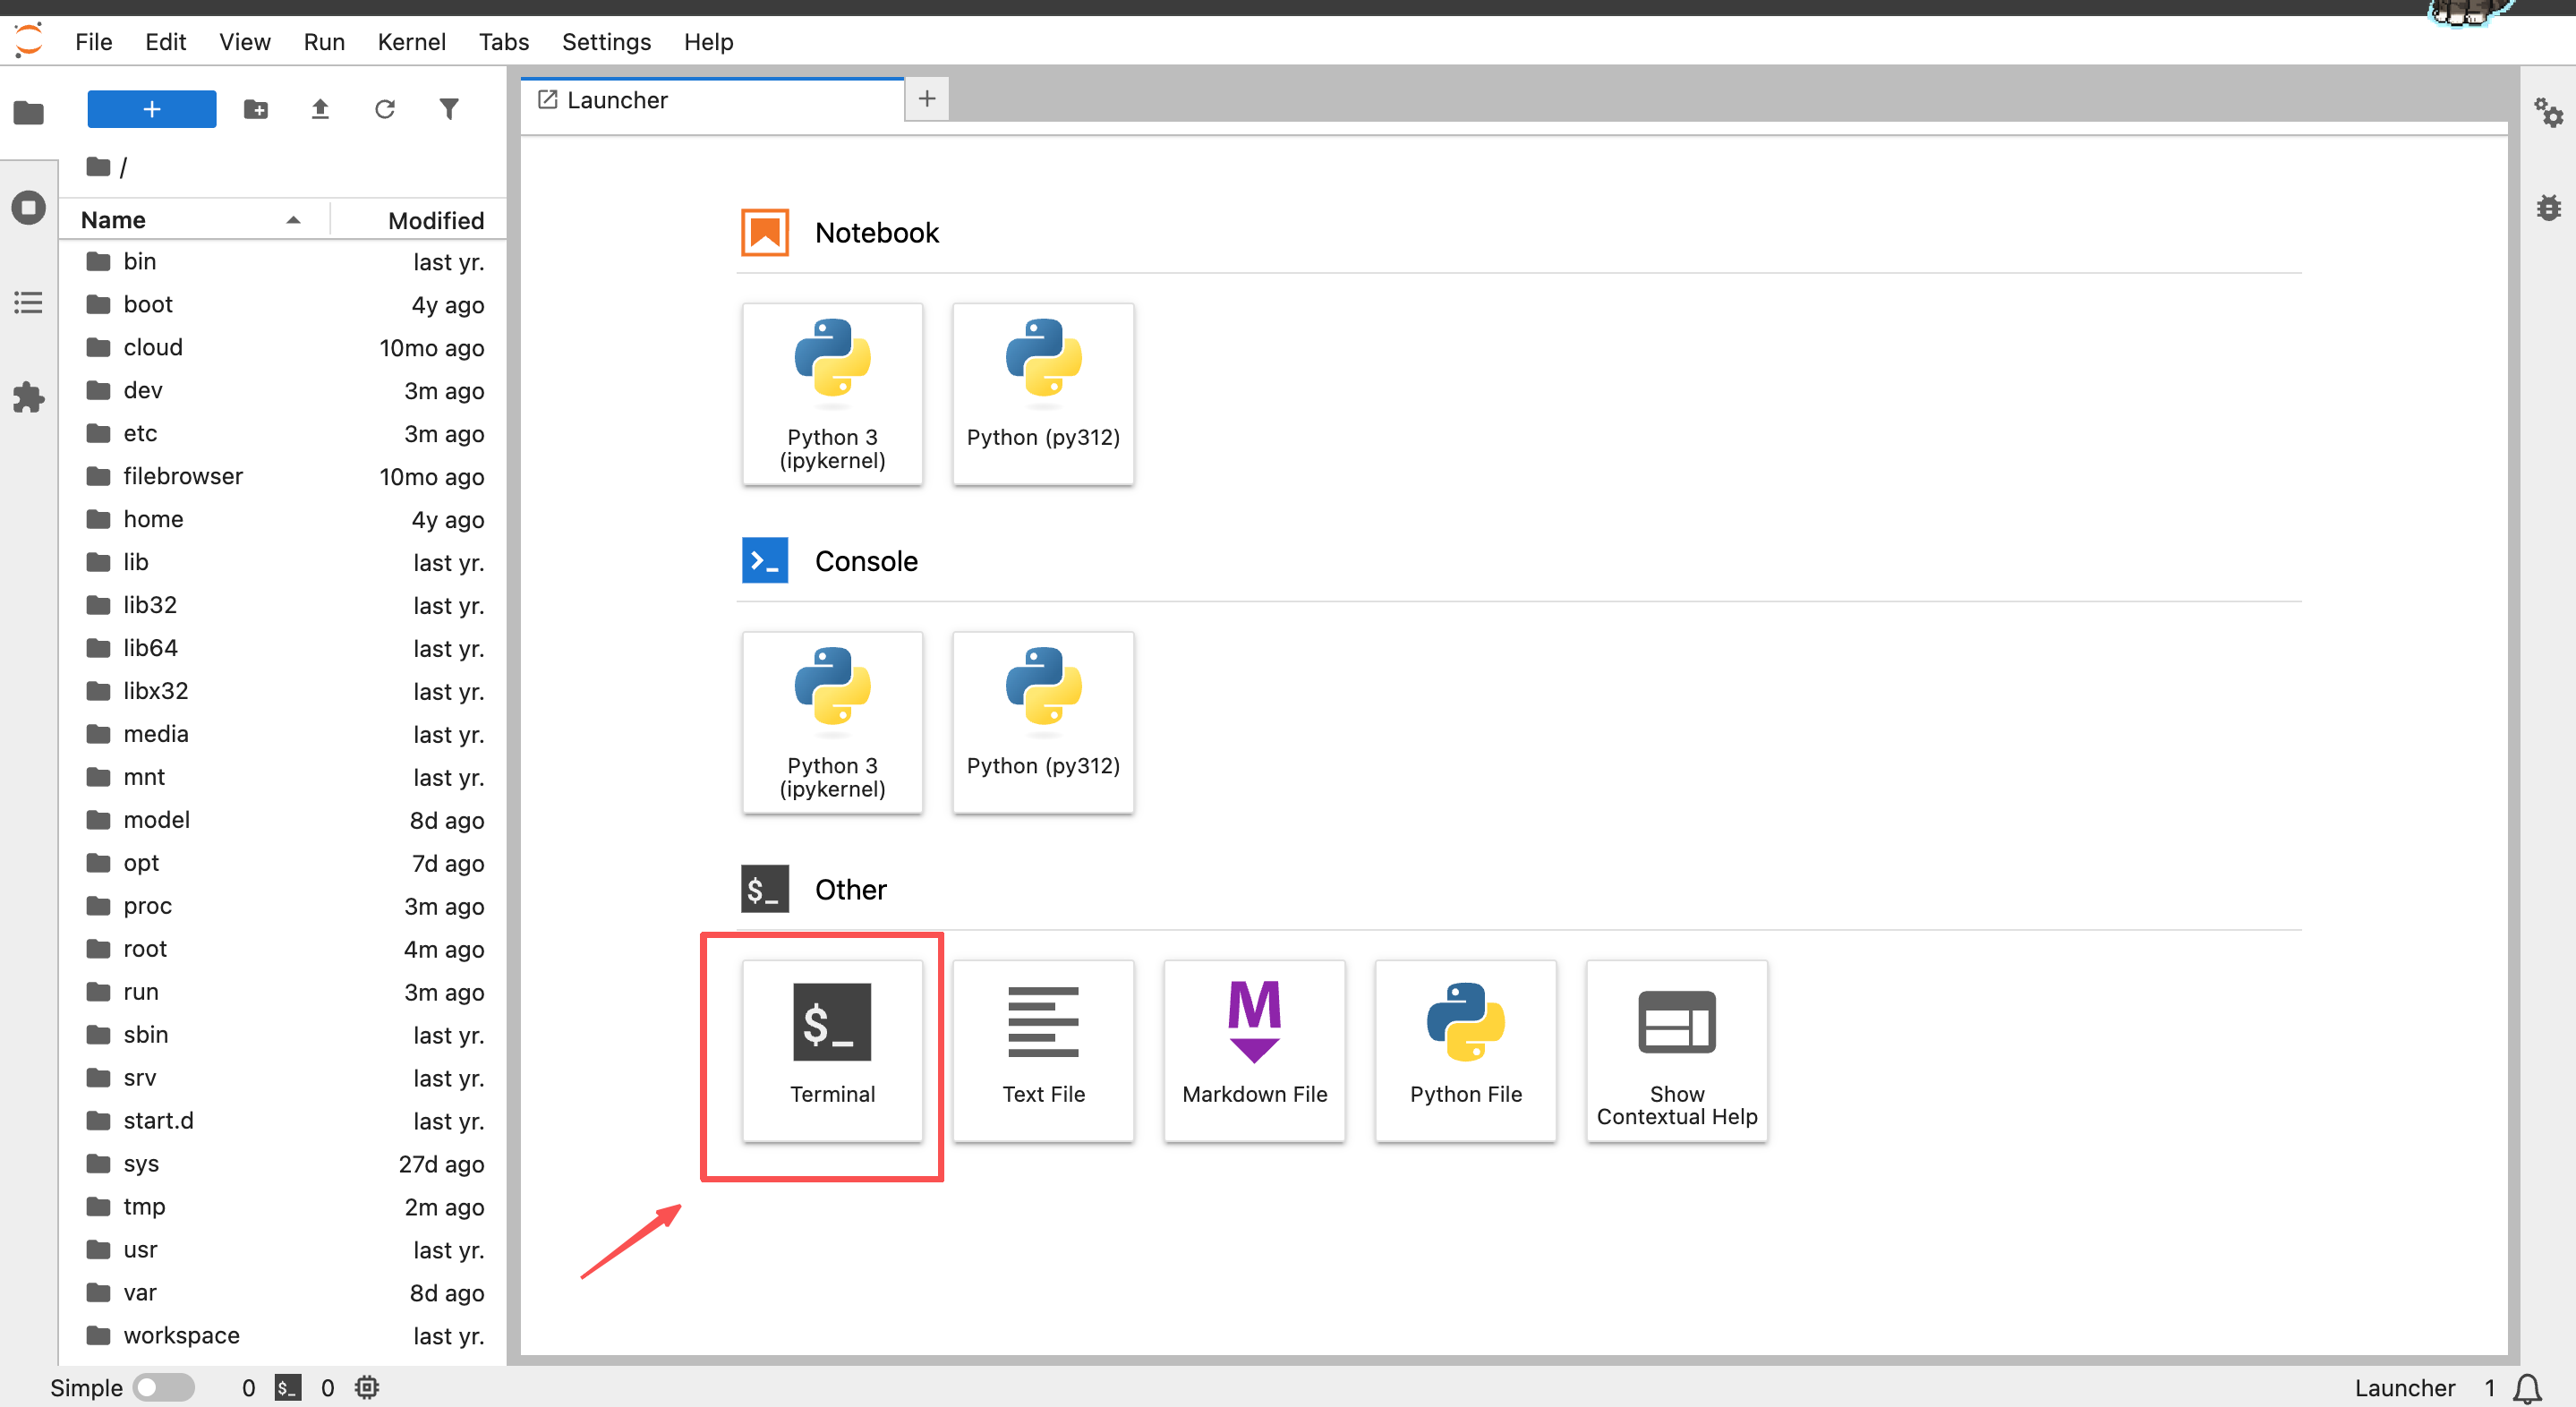
输入命令行
qwen21-credentials
命令会显示当前实例的网页用户名、网页密码和 API 密钥。
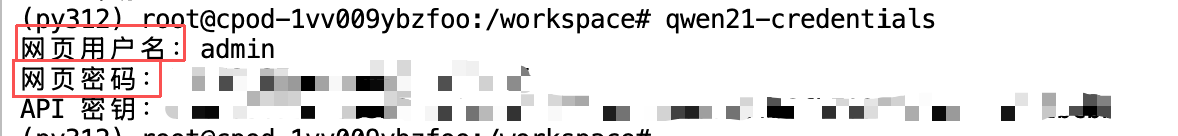
打开公网地址
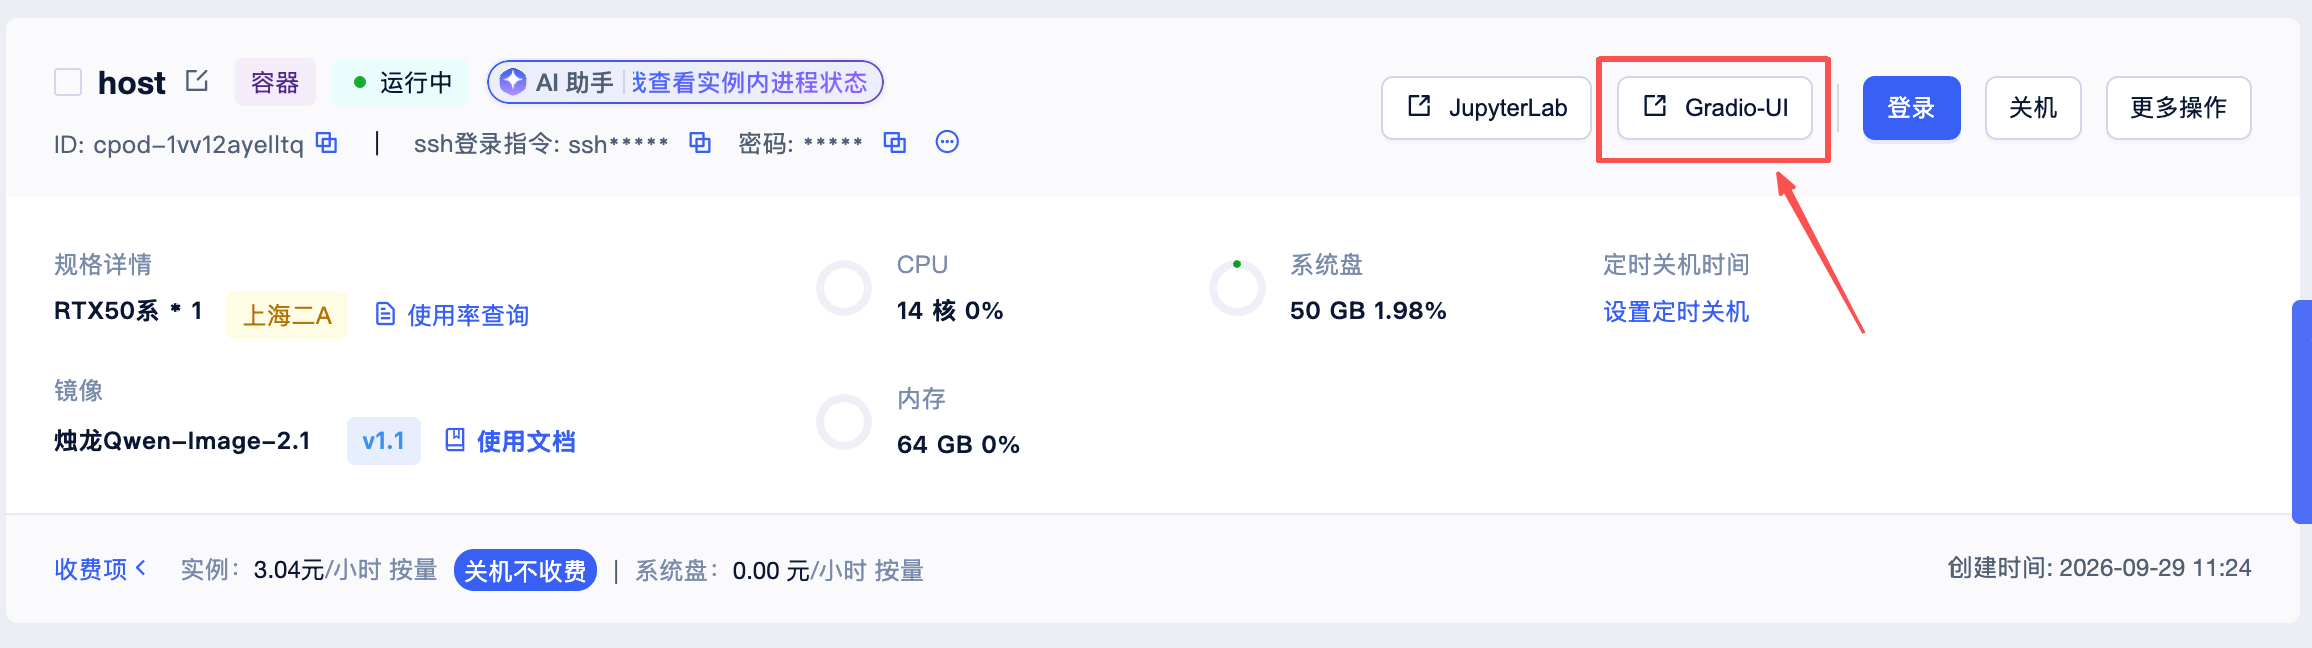
在登录页填写网页用户名和网页密码。
API 密钥只用于程序调用,不要把它当成网页密码,也不要发到公共群聊或写入公开网页代码。
4. 只重置 API 密钥
如果 API 密钥泄露,或者你想换一把新的 API 密钥,执行:
qwen21-reset-api-key
qwen21-credentials
这个命令只会更换 API 密钥,网页用户名和网页密码保持不变。旧 API 密钥会立即失效,正在使用旧密钥的程序需要改成新密钥。
如果镜像里没有这个命令,也可以使用兼容命令:
qwen21-rotate-credentials
兼容命令会同时更换 API 密钥和网页密码。
5. 重置网页用户名和密码
只重置密码、保留当前用户名:
qwen21-reset-web-login
同时换成新的用户名,例如 newadmin:
qwen21-reset-web-login newadmin
执行完成后,再运行下面的命令查看新登录信息:
qwen21-credentials
网页服务会自动重启,LightX2V 模型后端不会重启,已经加载到显存的模型也不会因为修改网页登录信息而重新加载。
6. 重启服务
修改网页代码、环境变量、模型配置,或者遇到服务异常时,使用:
qwen21-restart
这个命令会依次重启 LightX2V 后端和网页/API 网关。重启后模型需要重新加载,先执行 qwen21-status,确认两个服务都为 RUNNING,并且 /health 返回后端 ok,再开始生成图片。
7. 查看日志
实时查看四个服务日志:
qwen21-logs
默认显示最近 100 行并持续跟踪。想先显示最近 200 行:
qwen21-logs 200
按 Ctrl+C 退出日志查看,不会停止服务。只看错误日志可以执行:
tail -n 100 /opt/qwen21/logs/lightx2v-server-error.log
tail -n 100 /opt/qwen21/logs/lightx2v-web-error.log
一、镜像提供什么
镜像启动后会提供:
- 一个带登录保护的网页,用于文生图和上传参考图进行图生图;
POST /v1/generate,项目自定义的文生图接口;POST /v1/images/generations,兼容 OpenAI 图片接口格式的文生图接口;GET /health,服务健康检查;GET /docs,FastAPI 接口文档。
当前架构如下:
公网 HTTPS:8000
        │
        ▼
Gradio/FastAPI 网关(网页、鉴权、Base64 响应)
        │ 127.0.0.1:8001
        ▼
LightX2V 推理服务(RTX 5090、FP8 DiT + FP16 累加)
        │
        └─ 127.0.0.1:8002 指标端口,仅本机可见
模型和 LightX2V 后端已经随镜像保存,正常启动和调用不需要重新下载模型。
二、推荐实例配置
当前在以下环境完成验证:
当前已经验证过的环境和建议如下:
- GPU:NVIDIA RTX 5090,约 32GB 显存。建议优先使用 32GB 显存;更小显存需要单独调整配置。
- 系统:Ubuntu 22.04.5。建议使用平台提供的 GPU 基础镜像。
- Python:3.12。请保持镜像内的 Python 环境,不要自行更换版本。
- PyTorch:
2.13.0+cu132。不要在启动时重新安装或升级 PyTorch。 - 驱动:NVIDIA 610.57.04。驱动由平台或宿主机提供。
- 内存:目标实例建议 48GB 以上。参考图和高分辨率编辑会增加内存占用。
- 磁盘:推荐 60~80GB 以上。
创建实例时只需要对外映射容器端口 8000。不需要安装 Docker,也不需要额外启动 ComfyUI;镜像内的 Supervisor 会自动管理两个服务。
当前平台的访问地址通常类似:
https://8000-你的实例ID.pod.compshare.cn/
平台会将 HTTP 入口代理为 HTTPS,建议直接使用 HTTPS 地址。
三、首次启动与登录
模型加载和预热完成前,网页可能暂时无法生成图片。首次启动通常比热请求慢,先通过 SSH 查看状态:
qwen21-status
获取当前实例的网页账号和 API 密钥:
qwen21-credentials
输出格式类似:
网页用户名:admin
网页密码:此处显示当前实例密码
API 密钥:此处显示当前实例密钥
每个新实例第一次启动时,如果 /etc/qwen21/qwen.env 中的密钥为空,入口脚本会自动生成一组新的凭据。不要把实际密码、API 密钥或 SSH 密码写入文档、仓库、截图或前端代码。
网页地址:
https://8000-你的实例ID.pod.compshare.cn/
接口文档:
https://8000-你的实例ID.pod.compshare.cn/docs
四、网页使用
网页支持:
- 输入提示词后生成图片;
- 上传一张参考图后进入图生图;
- 调整宽度、高度和 Seed;
- 在页面查看生成结果和耗时。
当前 LightX2V Qwen Image 2.1 配置固定使用 40 步。页面中的“反向提示词”输入框保留作兼容提示,但当前 Qwen 2.1 LightX2V 链路不会使用反向提示词;主要内容请写入正向提示词。
当前页面是轻量的生成控制台,不是无限图像画布,也不提供图层时间线。如果需要节点工作流,建议另行部署 ComfyUI;如果需要真正的图层式无限画布,应单独评估 InvokeAI 或 Krita + ComfyUI,并先验证 Qwen Image 2.1 的完整兼容性。
五、API 调用
5.1 鉴权
接口请求必须携带以下任一请求头:
X-API-Key: 你的API密钥
或者:
Authorization: Bearer 你的API密钥
健康检查 /health 不要求 API 密钥;实际生成接口必须鉴权。
5.2 自定义接口:POST /v1/generate
curl -X POST "https://8000-你的实例ID.pod.compshare.cn/v1/generate" \
  -H "Content-Type: application/json" \
  -H "X-API-Key: 你的API密钥" \
  -d '{
    "prompt": "一只戴红围巾的小猫坐在雨夜的窗边,电影级灯光,细节丰富",
    "width": 1024,
    "height": 1024,
    "seed": 42
  }'
参数说明如下:
prompt:字符串,必填,用于填写正向提示词。negative_prompt:字符串,默认为空。该字段为兼容旧调用保留,当前链路不生效。width:整数,默认1024。范围为256~2048,服务端会向下对齐到 32 的倍数。height:整数,默认1024。范围为256~2048,服务端会向下对齐到 32 的倍数。seed:整数,默认随机。传入非负整数可以复现相近结果;省略或传负数时使用随机种子。
当前接口不接受 steps 和 cfg_scale 参数;步数、采样和 LightX2V 优化项由服务端配置固定。
5.3 OpenAI 风格接口:POST /v1/images/generations
curl -X POST "https://8000-你的实例ID.pod.compshare.cn/v1/images/generations" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer 你的API密钥" \
  -d '{
    "model": "qwen-image-2.1",
    "prompt": "一座漂浮在云海上的东方城市,复杂建筑,日落,超高细节",
    "size": "1024x1024",
    "response_format": "b64_json",
    "seed": 42
  }'
当前支持的字段如下:
prompt:必填,正向提示词。model:可选,仅作兼容字段,不影响已经部署的模型。n:只能设置为1,每个请求生成一张图片。size:例如1024x1024。宽高范围为256~2048,并按 32 对齐。response_format:当前只能设置为b64_json。seed:可选,传入非负整数可以复现相近结果。negative_prompt:可选,但当前链路不生效。
成功响应示例:
{
  "created": 1780000000,
  "data": [
    {"b64_json": "iVBORw0KGgoAAA..."}
  ],
  "output_format": "png",
  "size": "1024x1024",
  "seed": 42,
  "elapsed_seconds": 6.58
}
响应图片以 Base64 返回。网关不会把每次生成结果自动保存到 VPS,也不会返回 /outputs/文件名.png 这种永久链接。调用方需要自行解码并保存到本地、对象存储或业务数据库。
当前公网网关没有单独暴露 /v1/edit;网页上传参考图时,会由网关调用内部 LightX2V 图像编辑接口完成图生图。
六、图片和磁盘
正常网页/API 生成流程是:
请求 → LightX2V 推理 → 网关内存中的 PNG/Base64 → 返回客户端
因此,普通生成不会把图片长期写入 VPS 的输出目录。网页框架处理上传和结果时,可能会在 /tmp/gradio 产生临时文件;这些文件不是长期图库,可以在维护或制作镜像前清理。/opt/qwen21/outputs 目录可能保留制作镜像前的历史文件或人工测试文件,但当前 LightX2V 网关不会按请求把结果写在那里。
如果需要长期保存图片,建议调用方直接将 Base64 解码后写入自己的存储。制作镜像前执行的 qwen21-prepare-image 会删除 /opt/qwen21/outputs 下的 PNG 测试产物,但不会删除模型权重。
七、常用管理命令
qwen21-status                 # 服务、两个健康检查、GPU 和磁盘
qwen21-credentials            # 当前实例的网页凭据和 API 密钥
qwen21-reset-api-key          # 只重置 API 密钥
qwen21-reset-web-login        # 重置网页密码,可附带新用户名
qwen21-restart                # 重启 LightX2V 后端,再重启网页网关
qwen21-logs                   # 查看并持续跟踪四个服务日志
qwen21-logs 200               # 先显示最近 200 行,再持续跟踪
supervisorctl status lightx2v-backend lightx2v-web
服务与端口说明如下:
- 网页/API 网关:监听
0.0.0.0:8000,用于浏览器访问、健康检查和公开 API;只映射这个端口到公网。 - LightX2V 后端:监听
127.0.0.1:8001,供网页/API 网关在本机内部调用,不要对公网开放。 - 指标服务:监听
127.0.0.1:8002,供本机监控使用,不要对公网开放。
不要把 8001 或 8002 映射到公网,也不要在同一张 GPU 上启动第二个推理进程或多个 Uvicorn worker。
八、性能说明
在当前 RTX 5090 实例上,重启服务后使用复杂的 1024×1024 文生图请求完成热请求测试:
- LightX2V 后端:约 6.58 秒,这是服务端返回的推理耗时。
- 公网网关:约 7.87 秒,包含网关处理、PNG 处理和平台网络开销。
第一次启动或重启后的第一张图还包含模型加载、CUDA 内核初始化和预热时间,不能与热请求直接比较。LightX2V 官方 RTX 5090 参考值约为文生图 5.93 秒,但官方基准和本实例的网络、磁盘、驱动、模型缓存条件不同,实际以本机测试为准。
当前优化链路是 DiT 的 FP8 权重加 FP16 累加;文本编码器和 VAE 没有全部改成 FP8。相比完整 BF16/FP16 权重,它节省显存并提高速度;理论上会有数值差异,但在本次验证中服务可以正常生成。若追求严格质量对比,应使用同一 Seed 对比原始 BF16 权重,并自行验收文字、细节和编辑一致性。
九、安全与运维建议
- 对外只开放平台映射的
8000;SSH 使用平台分配的管理端口。 - API 密钥视同服务密码,不要放入浏览器公开 JavaScript、Git 仓库或日志。
- 分享过 API 密钥、网页密码或 SSH 会话后,应在实例内重新生成凭据并重启网页服务;旧密钥不应继续使用。
- 公网部署建议在平台访问控制、反向代理或限流层之后使用,并限制请求体和上传图片大小。
- 不要让多个 GPU worker 同时加载同一模型;并发应通过队列和横向扩展控制。
- 定期检查:
df -h /
du -sh /opt/qwen21/models /opt/qwen21/outputs /opt/LightX2V
nvidia-smi
qwen21-status
十、故障排查
页面打不开或显示服务未就绪
确认平台映射的是容器端口 8000,然后执行:
supervisorctl status lightx2v-backend lightx2v-web
qwen21-logs 200
如果后端仍在加载模型,等待日志出现服务启动完成后再刷新页面。
/health 返回 degraded
网关进程已经启动,但它暂时连接不上 127.0.0.1:8001。常见原因是后端仍在加载模型或后端启动失败。查看:
curl http://127.0.0.1:8001/health
tail -n 100 /opt/qwen21/logs/lightx2v-server-error.log
API 返回 401
确认请求头是 X-API-Key 或 Authorization: Bearer,并重新执行:
qwen21-credentials
如果更换过实例凭据,旧 API 密钥会立即失效。
API 返回参数错误
检查宽度、高度是否在 256~2048 之间,且 size 使用类似 1024x1024 的格式。当前接口不支持用户传入 steps、cfg_scale 或 response_format=url。
显存不足或服务反复重启
先降低分辨率、减少参考图,再确认是否误启动了第二个推理进程:
nvidia-smi
supervisorctl status
不要把 8001 服务复制成多个 worker;如果需要并发,应使用多张 GPU 或多个实例。