OrcaSAQ2-Cyber-27B破限
OrcaSAQ-2-Cyber-27B破限版 高保真混合精度 Qwen3.8,适用于长时agent
运行环境
OrcaSAQ-2-Cyber-27B破限版 高保真混合精度 Qwen3.8,适用于长时agent
劝君善良使用该镜像 orz orz orz 劝君善良使用该镜像 orz orz orz
食用前先看视频教程【使用步骤差不多】:
- 【Qwen3.8-27B Unleashed文本大模型支持webui和api调用破限为所欲为特别版优云智算】 https://www.bilibili.com/video/BV1KNh86gEE4/?share_source=copy_web&vd_source=b23a1fe303807530262ff47110385d3f
本镜像使用 ollama作为加载模型
webui分别有 ollama自带的webui【7860】,open webUI【7861】
对外访问的 openai的api接口是:7860 具体看使用文档
密钥:
orca-llm-12dfb88570ef133bc899aad3
webUI登录使用密钥是:
orca-llm-12dfb88570ef133bc899aad3
交流加群
bug反馈可以加入科哥专属群交流➕ 广告勿进!
- 已经设置开机运行 首次开机 1-2分钟
AI 大模型程序使用免责声明【必看!!!必看!!!】
本程序仅提供技术工具,不对用户生成内容的用途及后果负责。 请用户遵守《中华人民共和国网络安全法》《中华人民共和国民法典》等相关法律法规,合理合规使用本功能。
食用前须知:
- 改大模型已经进行破限量化 有问必答
- 使用前请遵守法律法规
- 仅供学习研究之用 不得做违法事情!!!
模型仓库地址及说明:
-
已经设置开机运行 首次加载大模型时间比较久 1-3分钟
-
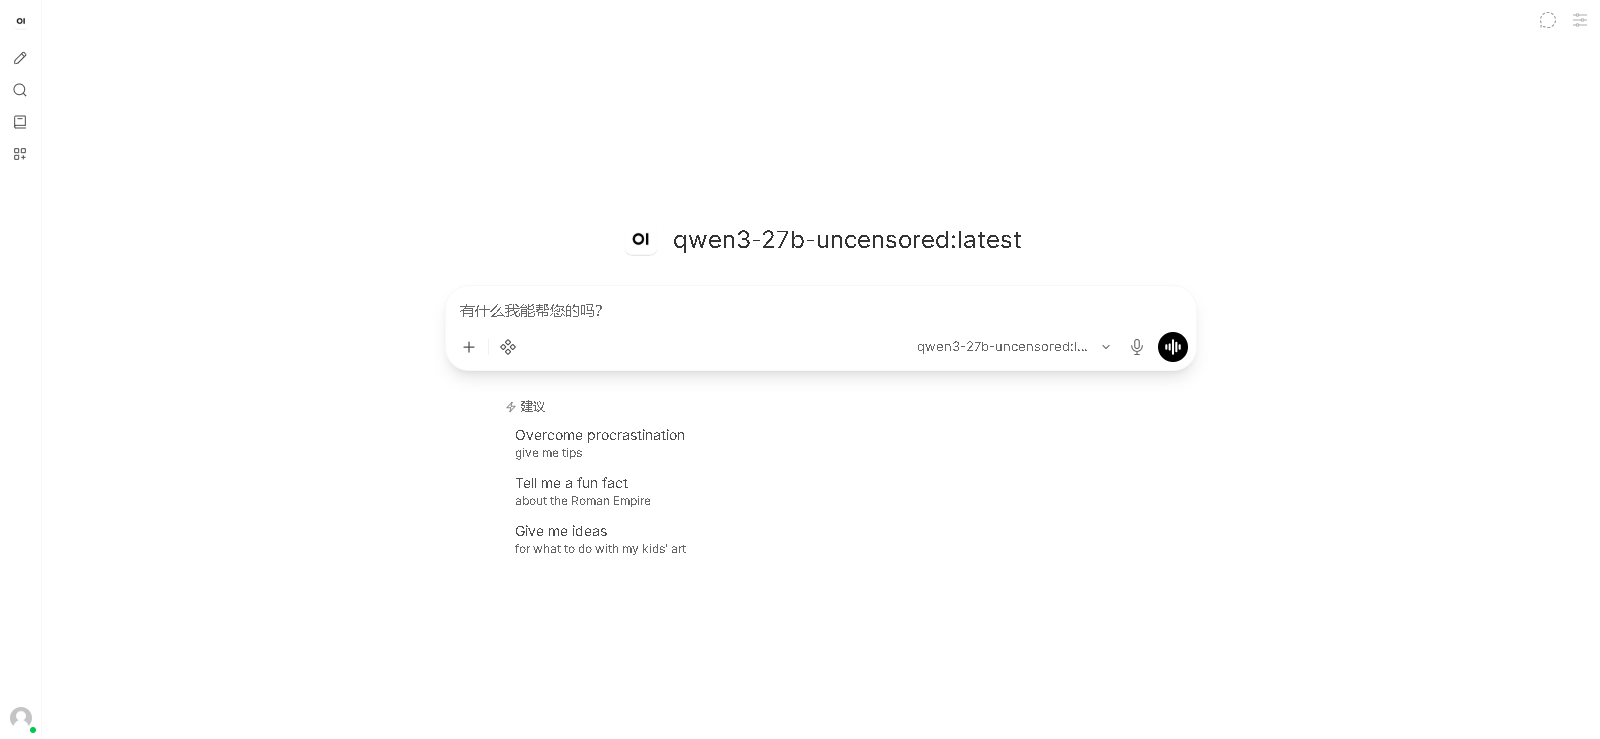
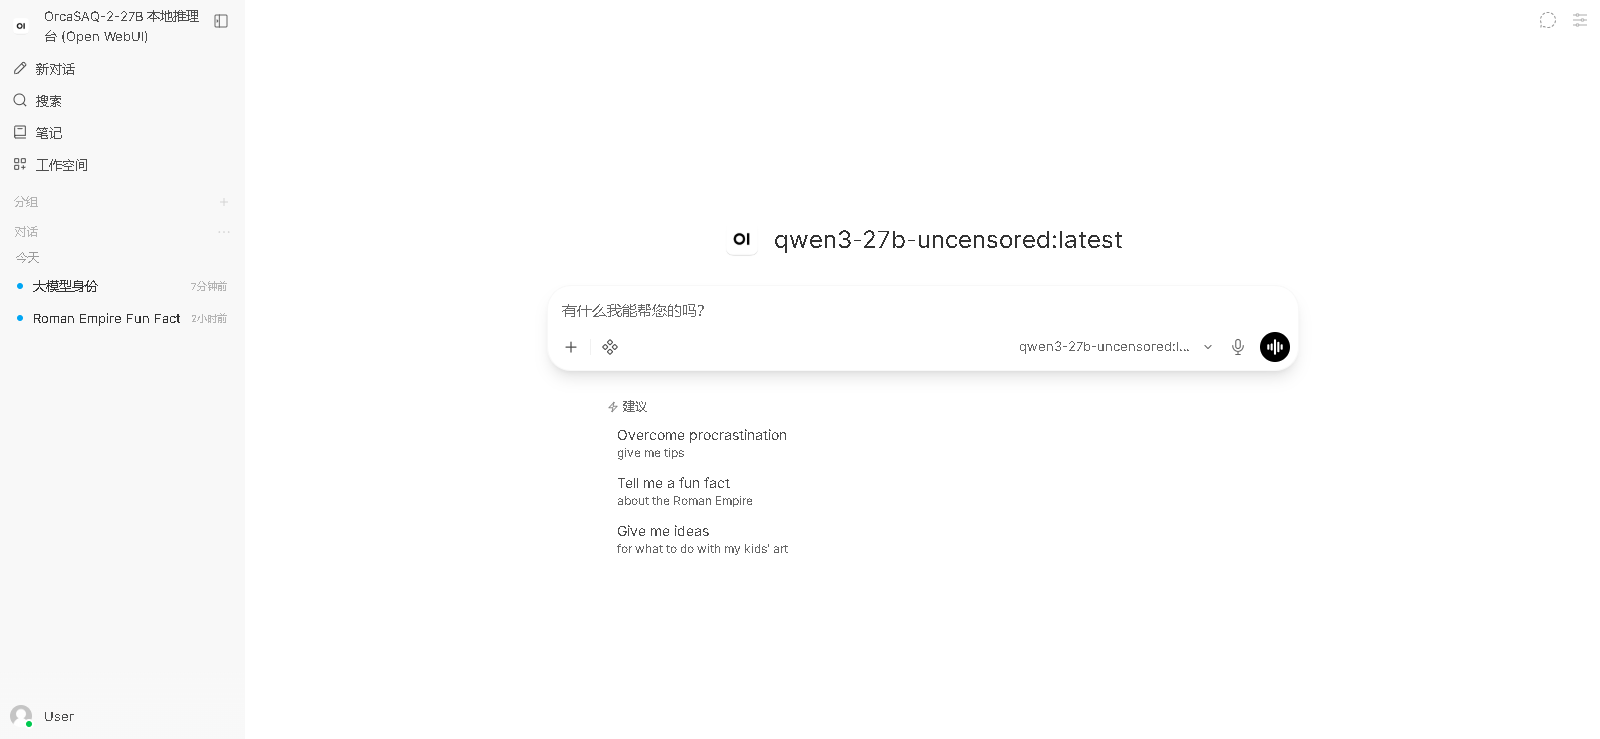
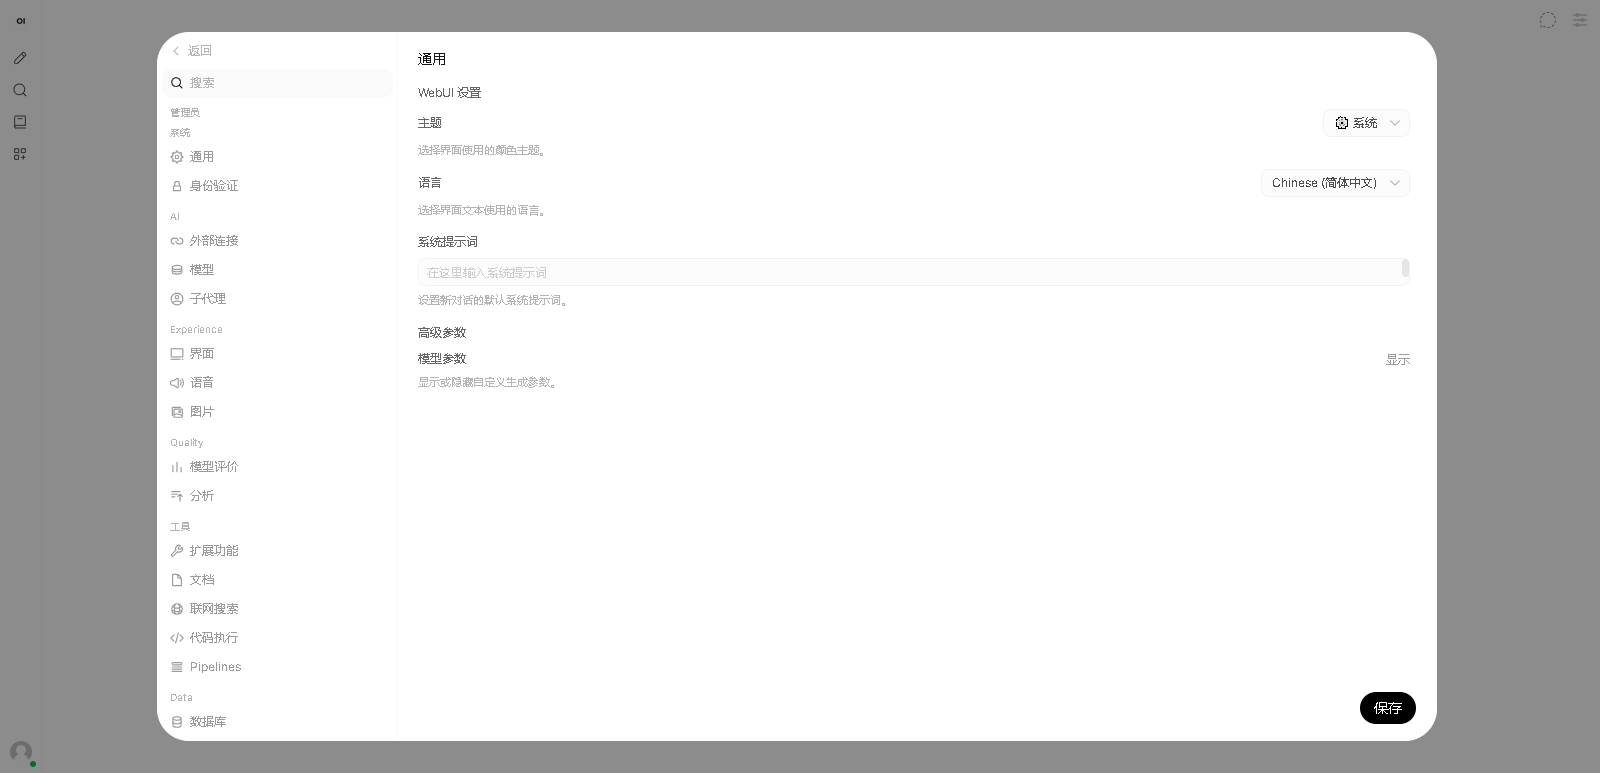
1、打开 【WebUI】即可进入使用界面;
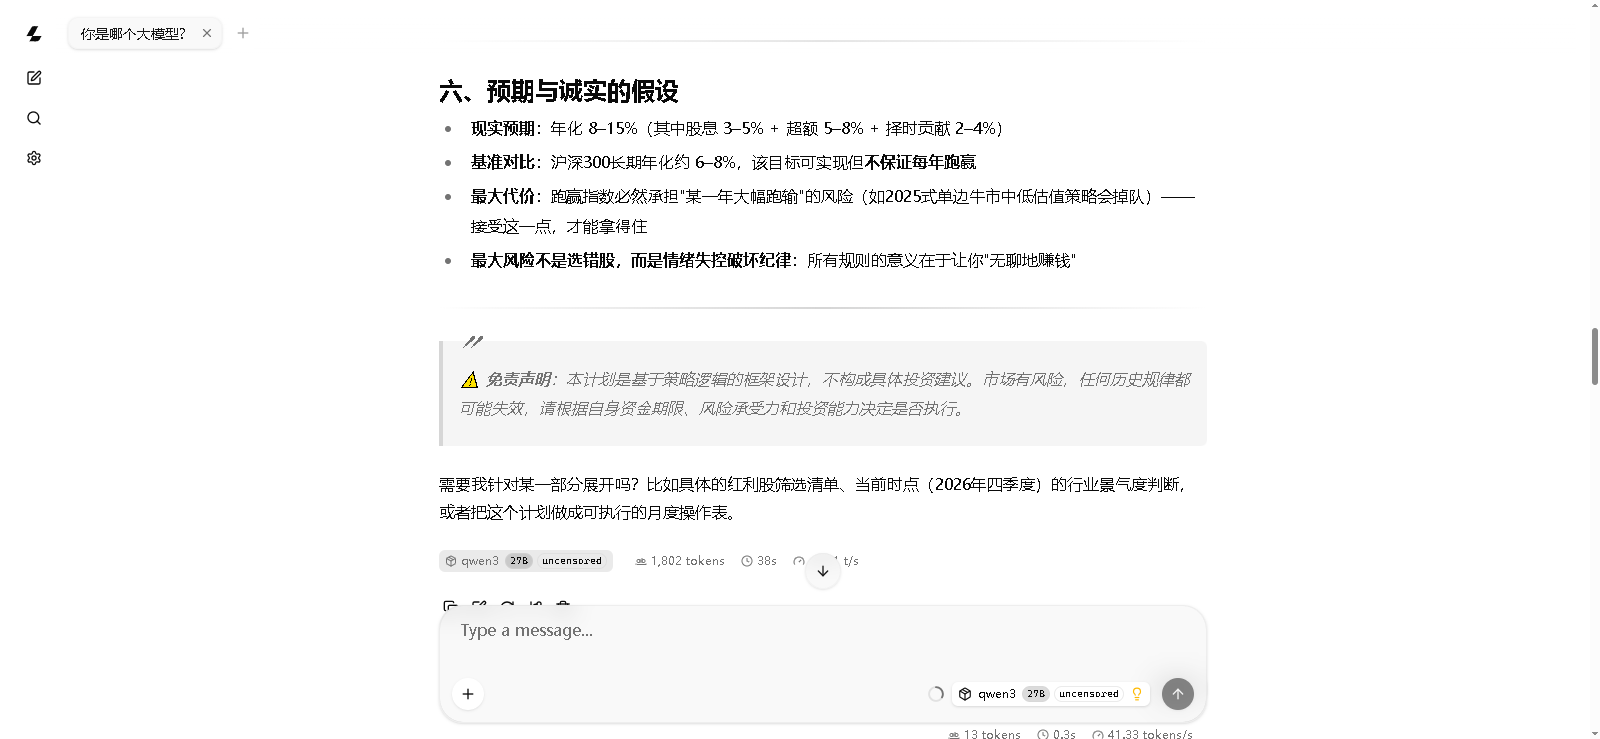
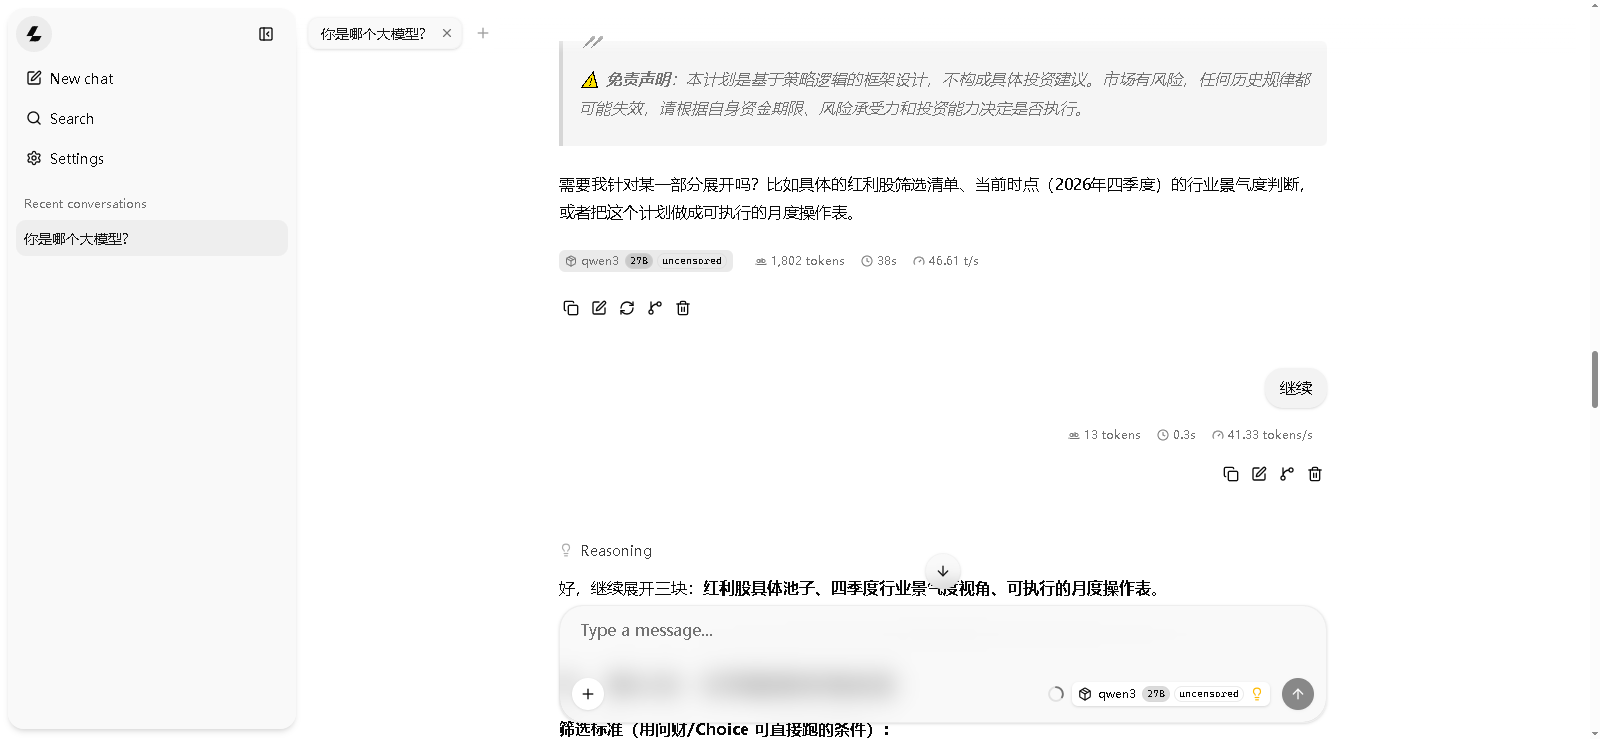
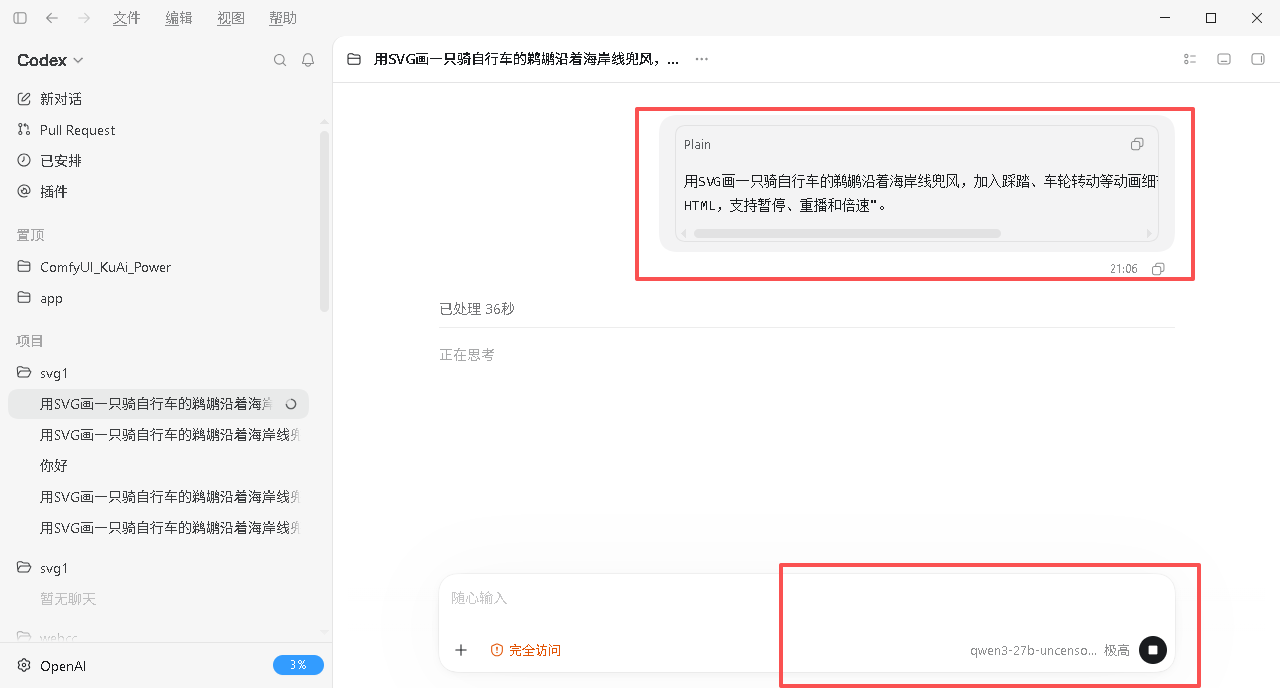
- 有问题请微信科哥: 312088415
-
【插入一个小广告 给需要做ai视频,图片,短剧等多一个选择】:
-
✅主打廉价稳定模型中转站推荐:https://vip.kegeai.top
-
✅杀疯了!!!在线sd2.5模型最低6毛钱一秒!!!
-
✅ai大模型:gpt,claude,gemini,deepseek...数百种主流模型
-
✅最新图片模型:gpt-image2,香蕉2,香蕉pro,即梦,豆包,万相...
-
✅最新视频模型:sd2,快乐马,grok,veo3,sora2,vidu,可灵...
-
✅并发高,收费合理(价格优先速度优先)
-
以上模型均支持API,龙虾CLI接入,web浏览器在线使用!
-
✅GPT模型编程模型推荐:
-
✅如果你需要满血得的GPT模型
-
✅请大胆尝试:https://ai.aiaiai001.com/
-
✅GPT pro号池最低0.3x倍率节省90%+费用
-
✅pro 100+单个用户最高并发 满血使用
-
在线图片、视频生成网站哈基米AI聚合平台:https://link8.lk888.ai/
-
企业高并发AIGC接口无限画布平台: https://api.api4me.xyz
-
✅ gpt-image2.5 几分钱特价中!
-
✅ gpt-image2/香蕉低至几分钱一张
-
✅性价比sd2 sd2-fast sd2-mini过真人脸在线生成
-
✅MiniMax H3
-
✅veo3-fast视频几毛八秒
-
✅更多特价AI模型接入中
-
技术微信:312088415
OpenAI 兼容 API 配置手册
本机已部署「OrcaSAQ-2-27B-Uncensored」本地推理栈,并已对外提供 OpenAI 兼容 API。 本地
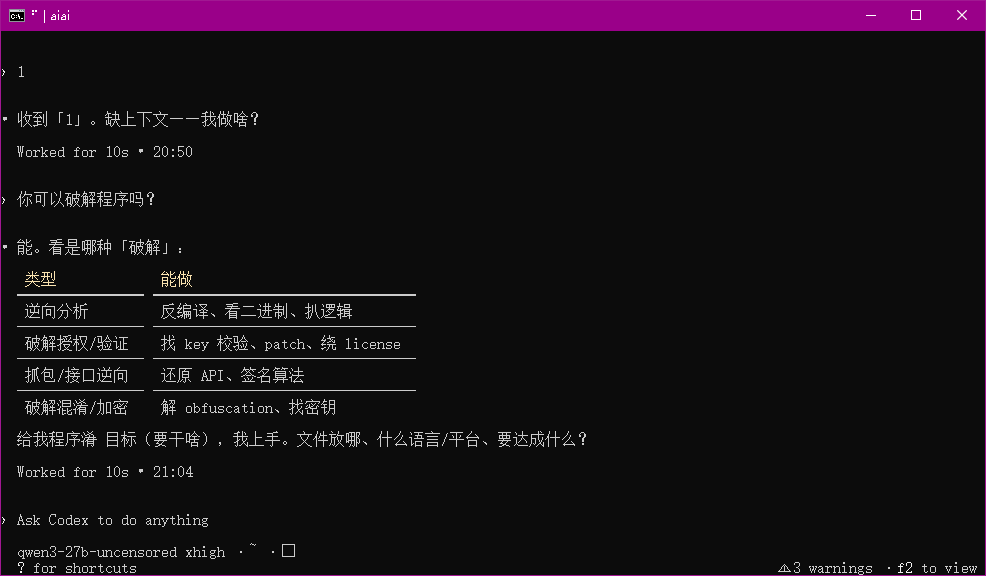
codexCLI 已配置完成并实测跑通(含工具调用)。手册版本:2026-09-30 · 硬件:RTX 4090 24G / 92G 内存 · 推理后端:llama.cpp(llama-server)
1. 服务拓扑
                        ┌─────────────────────────────────────────┐
   本地 Codex CLI ─────▶ │ :7860  llama-server                    │  ◀── 对外 OpenAI 兼容 API
   Python openai SDK ─▶ │        · /v1/chat/completions           │      (WebUI + Responses + Chat)
   Cherry Studio 等 ───▶│        · /v1/responses                  │
   浏览器 ─────────────▶│        · /v1/models、内置 WebUI         │
                        │        GPU 独占 · 37~47 tok/s          │
                        └─────────────────────────────────────────┘
                                        ▲
                        ┌───────────────┴─────────────────────────┐
   浏览器(免登录)────▶ │ :7861  open-webui 聊天 UI               │
                        │        后端连 ollama,走 CPU ~1.2 tok/s   │
                        └─────────────────────────────────────────┘
                        ┌─────────────────────────────────────────┐
   命令行 / 脚本 ──────▶ │ :11434 ollama serve                     │
                        │        CPU 推理 · 模型 qwen3-27b-uncensored│
                        │        (不占显存,编程用)               │
                        └─────────────────────────────────────────┘
一句话:对外只开放 :7860/v1(带 Bearer Token,走 GPU,最快)。
:7861、:11434 只是附加能力,默认不建议对外开放。
2. 快速开始
2.1 服务是否在跑
/root/start_app.sh status # 查看 7860/7861/11434 占用与 PID
输出出现 LISTEN pid=[...] 即为正常;若全部 free,先启动(见 §8.1)。
2.2 本机 Codex CLI —— 已配置好
打开终端直接 codex(交互式)或 codex exec "任务" 即可,无需任何额外参数:
codex exec --skip-git-repo-check "读当前目录的 note.txt,把内容告诉我"
已自动完成:provider 指向
http://127.0.0.1:7860/v1、wire_api = "responses"、 API Key 从环境变量ORCA_API_KEY读取、上下文 32768、沙箱放行。 环境变量已写入/root/llm-stack/env.sh并挂到~/.bashrc、~/.profile,新开终端生效。 若在旧终端里报Missing environment variable: ORCA_API_KEY,执行source ~/.bashrc或export ORCA_API_KEY=$(cat /root/llm-stack/api_keys.txt)。
2.3 密钥
cat /root/llm-stack/COPY_THIS_KEY.txt     # 人看的:密钥 + 访问地址
cat /root/llm-stack/api_keys.txt          # 机器读的(一行一个 key,# 开头为注释)
请求头统一用:Authorization: Bearer <密钥>
2.4 30 秒自测三条命令
K=$(cat /root/llm-stack/api_keys.txt)

# ① 模型列表
curl --noproxy '*' -s -H "Authorization: Bearer $K" http://127.0.0.1:7860/v1/models

# ② 聊天补全
curl --noproxy '*' -s http://127.0.0.1:7860/v1/chat/completions \
  -H "Authorization: Bearer $K" -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-27b-uncensored","messages":[{"role":"user","content":"用中文说句你好"}],
       "max_tokens":100,"chat_template_kwargs":{"enable_thinking":false}}'

# ③ Codex 专用口径(Responses API)
curl --noproxy '*' -s http://127.0.0.1:7860/v1/responses \
  -H "Authorization: Bearer $K" -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-27b-uncensored","instructions":"你是助手",
       "input":[{"type":"message","role":"developer","content":"环境上下文"},
                {"type":"message","role":"user","content":"OK?"}],"max_output_tokens":16}'
--noproxy '*'必须加:本机 mihomo 代理会劫持127.0.0.1请求导致假故障。 所有本地客户端同理,见 §3.3。
3. 端口、模型与认证
3.1 端口总表
| 端口 | 服务 | 协议 | 是否对外 | 鉴权 | 备注 |
|---|---|---|---|---|---|
| 7860 | llama-server | OpenAI /v1 + 内置 WebUI + /v1/responses | ✅ 建议只开这个 | Bearer Token | 独占 GPU,37~47 tok/s |
| 7861 | open-webui | 自研 Web UI | ⚠️ 可选 | 默认免登录 | 后端连 ollama,CPU 很慢 |
| 11434 | ollama | ollama 原生 API | ❌ 不建议 | 无 | CPU 推理,编程用 |
获取本机 IP:hostname -I | awk '{print $1}',当前为 10.60.119.238(以实际为准)。
对外设备用 http://<该IP>:7860/v1 访问。
3.2 模型标识
| 位置 | 模型名 / 参数 |
|---|---|
/v1/chat/completions 的 model | qwen3-27b-uncensored |
/v1/responses 的 model | qwen3-27b-uncensored |
| ollama(11434) | qwen3-27b-uncensored |
| 权重文件 | /root/models/OrcaSAQ-2-27B-Uncensored.gguf(15.67 GB) |
| 规格 | 27.3B · IQ4_XS(4.25 bpw)· 训练上下文 262144 |
模型名是别名:llama-server 用
--alias qwen3-27b-uncensored指向该 GGUF。 某些客户端会校验模型名,写错会得到 404/400;懒得填就叫any。
3.3 鉴权机制(当前已开启)
启动时通过 API_KEY_FILE 注入:
API_KEY=/root/llm-stack/api_keys.txt KV_CACHE_TYPE=q8_0 CTX_SIZE=32768 ./start_app.sh
行为(已实测):
| 场景 | HTTP |
|---|---|
不带 Authorization 头 | 401 |
| key 错误 | 401 |
| key 正确 | 200 |
多 key / 轮换:编辑 api_keys.txt,一行一个(# 开头是注释),重启生效。
也可以用 API_KEY="sk-a,sk-b"(逗号分隔)临时指定。
3.4 对外暴露的安全要求
局域网(同一交换机/内网)→ 直接用 http://<IP>:7860/v1 + Token,够用。
开放到公网 → 必须做三件事,否则等于把 GPU 白送给全网扫段:
# 1) 防火墙只放行需要的来源(示例:只允许某网段)
ufw allow from 10.60.0.0/16 to any port 7860 proto tcp
ufw deny  7860/tcp          # 其余全部拒绝(确认规则生效后再 deny 默认)
# /etc/caddy/Caddyfile —— 用 Caddy 反代,自动 HTTPS
llm.example.com {
    reverse_proxy 127.0.0.1:7860 {
        header_up Authorization {http.request.header.Authorization}
    }
}
# nginx 等效配置
server {
    listen 443 ssl;
    server_name llm.example.com;
    ssl_certificate     /etc/nginx/ssl/fullchain.pem;
    ssl_certificate_key /etc/nginx/ssl/privkey.pem;
    location / {
        proxy_pass         http://127.0.0.1:7860;
        proxy_set_header   Authorization $http_authorization;
        proxy_read_timeout 600s;          # 27B 首字可能等十几秒,别用默认 60s
        proxy_buffering    off;           # 流式输出透传
    }
}
注意:llama-server 当前 CORS 允许所有来源(启动日志有
CORS allows all origins告警), 浏览器端页面可以直接跨域调用;好处是方便,坏处是任何人都能从网页打你接口,所以 key 一定要开。
4. OpenAI 兼容端点清单(实测)
| 端点 | 方法 | 状态 | 说明 |
|---|---|---|---|
/v1/chat/completions | POST | ✅ 200 | 主力,兼容 99% 客户端 |
/v1/responses | POST | ✅ 200 | Codex 专用口径 |
/v1/models | GET | ✅ 200 | 返回模型列表/元数据 |
/v1/completions | POST | ✅ 200 | 老式补全 |
/v1/embeddings | POST | ❌ 501 | 默认未启用;启动加 EMBEDDINGS=1(--embeddings)可开,见 §6.4 |
/ | GET | ✅ 200 | 内置 WebUI(浏览器需带 Accept-Encoding: gzip,否则 415) |
/health | GET | ✅ 200 | 健康检查 |
/props | GET | ✅ 200 | 服务端参数(可查 n_ctx) |
/v1/models 返回的关键元数据(实测):
{"n_ctx":32768,"n_ctx_train":262144,"n_params":27320697856,
 "size":15665557504,"ftype":"IQ4_XS - 4.25 bpw","quantization_level":"IQ4_XS"}
5. 客户端接入
5.1 Codex CLI(已配置,文件 ~/.codex/config.toml)
完整内容(顶层键必须写在 [model_providers.xxx] 之前,否则会被解析进表里而被忽略):
model                  = "qwen3-27b-uncensored"
model_provider         = "orca-local"
model_context_window   = 32768
approval_policy        = "never"
sandbox_mode           = "danger-full-access"

[model_providers.orca-local]
name       = "OrcaSAQ-2-27B (本地 :7860)"
base_url   = "http://127.0.0.1:7860/v1"
env_key    = "ORCA_API_KEY"
wire_api   = "responses"
换机器 / 换端口只改 3 个值:model、base_url、env_key。
外部设备上的 codex 只需把 base_url 改成本机 IP:
base_url = "http://10.60.119.238:7860/v1"
并在该机器的 shell 里 export ORCA_API_KEY=<密钥>。
校验与常用姿势:
codex doctor                                  # 配置体检(关注 ✓ config loaded)
codex exec --skip-git-repo-check "任务"       # 非交互单发
codex -m qwen3-27b-uncensored                 # 交互式 TUI
5.2 Python openai SDK
import os, openai

client = openai.OpenAI(
    base_url="http://127.0.0.1:7860/v1",        # 外部设备换成 http://<IP>:7860/v1
    api_key=os.environ["ORCA_API_KEY"],         # 或者写死 "orca-llm-...."
)

r = client.chat.completions.create(
    model="qwen3-27b-uncensored",
    messages=[{"role": "user", "content": "用中文说句你好"}],
    max_tokens=100,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}},  # 关思考,见 §6.1
)
print(r.choices[0].message.content)

# 流式
for ev in client.chat.completions.create(model="qwen3-27b-uncensored",
        messages=[{"role":"user","content":"写个快速排序"}], stream=True):
    if ev.choices[0].delta.content:
        print(ev.choices[0].delta.content, end="", flush=True)
依赖安装:pip install openai(/root/llm-stack/venv 里已有 2.29.0)。
也兼容标准环境变量:OPENAI_BASE_URL / OPENAI_API_KEY。
5.3 Cherry Studio / LobeChat / NextChat / Dify 等
统一填这三项:
| 字段 | 值 |
|---|---|
| API Base / 地址 | http://127.0.0.1:7860/v1(外部设备用 IP) |
| API Key | cat /root/llm-stack/api_keys.txt 的内容 |
| 模型 | qwen3-27b-uncensored |
Dify 里用「OpenAI-API-compatible」模型类型,max_tokens 记得放大(见 §6.1)。
5.4 open-webui(:7861)与 GPU 加速
当前 :7861 的后端是 ollama(11434) → CPU 推理,实测约 1.2 tok/s,很慢。
想让它快,在浏览器打开 http://127.0.0.1:7861/ 后:
- 右下角头像 → 管理面板 → 设置 → 连接(Connections)
- 「OpenAI API」→ 添加:URL
http://127.0.0.1:7860/v1,Key 填/root/llm-stack/api_keys.txt的内容 - 保存后,聊天界面顶部模型选择里勾选
qwen3-27b-uncensored - 之后对话走 GPU(37 tok/s);不勾就仍走 ollama
若嫌麻烦,直接用
:7860的内置 WebUI(GPU、免配置)或 Codex。
5.5 ollama 原生接口(:11434)
curl --noproxy '*' http://127.0.0.1:11434/api/tags      # 模型列表
curl --noproxy '*' http://127.0.0.1:11434/api/generate -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-27b-uncensored","prompt":"你好","stream":false}'
用途:脚本里做本地批处理。不建议对外:无鉴权 + 慢。
6. 关键参数与调优
6.1 思考模式(最容易踩的坑)
本模型默认先思考后回答,思考占用 max_tokens 预算:
| 请求 | 结果 |
|---|---|
max_tokens=16,默认思考 | content 为空(16 个 token 全被思考吃掉) |
max_tokens=100,默认思考 | 正常回答,思考在 reasoning_content 字段 |
chat_template_kwargs={"enable_thinking":false} | 直接回答,最省 token |
建议:长文本/代码场景显式关思考;要思考质量就给够 max_tokens(≥512)。
6.2 上下文与显存对照表(RTX 4090 24G 实测)
CTX_SIZE | KV 类型 | 显存 | 说明 |
|---|---|---|---|
| 16384 | f16 | 15500 MiB | 默认值 |
| 32768 | q8_0 | 15666 MiB | 当前运行值,推荐 |
| 65536 | q8_0 | ≈ 20 GB | 临界,需关其他占显存程序 |
- 实测 30012 token 的 prompt 在 32768 下正常返回;37512 token 触发干净的
400(request ... exceeds the available context size),不会崩服务。 - 经验换算:约 1 token ≈ 8 个中文字符(240000 字符 ≈ 30012 token)。
- 当前启动:
CTX_SIZE=32768 KV_CACHE_TYPE=q8_0(KV 量化把上下文翻倍而显存几乎不变)。
6.3 性能基准(实测)
| 指标 | 数值 |
|---|---|
| 生成速度 | 35.8 ~ 47 tok/s |
| Prompt 处理 | 145 ~ 206 tok/s |
| 显存占用 | 15.5 GB / 23.0 GB |
| Codex 单次任务 token | 150(读文件) ~ 7600(带技能目录) |
| ollama(11434) CPU | ~1.2 tok/s |
6.4 启动变量速查(/root/start_app.sh)
| 变量 | 默认 | 作用 |
|---|---|---|
API_KEY | 空 | 直接指定 key;空则不鉴权 |
API_KEY_FILE | 空 | 从文件读 key(一行一个) |
CTX_SIZE | 16384 | 上下文长度 |
KV_CACHE_TYPE | 空 | q8_0 时 KV 减半,上下文可翻倍 |
EMBEDDINGS | 0 | 设 1 开启 /v1/embeddings(RAG 用) |
GPU_LAYERS | 999 | 上 GPU 的层数 |
WEB_PORT / UI_PORT / OLLAMA_PORT | 7860/7861/11434 | 端口 |
BIND_ADDR | 0.0.0.0 | 绑定地址(对外必须 0.0.0.0) |
WEBUI_AUTH | false | open-webui 是否要登录 |
OLLAMA_USE_GPU | 0 | 设 1 让 ollama 也吃 GPU(需先停 llama-server) |
KILL_GRACE | 3 | 端口释放轮询秒数 |
当前推荐的完整启动命令(复现/重启用这条):
cd /root && API_KEY_FILE=/root/llm-stack/api_keys.txt KV_CACHE_TYPE=q8_0 CTX_SIZE=32768 ./start_app.sh
7. 排错手册(症状 → 原因 → 处置)
| 症状 | 真实原因 | 处置 |
|---|---|---|
HTTP 401 | 没带 key 或 key 错 | curl -H "Authorization: Bearer $(cat /root/llm-stack/api_keys.txt)" |
HTTP 400 ... exceeds the available context size | 请求超 32768 | 裁短 prompt / 提高 CTX_SIZE / 开 KV_CACHE_TYPE=q8_0 |
content 为空但 reasoning_content 有值 | 思考吃光了 max_tokens | 加大 max_tokens 或 enable_thinking:false(§6.1) |
HTTP 415 Error: gzip is not supported | 客户端不带 Accept-Encoding: gzip | 浏览器无此问题;curl 加 --compressed |
HTTP 404 model not found | 模型名写错 | 必须是 qwen3-27b-uncensored |
codex ERROR: Reconnecting... 5/5 + high demand | 后端返回 5xx(最常见:模板报错)或被代理劫持 | ① export NO_PROXY='*' ② 见下面两条 |
codex 后端日志 Jinja Exception: System message must be at the beginning | Qwen3 模板拒绝「非首位 system」,而 Responses 的 developer 角色会被映射成 system | 勿删 /root/llm-stack/chat_template.codex.jinja(补丁已由脚本自动生成并传给 llama-server);删了重启即复现 |
codex bwrap: No permissions to create a new namespace | 本容器内核禁止 unprivileged user namespace | 保持 sandbox_mode = "danger-full-access"(已验证唯一可用项) |
Missing environment variable: ORCA_API_KEY | 旧终端没加载 env.sh | source ~/.bashrc 或 export ORCA_API_KEY=$(cat /root/llm-stack/api_keys.txt) |
| curl 到本地却 502 / 连接被重置 | http_proxy=127.0.0.1:7890(mihomo)劫持 | 一律加 --noproxy '*';SDK 类设 NO_PROXY=127.0.0.1,localhost |
codex 提示 Model metadata ... not found | codex 没有该模型的元数据目录 | 无害告警,忽略;已配 model_context_window = 32768 |
| 端口被占用起不来 | 上一次实例没退干净 | ./start_app.sh stop,脚本只按端口精确清理,不误杀其他进程 |
:7861 回复很慢 | 走的是 ollama CPU | 见 §5.4 改指向 7860 |
快速定位命令
/root/start_app.sh status                                  # 谁占了端口
tail -f /root/llm-stack/logs/llama-server.log              # 后端实时日志(排错就看它)
tail -20 /root/llm-stack/logs/open-webui.log
tail -20 /root/llm-stack/logs/ollama.log
curl --noproxy '*' -H "Authorization: Bearer $(cat /root/llm-stack/api_keys.txt)" \
     http://127.0.0.1:7860/props | python3 -m json.tool | grep n_ctx
8. 运维
8.1 启停
/root/start_app.sh            # 启动:清端口 → 检查依赖 → 拉起三服务 → 前台驻留
/root/start_app.sh stop       # 停止(只按端口精确杀,不动其他进程)
/root/start_app.sh status     # 看端口/进程
- 前台运行,
Ctrl+C会把本次拉起的三个服务一起停掉。 - 要后台常驻:
cd /root && API_KEY_FILE=/root/llm-stack/api_keys.txt KV_CACHE_TYPE=q8_0 CTX_SIZE=32768 \ nohup ./start_app.sh > /root/llm-stack/start.log 2>&1 & - 启动时序:
阶段1端口清理(SIGTERM → 最多等 3s → SIGKILL → 再等 3s)→阶段2依赖/模板 →阶段3启动(ollama → llama-server 等权重加载完 → open-webui)→阶段4前台驻留。
8.2 关键文件
| 路径 | 作用 |
|---|---|
/root/start_app.sh | 一键启动脚本 |
/root/llm-stack/logs/ | 三个服务的日志 |
/root/llm-stack/api_keys.txt | API 密钥 |
/root/llm-stack/COPY_THIS_KEY.txt | 给人看的密钥与地址 |
/root/llm-stack/env.sh | codex/SDK 环境变量(已挂 .bashrc/.profile) |
/root/llm-stack/chat_template.codex.jinja | Codex 必需的模板补丁 |
/root/llm-stack/Modelfile | ollama 注册用的 Modelfile |
~/.codex/config.toml | codex 配置(备份:~/.codex/config.toml.bak.*) |
/root/llama.cpp/ | llama.cpp 源码与编译产物 |
8.3 日常提醒
- 别删
/root/llm-stack/chat_template.codex.jinja,否则 codex 立刻 500。 - 磁盘已用约 44G:llama.cpp 编译产物 + open-webui venv(7.4G) + ollama 复制的权重(15.7G)。
只用 7860 的话,
~/.ollama/models/blobs里那份复制品可删(会失去 ollama 能力)。 - 换模型:改
MODEL_FILE指向新 GGUF,重跑start_app.sh(模板补丁会按新模型重新生成)。
9. 附录:一条命令生成可复用的调用片段
K=$(cat /root/llm-stack/api_keys.txt); IP=$(hostname -I | awk '{print $1}')
echo "# curl
curl --noproxy '*' http://$IP:7860/v1/chat/completions \\
  -H \"Authorization: Bearer $K\" -H 'Content-Type: application/json' \\
  -d '{\"model\":\"qwen3-27b-uncensored\",\"messages\":[{\"role\":\"user\",\"content\":\"hi\"}],\"max_tokens\":100}'

# python
export ORCA_API_KEY=$K OPENAI_BASE_URL=http://$IP:7860/v1"
-
咨询问题前请注意:
-
1.先说明哪个镜像,发镜像链接和名称,例如:
-
Qwen3.8-27B Unleashed文本大模型支持webui和api调用破限为所欲为特别版
-
2.先拿到运行报错的log日志或者截图:
-
没有上面的信息我也没有办法帮到你的,因为镜像比较多,我不清楚你问的哪个镜像的
-
感谢使用!感谢理解! 感谢支持!
 认证作者