MiniMax-H3数字人口播|一张照片+一段录音生成对口型说话视频|中文工作台·自动防换镜头
上传照片和录音生成口播视频,中文工作台自动启动。4090 48GB支持高画质与极速两档,可预览并下载MP4。
运行环境
框架版本
CUDA版本
13.2
应用
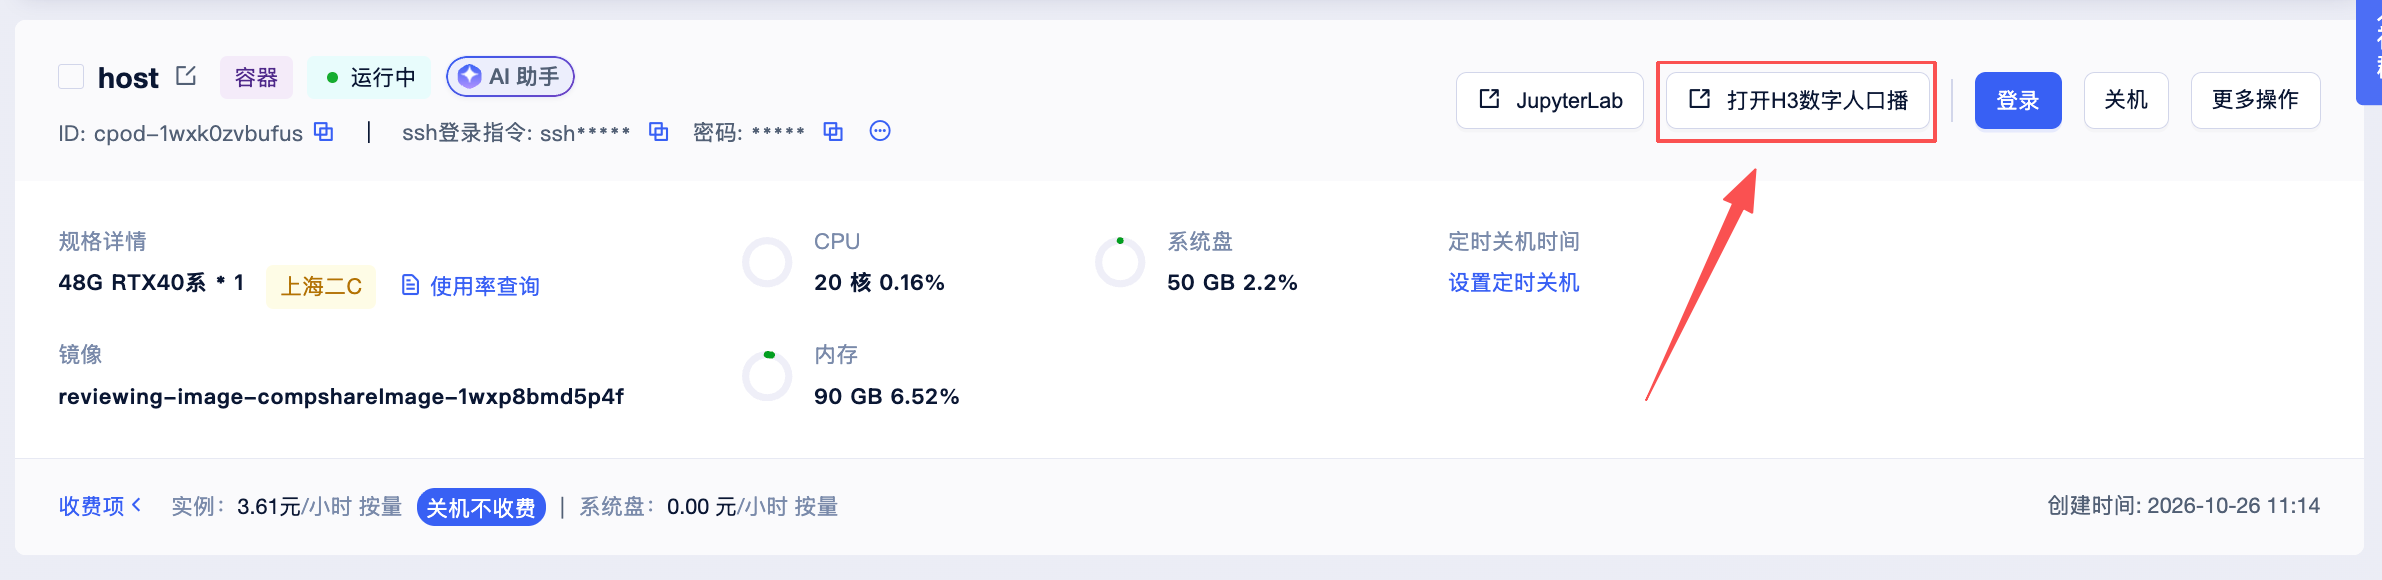
打开H3数字人口播: 7860
支持卡型
48G RTX40系
上传一张人物照片和一段录音,生成带原录音的口播视频。作者 / 整合发布:王知风。AI 工具群:957732664;官网:https://huigui.ai。
部署与使用
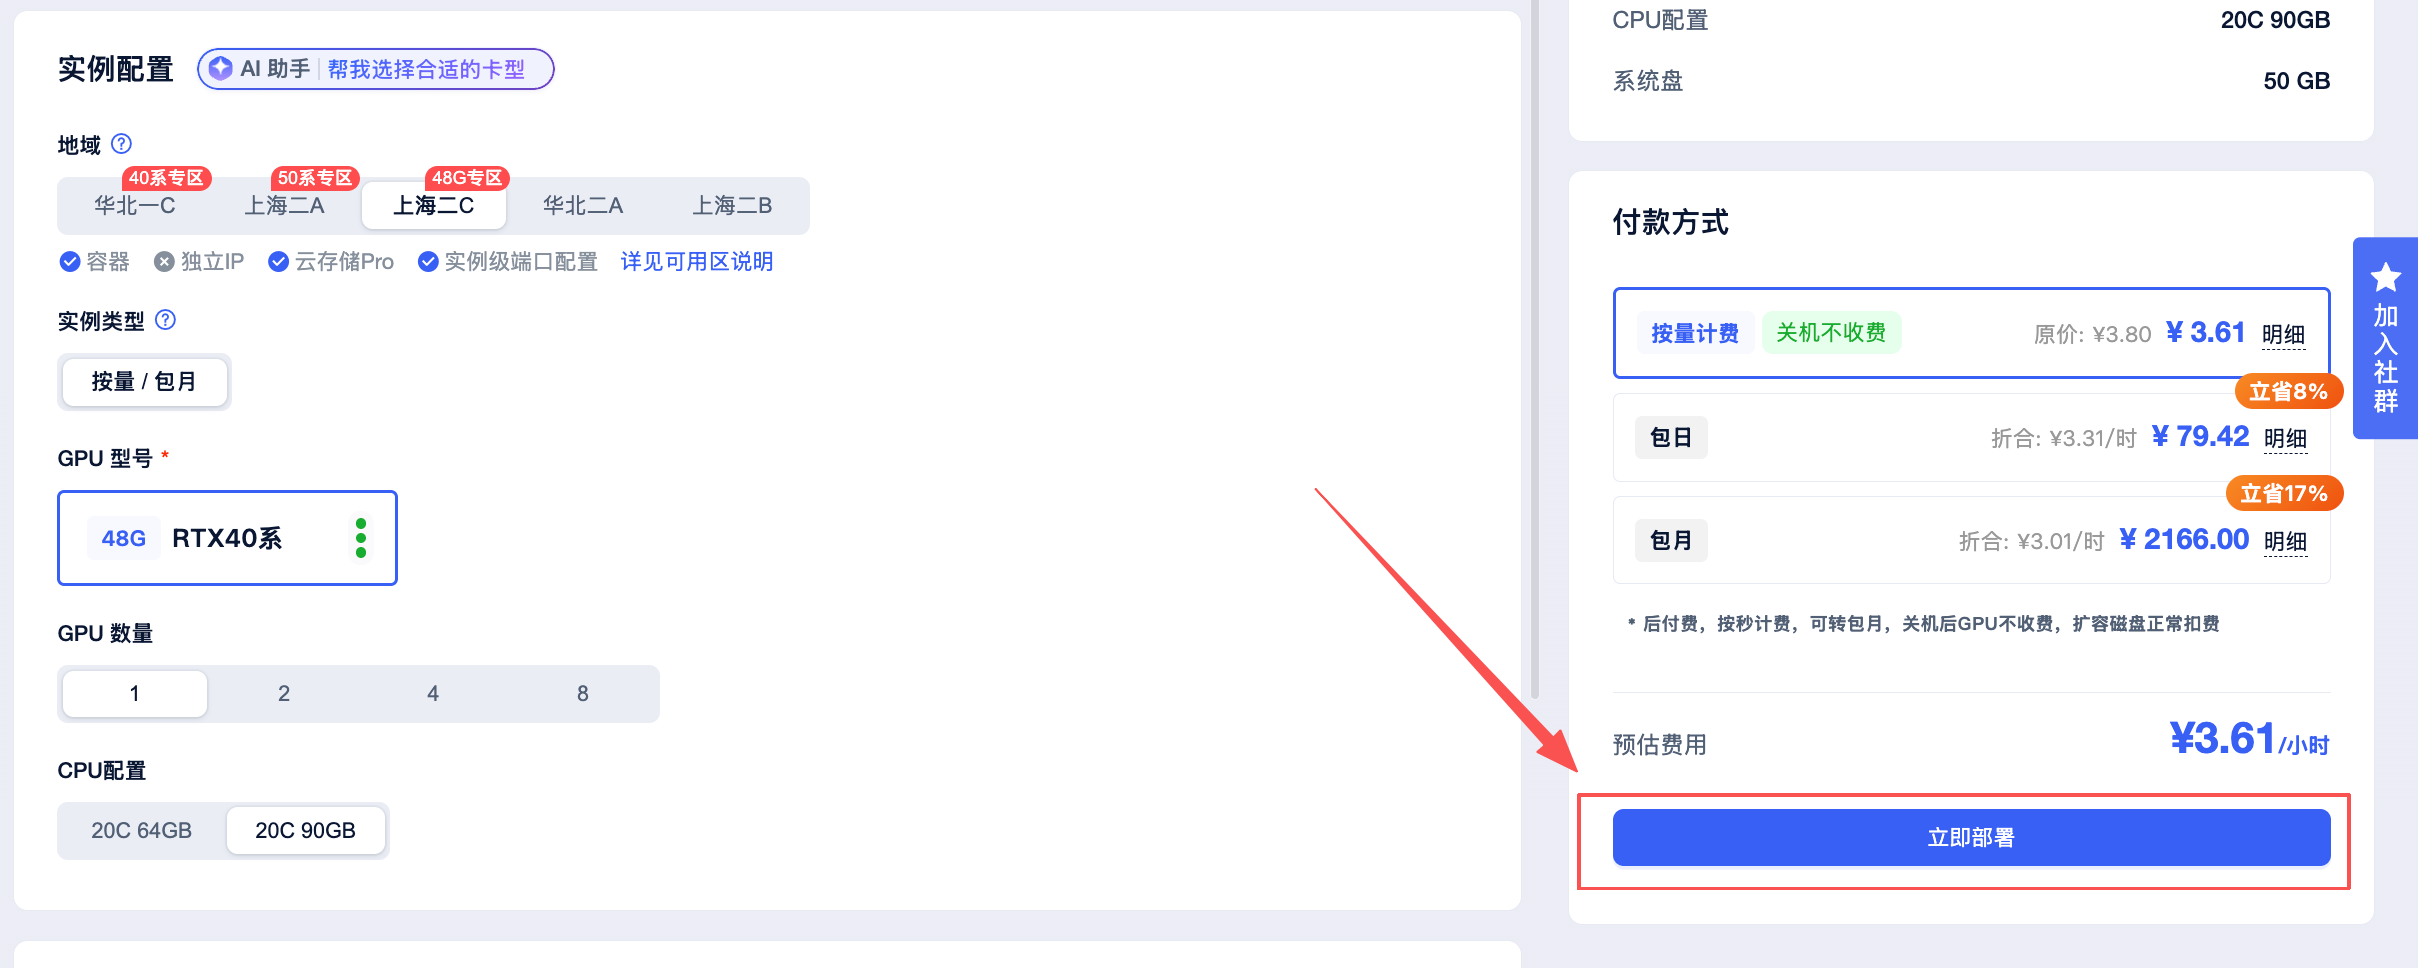
- 使用上海二C容器实例,单卡 RTX 4090 48GB、20核、90GB内存、50GB系统盘。其他显卡和区域尚未验收。
- 开机后点击“打开H3数字人口播”(HTTP 7860)。工作台会自动检查模型、启动服务,无需手工启动。首次准备需要时间,页面会显示状态。
- 上传清楚的单人正脸或半身照片(PNG/JPG/WebP)和干净人声录音(WAV/MP3/M4A等),确认已取得肖像和声音使用授权,点击“开始生成”。
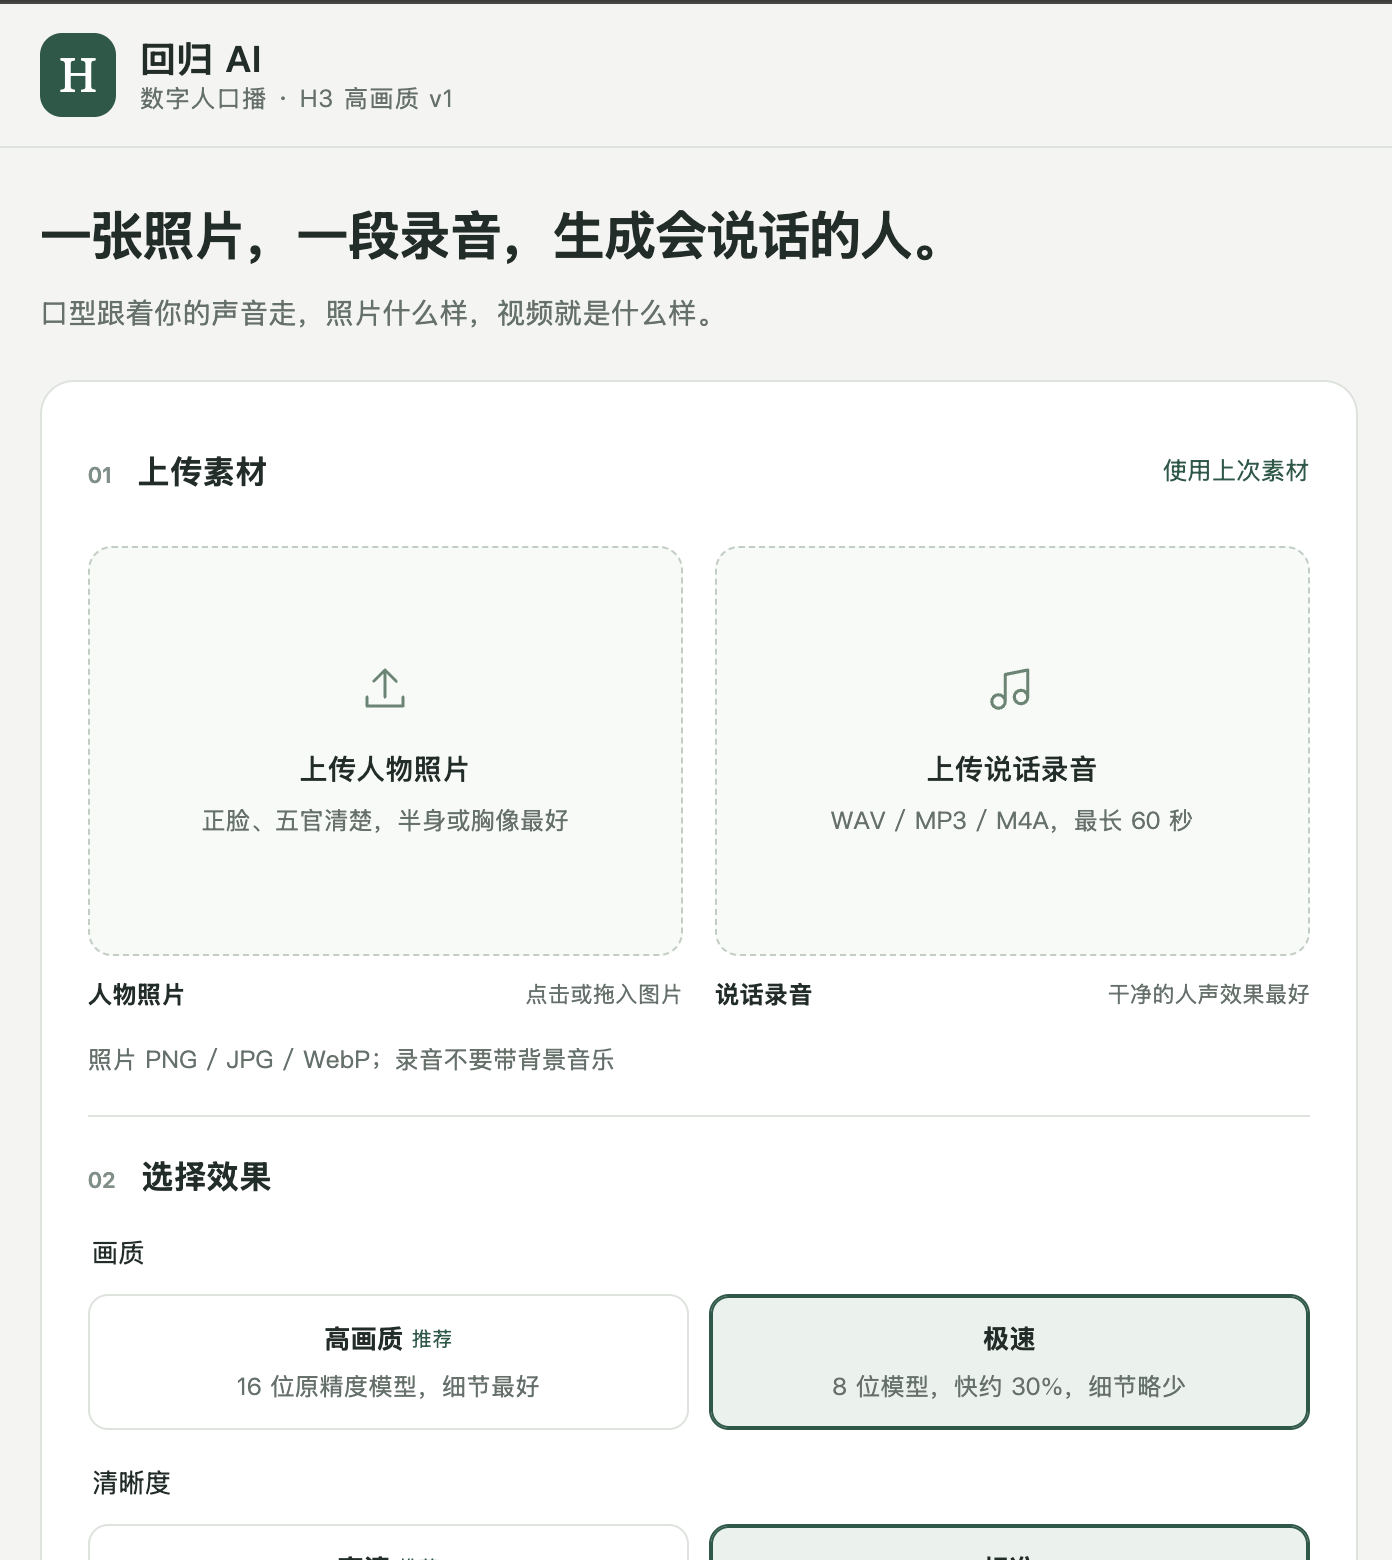
- 默认使用高画质;需要更快可选极速。生成完先预览声音和画面,再下载保存。
- 用完到优云控制台关机。关闭网页不会停止计费。按平台规则,关机后的磁盘/镜像存储仍可能收费,实例长期关机可能被回收。
两种画质
| 选项 | 配置 | 最终私有镜像实测条件与耗时 |
|---|---|---|
| 高画质(默认) | 剪枝 BF16 主模型、INT8 文本编码器、DMD 8步 | 4090 48GB,1312×736、24fps,6.5秒约291秒 |
| 极速 | 剪枝 INT8 主模型、同一 INT8 编码器、DMD 8步 | 同卡同清晰度,6.5秒约200秒 |
以上为2026-10-25最终私有镜像新实例连续两次生成实测,不是任意素材的速度保证。自动重做、模型加载和服务器负载会增加时间。界面的“标准”清晰度约90万像素,不代表16GB标准模型档。输出按照片比例计算,高清约100万像素,不能宣称原生4K。
模型与启动
- 5个大模型文件通过软链读取上海二C公共库
/model/ModelScope/Comfy-Org/MiniMax-H3,不用从用户电脑上传。 - 公共库尚未提供的 DMD 8步 LoRA(约2.3GB)和4B看图提示词模型(约4.8GB)已经放在镜像中。运行时无需下载模型。
- 主程序
/root/h3-digitalhuman;开机入口/start.d/60-h3-digitalhuman.sh;工作台7860;内部ComfyUI只监听127.0.0.1:8188。 - 遇到缺模型提示先检查该区域公共库挂载,禁止用“服务已启动”代替模型就绪。
限制
- 历史测试覆盖横屏照片和约15秒录音;竖屏、60秒长录音尚未验收。页面允许最长60秒,不等于已验证该长度。
- 人物身份、口型、动作与随机种子有关;停顿时嘴可能未完全闭合。
- 系统会检测换镜头并尝试重做,但不能保证所有素材均成功。失败应查看页面错误,不应隐藏错误或无限重试。
- 相同素材和参数可能复用上次结果;想重新生成可更换随机种子。
- 使用者应遵守各上游模型许可证,并只处理获得授权的照片和声音。
发布验收状态
v1最终私有镜像的新实例已完成:无需手工修补的自动启动、真实图片和音频上传、两档生成、浏览器未静音播放到结束、MP4实际下载及完整解码。抽帧检查未见换镜头;不保证任意素材的身份和口型效果。社区审核与公开入口验收单独记录。