MOSS-TTS 语音模型
MOSS-TTS,接口API,语音合成,声音克隆,TTS,支持超长文本,支持50系
运行环境
框架版本
CUDA版本
2.8
应用
JupyterLab: 8888
支持卡型
RTX40系RTX50系
+4
MOSS-TTS 语音模型
镜像简介
本镜像基于MOSS-TTS语音模型,提供标准API接口服务,支持高质量语音合成与声音克隆,可处理超长文本,兼容50系显卡。适用于有声内容创作、智能语音助手、个性化配音及跨语言交互等场景,为用户提供高效的一站式语音AI解决方案。
镜像操作指南
1、该镜像支持自启动,初始化后,需要等待服务启动,大概2分钟左右,可以输入命令 tail -50f /root/wan/log.txt 查看启动日志
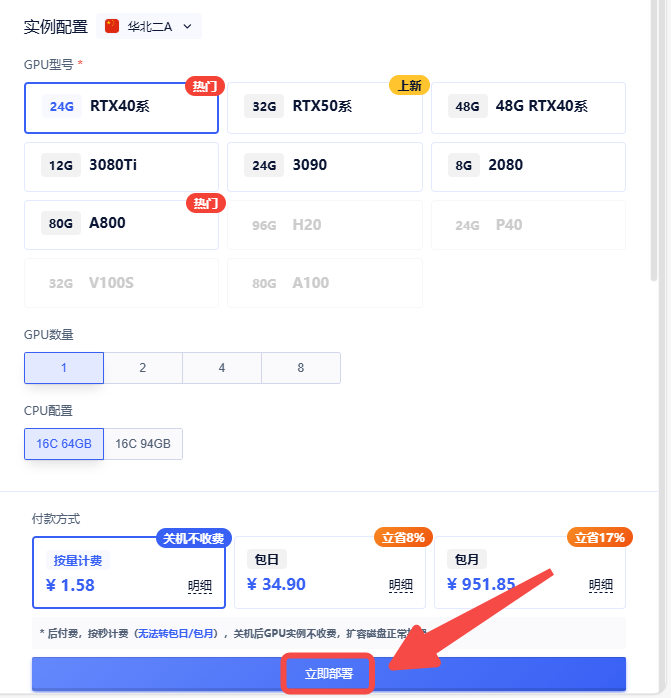
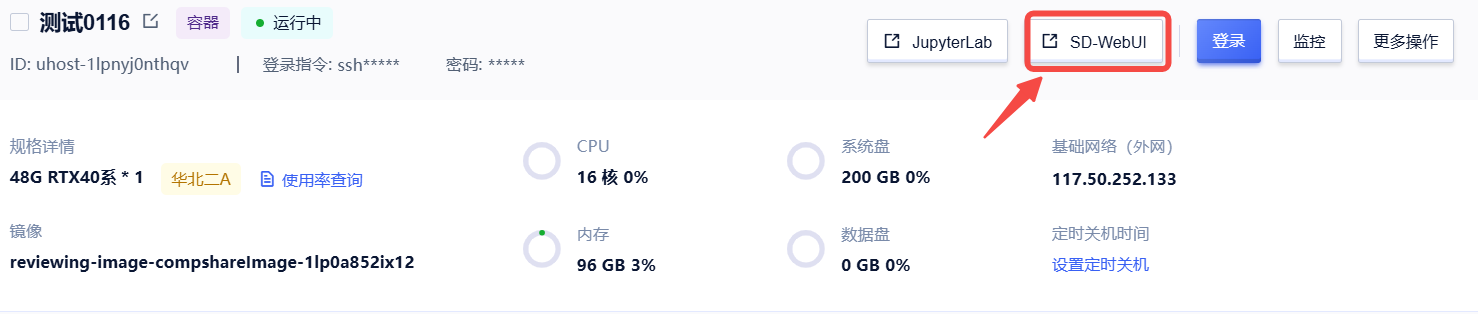
2、随后点击 SD-WEBUI 按钮即可,上传音色文件或者选择音色,点击生成即可,支持批量任务

3 支持接口请求
接口格式:http://你的实例ip:8188/?text=你好,测试一下&speaker=trump
其他参数 speed

 认证作者