H3
镜像社区
部署GPU实例
模型与Agent
MiniMax H3
AI 生图
AI 音频
价格
桌面客户端
文档中心
控制台
立即注册
镜像社区
>
镜像详情
OCR识别
AI应用
Qwen3-TTS
0.1
元/时
有声书生成
通过OCR识别文字,然后TTS生成有声书
镜像大小
70 GB
当前版本
v1.0
累计部署
9 次
累计运行
15 h
最近更新
2026-07-23
运行环境
运行环境
框架版本
PyTorch-2.10.0
CUDA版本
13.0
应用
JupyterLab: 8888
支持卡型
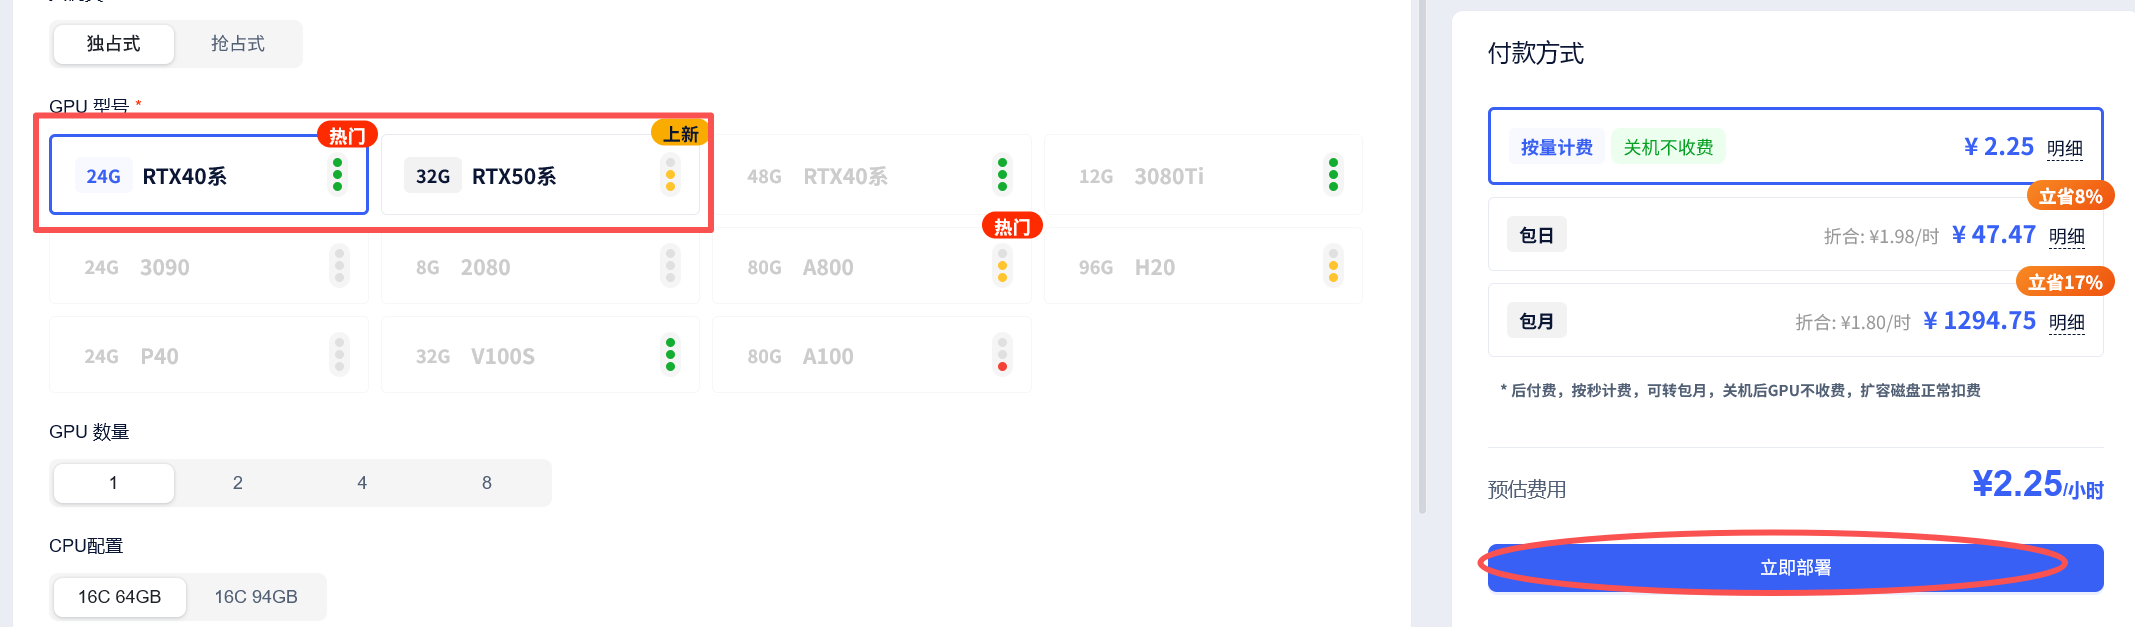
RTX40系
RTX50系
有声书生成
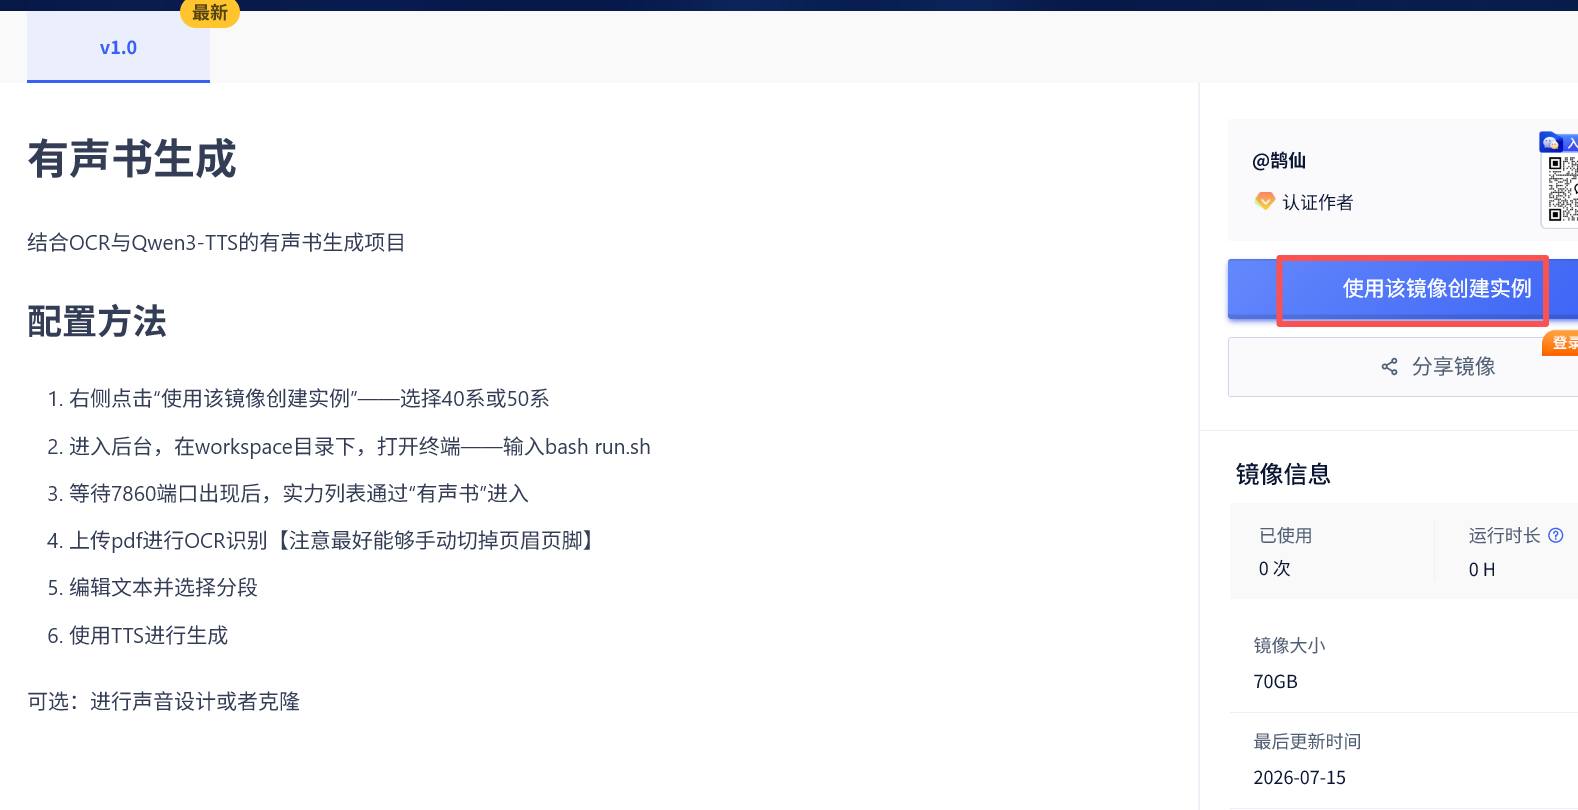
结合OCR与Qwen3-TTS的有声书生成项目
配置方法
右侧点击“使用该镜像创建实例”——选择40系或50系
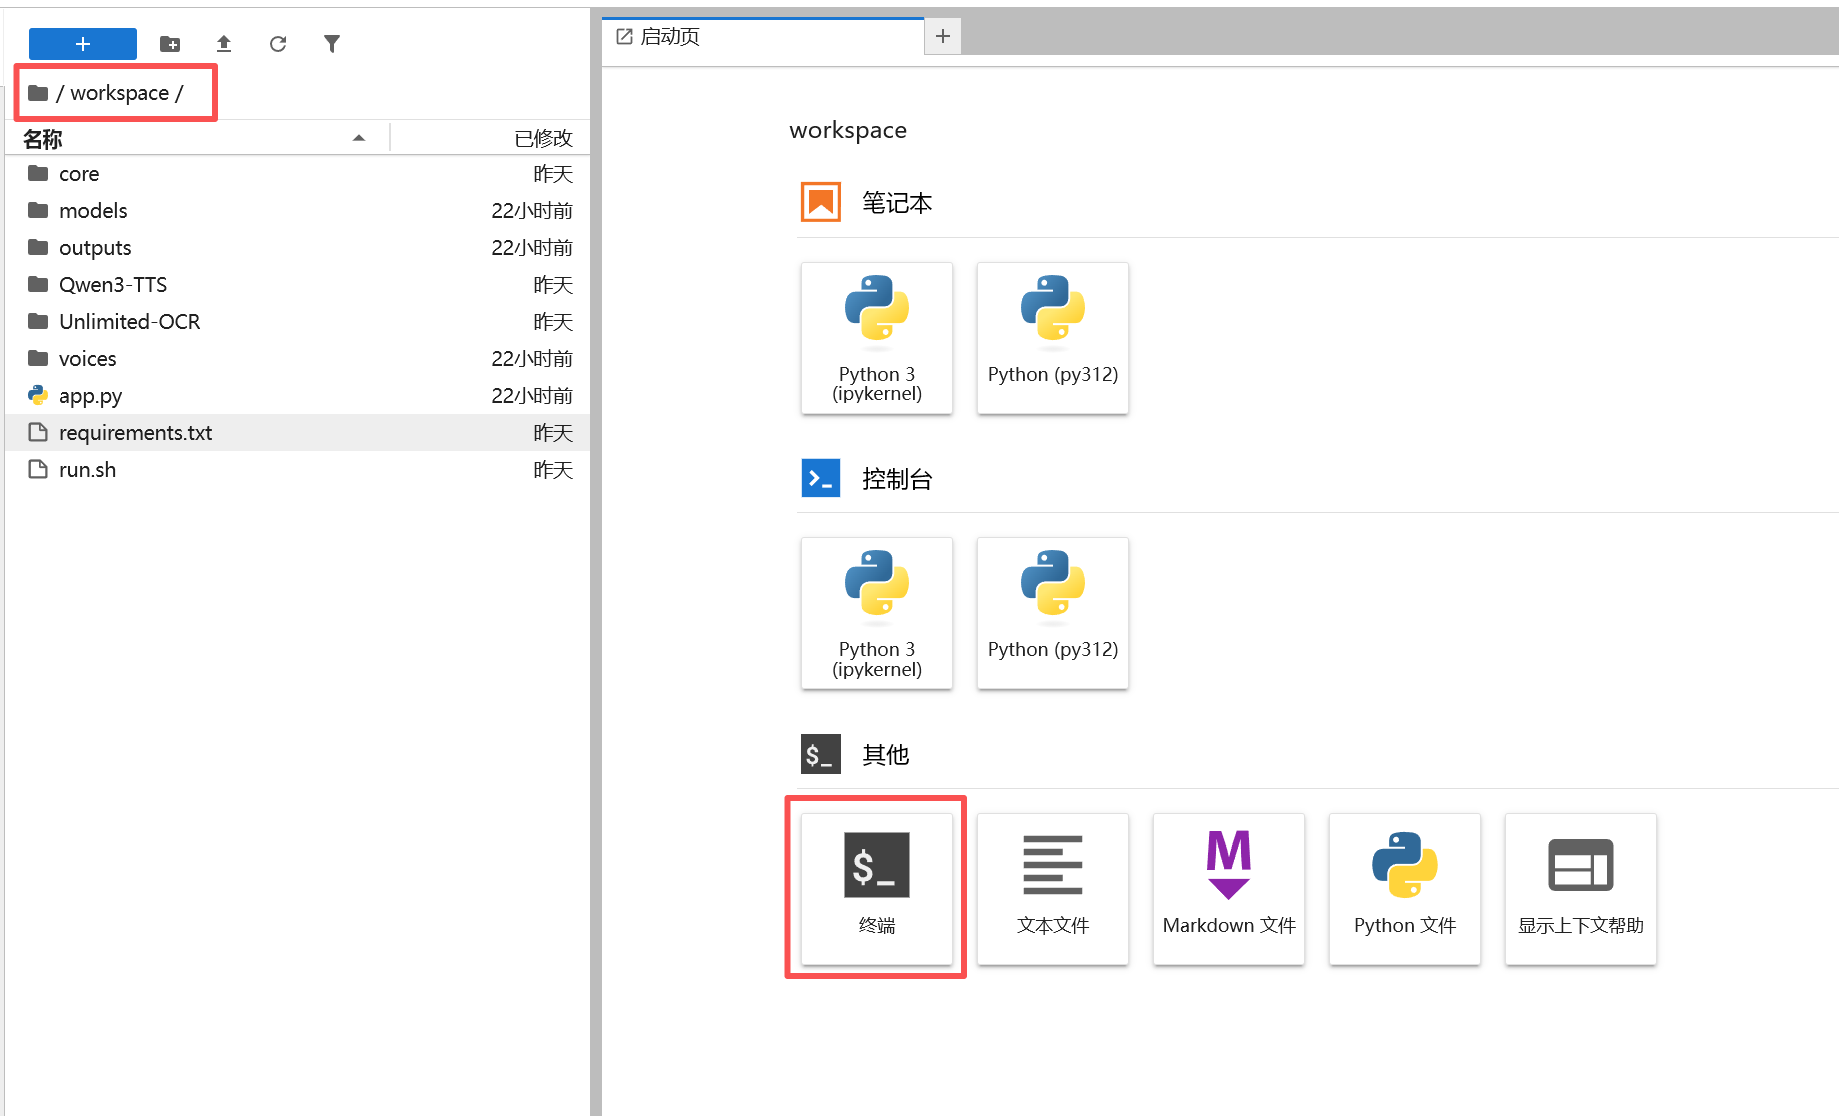
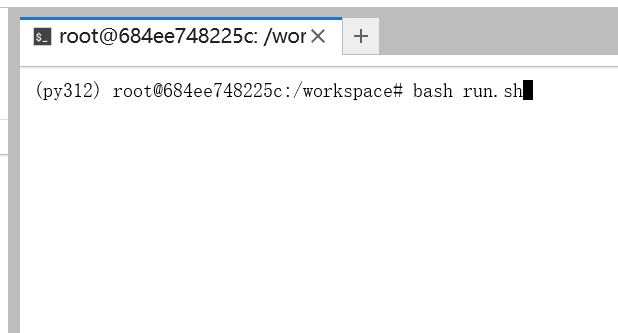
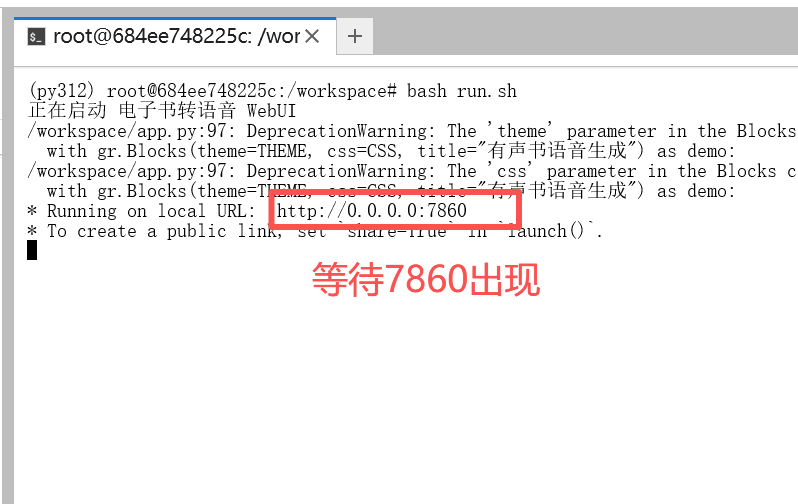
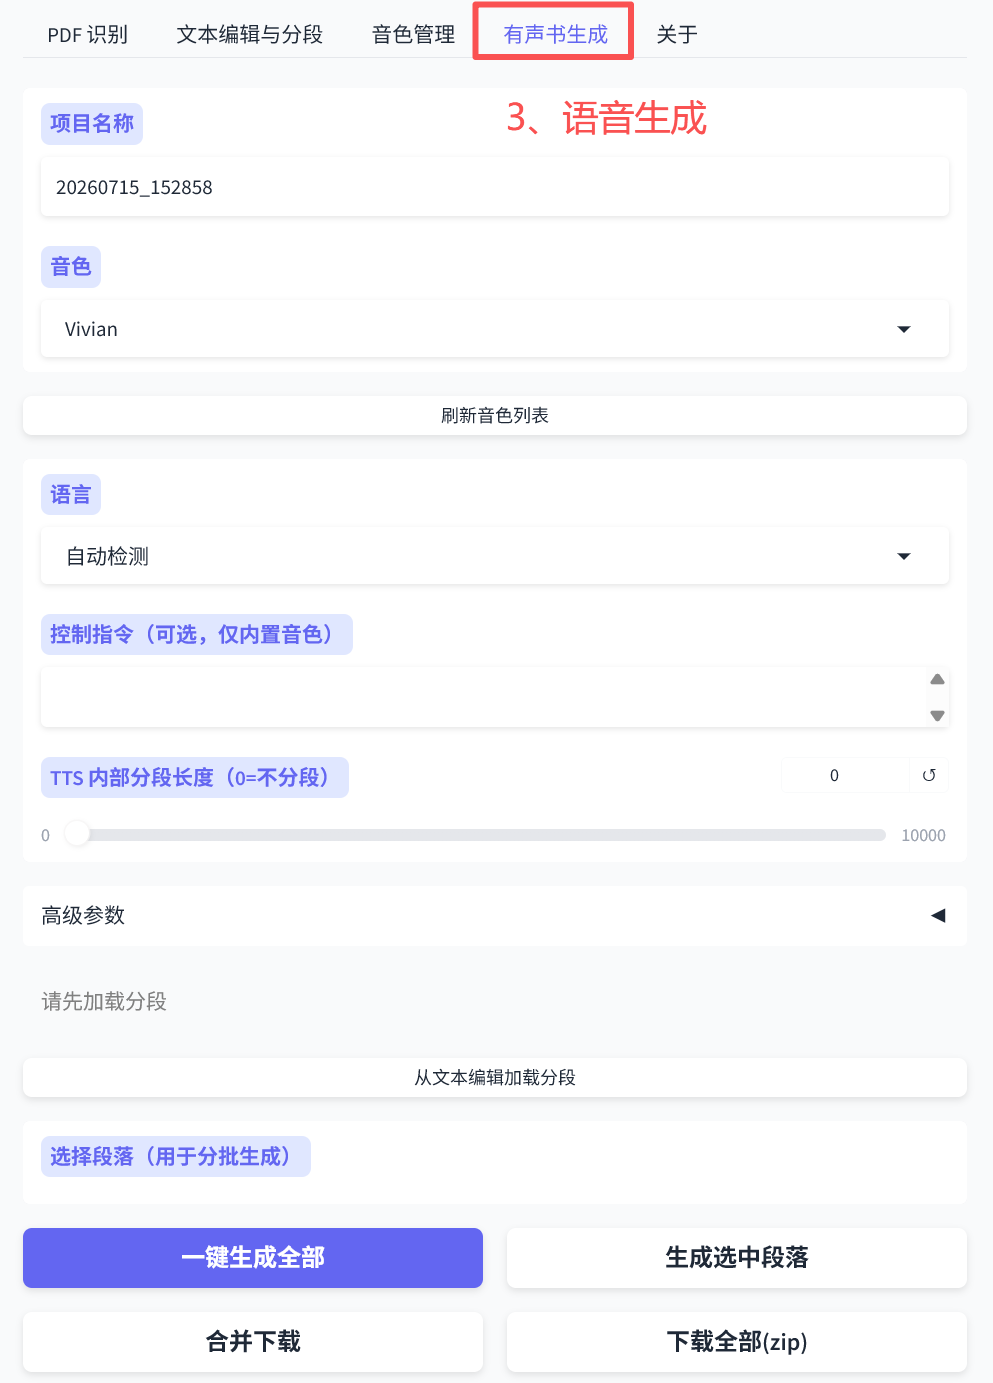
进入后台,在workspace目录下,打开终端——输入bash run.sh
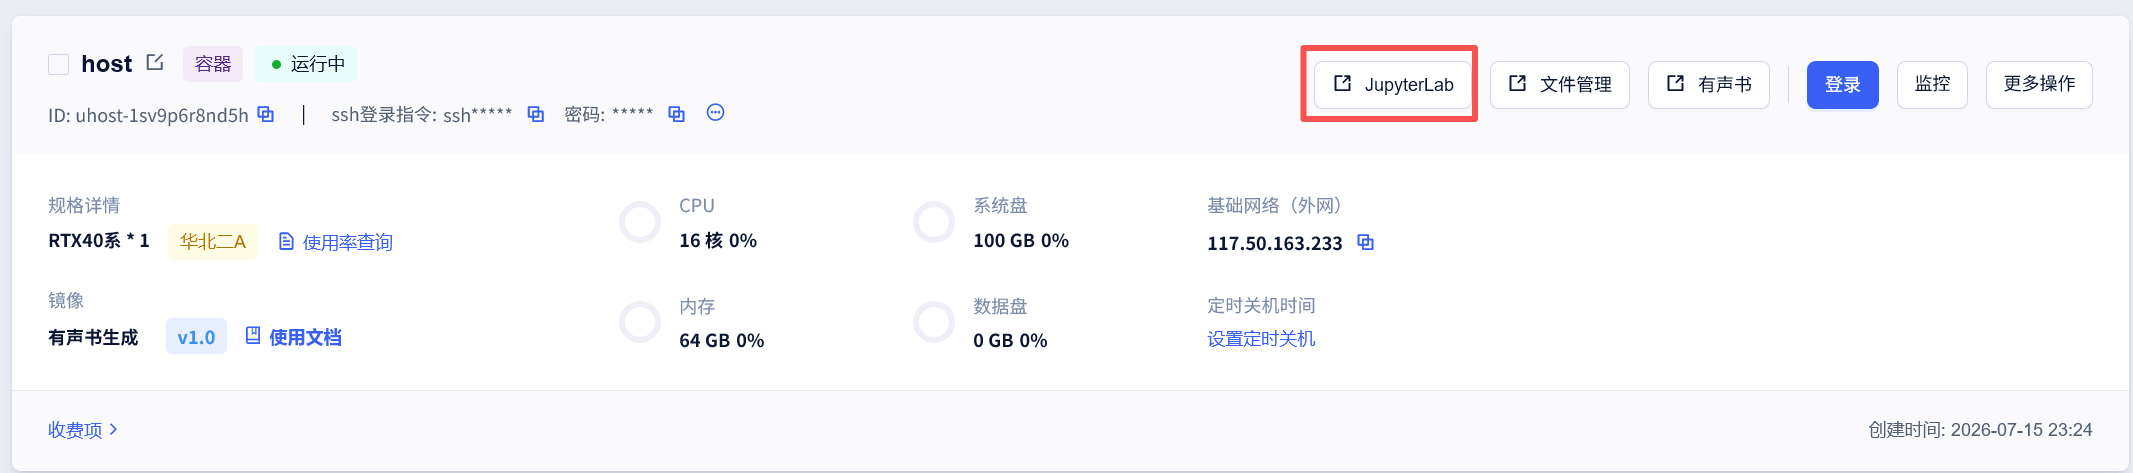
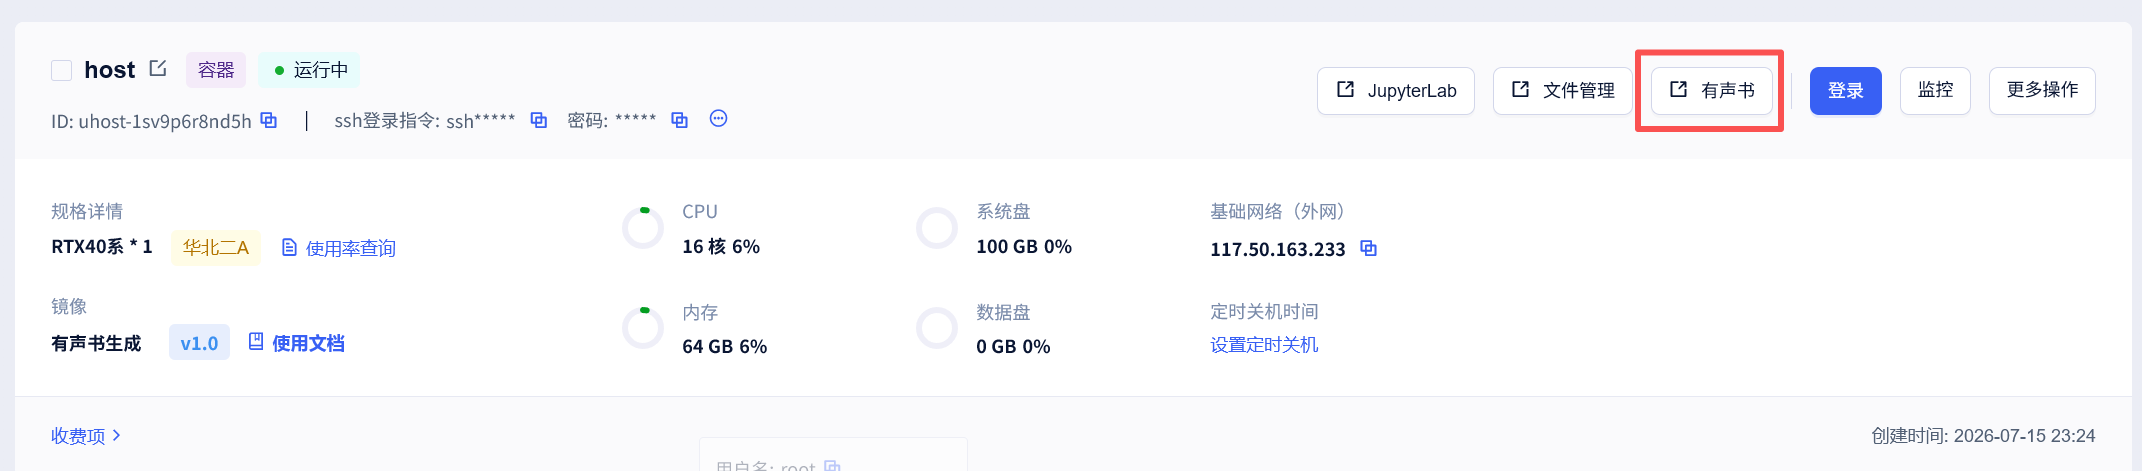
等待7860端口出现后,实力列表通过“有声书”进入
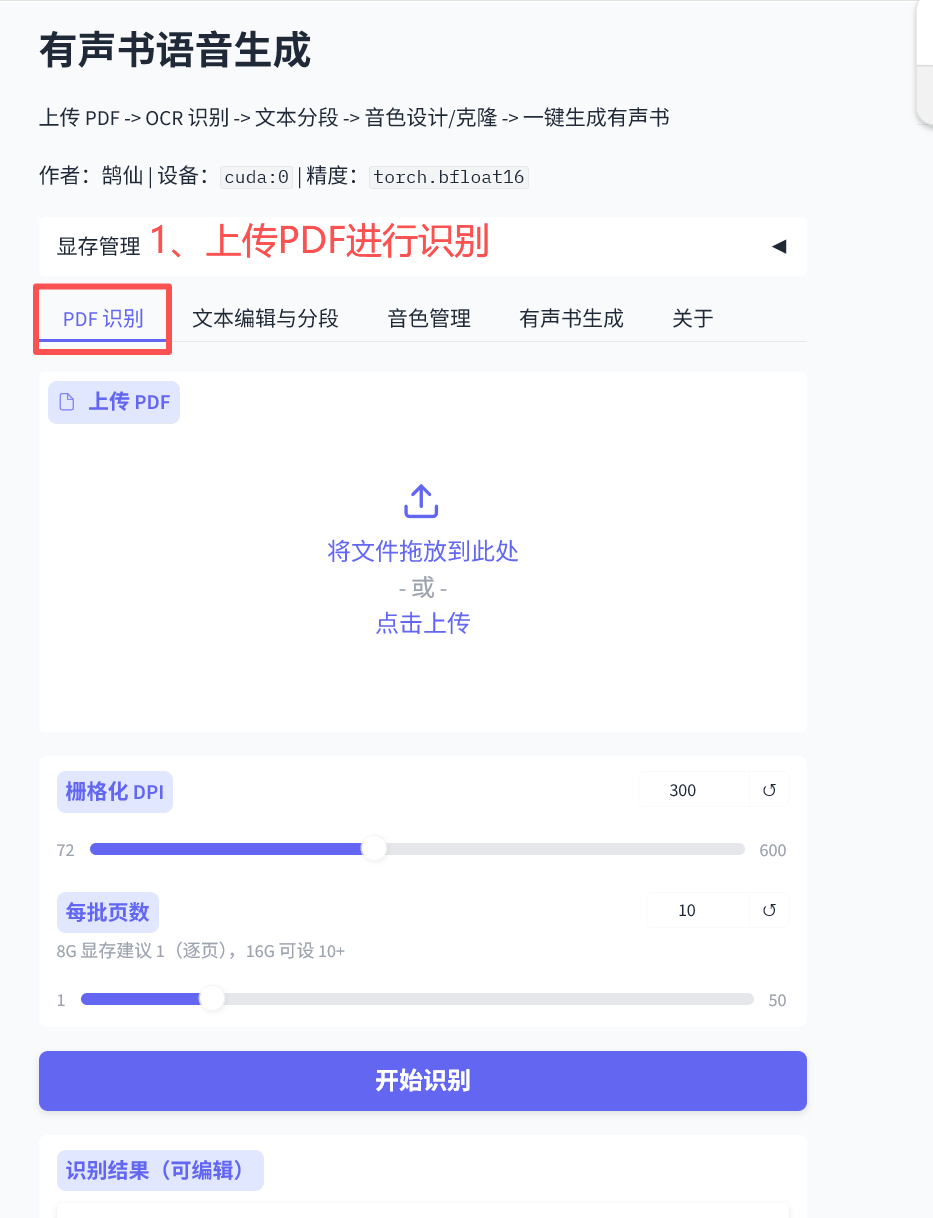
上传pdf进行OCR识别【注意最好能够手动切掉页眉页脚】
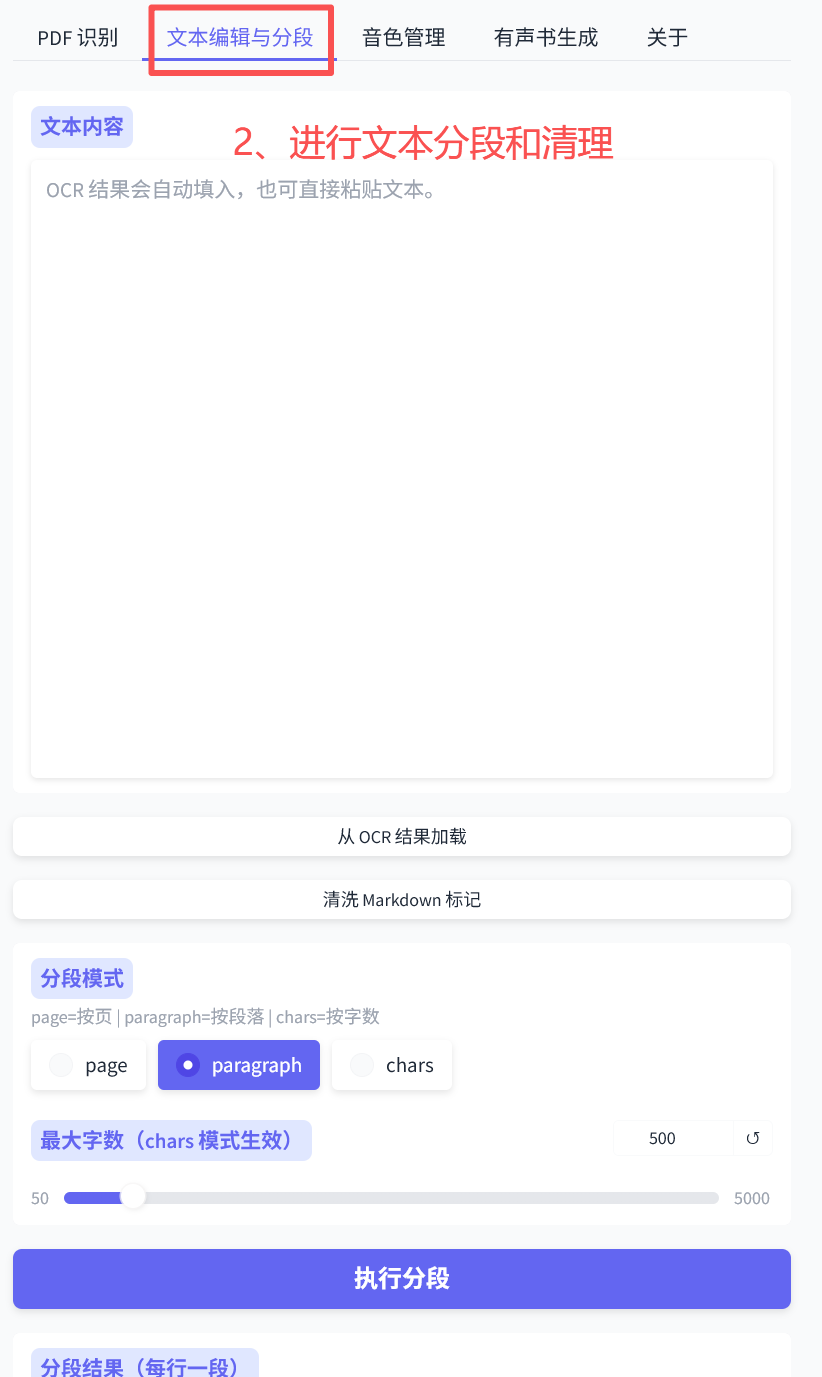
编辑文本并选择分段
使用TTS进行生成
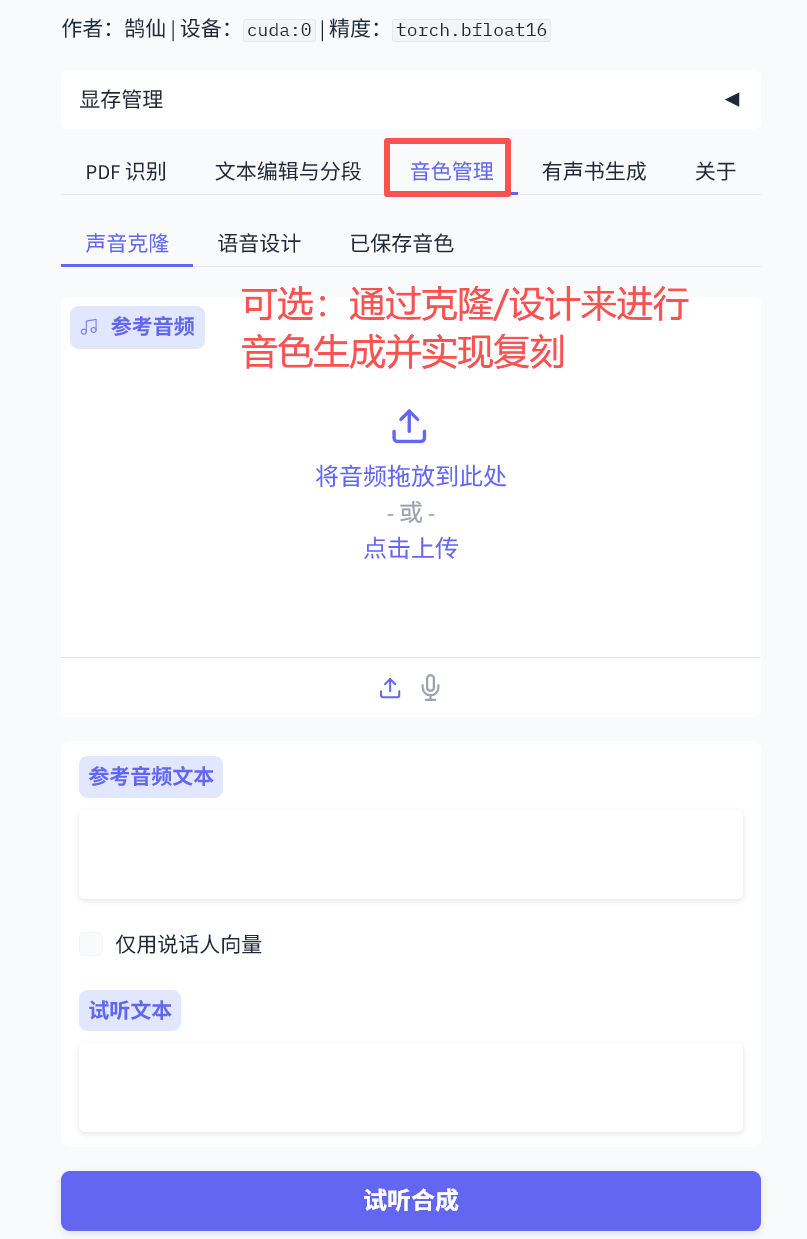
可选:进行声音设计或者克隆
鹄
鹄仙
认证作者
个人主页
0 个镜像 · 被使用 9 次
使用该镜像创建实例
☆ 收藏 3
分享
交流与支持
扫码加入交流群
作者与用户在群内答疑
版本日志
v1.0
最新
2026-07-15
评分
0.0
暂无评分
我的评分
★
★
★
★
★
未评分
提交评分
相关镜像
FreeVideo直出1080P
12 部署 · 16h
Qwen2.1+H3 双剑合璧
145 部署 · 528h
MiniMaxH3生态模型大汇聚
148 部署 · 831h
Yue2音乐制作工坊
22 部署 · 24h
AI音乐制作ACE-Step-1.5XL官方包
89 部署 · 1,941h
Copyright © 2025 沪ICP备12020087号-61
有声书生成一键部署 | 优云智算