无限画布作图Imag2.5内置无限出图
全能作图无限画布 · 支持 GPT Image 2.5
运行环境
全新智能体 · 2.5 模型 · 无限画布-生图工作台
GPT Image 2.5 系列登顶全球图像竞技场前列 文生图、修图全面超过上一代 Image 2;人像赛道 2.5 位居第一 这不是换皮,是从「会画」升级到「先想清楚再画」

学习交流 & 商务合作 联系:(微信)lcsj00929
它究竟强在哪里?
文字渲染 — 海报、包装、字幕,不再写「火星文」 过去 AI 作图最大的笑话就是:图画得很好看,字却写得像乱码。
GPT Image 2.5 把文字当画面的一部分来画,不只是事后贴上去。中文、英文、日文、韩文更稳、更清楚,笔画和排版都更像设计稿。
海报 Slogan → 能读、能用 产品包装中文标注 → 更完整 封面标题、角标、字幕条 → 和画面一起生成 以前要专门进 PS 贴字的工作,现在一句话就能先出一版能交差的成稿。
中文智能体 — 你说人话,它先理解,再出图 不需要把提示词翻译成英文,不需要背「咒语」。
直接用中文描述你想要的画面。 智能体会先把你的意图整理成更稳的出图指令,你确认后再画。
「把@图一的衣服换成@图二,脸和姿势别动,背景改成外滩夜景」——这句话,它能拆清:谁是人、谁是衣服、什么能改、什么必须留。
嫌它多事?一键关掉「提示词优化」,原文直出。想从一张成片反推可再画的提示词?打开「反推提示词」即可。
中文表达 → 智能体理解 → 2.5 落笔。这是 2.0 页面做不到的。
先思考,再画图 — 不是在「猜」,是在「理解」 普通 AI 作图:你给什么,它就画什么,大概率理解偏差。
这版智能体背后是思维链式整理:生成前先看你的需求、参考图和所选比例。
你要的是换装、换人、换场景,还是全新一张? 画面主次是谁?哪张图只是衣服、哪张图才是人? 光线、构图、色调怎么配才像你要的成品? 然后再交给 GPT Image 2.5 动笔。
这就是为什么同样一句话,别的模型画出来「差不多」,它画出来「真的是你想要的」。
多图引用 — @图一到@图八,同一个人也能换一百个场景 做内容最头疼的不是出一张,是换个场景就变脸、换衣服就换人。
新版最多 8 张参考图,提示词里 @图一 @图二 会变成整块标签,删就整块去掉,不会剪到一半。
锁定脸型、发型、肤色 只换上衣、外套、裙子,不改五官 人留着,场景换到棚拍、街头、室内 资产库可上传、可批注:红圈、画笔、箭头标出「只改这里」。连续剧分镜、品牌模特多场景、电商换装图——可以按角色和素材来做,而不是每张从零赌脸。
指令遵循 + 画幅可控 — 说什么改什么,比例和清晰度你说了算 「把背景换成黄昏,人物不动」
普通 AI:人物也跟着变了,背景改了个寂寞。
GPT Image 2.5:更认指令,只改你说的,其余尽量原封不动。
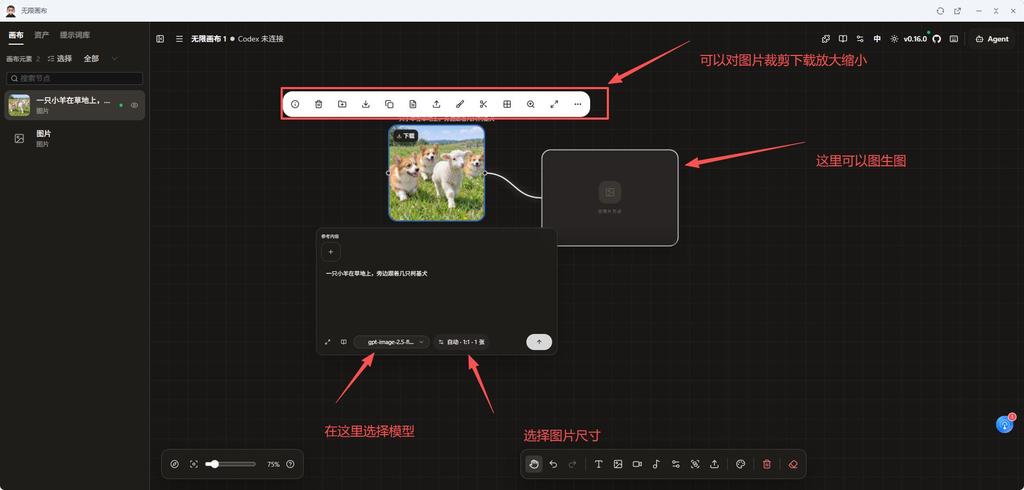
这一版还把画幅从「写在提示词里碰运气」改成了面板选项:
比例:1:1 / 3:4 / 4:3 / 16:9 / 9:16 / 21:9 分辨率:1K / 2K / 4K(越高越清晰,也越慢) 出图质量按高画质走,不用你再猜参数 竖版短视频封面、横版海报、超宽氛围图,选好再点生成。任务列表能看到创建时间和耗时,不用猜它死没死。
数据说话 公开竞技场(Arena,2026 年 9 月快照,部分成绩为初步统计):
对比维度 GPT Image 2.5 上一代 Image 2 文生图公开榜 系列位居最前 已被 2.5 超越 2.5 文生图评分 约 1399–1421 约 1381 单图编辑评分 约 1491–1520 约 1461 人像赛道 2.5 位居第一 落后 2.5 中文文字与复杂指令 明显强于上一代 能用,但更易跑偏 业内共识:2.5 不是小修小补,是在 2.0 已经很强的文字、指令、一致性上再抬一档。
适合场景:
电商产品图、模特换装图 社交媒体内容配图 IP 角色设计与多场景延展 海报、封面、营销物料 短剧分镜、漫剧草稿、剧照风格图