满血全能_海螺MinMax-H3全功能版
全能视频&最佳视觉_海螺 MinMax H3 全功能 - 短视频版 48g版
运行环境
短剧公司&工作室 量大优惠 找我私聊
👑全能视频&最佳视觉&即梦平替 48G版 (支持API接入,找我要SKILL) 微信:henryhan1117
MiniMax H3 全能参考 短视频版本
效果视频预览: https://ycnvr5heebo2.feishu.cn/wiki/IB7ywsxx1ibZVfke9W9cOzVBnBg
🔥 重磅更新:让创意更好拍,让作品更出彩!
- 🎬 画面细节再升级:人物、发丝、服装、材质与光影细节增强,让近景更耐看、镜头更有质感。
- ✍️ 提示词双模式,新手和高手都好用:新手用“智能转写”,直接描述创意;高手用“自定义”,按自己的专业提示词直接生成。
- 🧠 智能提示词助手:帮你整理人物、素材、台词、动作和镜头关系;可选生成前逻辑检查,提前发现明显矛盾。
- 🧊 新增视频转白模,喜欢的动作变成自己的参考:弱、中、强三档可选,转完自动入资产库,下次创作直接引用!
- 🔍 满意的成片,继续提升到1K/2K:历史作品、资产库或上传视频都能选,支持单个或批量处理,保留原片与声音,另存高清版本。
- 🖼️ 参考素材看得见,上传选片更直观:图片缩略图、视频与音频预览,一张张、一段段看清楚,支持替换、移除和换位。
- 🎨 11款内置LoRA,画风与动作随你挑:写实人物、复古赛璐珞、像素动画、黏土手塑、武术动作……把同一个创意拍出不同味道。
- 🧩 你的LoRA,也能成为镜像的一部分:上传、命名、检查、启用,再到生成页面选择,把你的风格预设放进自己的创作台。
- 📋 生成、白模、超分,一个队列统一管理:连续投递、自动排队,总体进度看得见,完成结果在历史作品中统一预览、下载。
🎥 三模式一站出片|全能参考+文生视频+首尾帧,横屏竖屏都能拍,单条最长15秒
🔊 五种声音方式自由选|音画同生、音色参考、保留原声、关闭音频、独立配音;先听配音、逐句试听,选好再生成!
⚡ 三档画质自由选|🚀 快速档 ⚖️ 标准档 💎 专业档
🖥️ 多分辨率可选|最高960P成片,满意后还能继续做1K/2K超分
💻 开箱即用|专业可视化Web界面,无需配置复杂工作流
🤝 个人&团队合作 📱 微信:henryhan1117
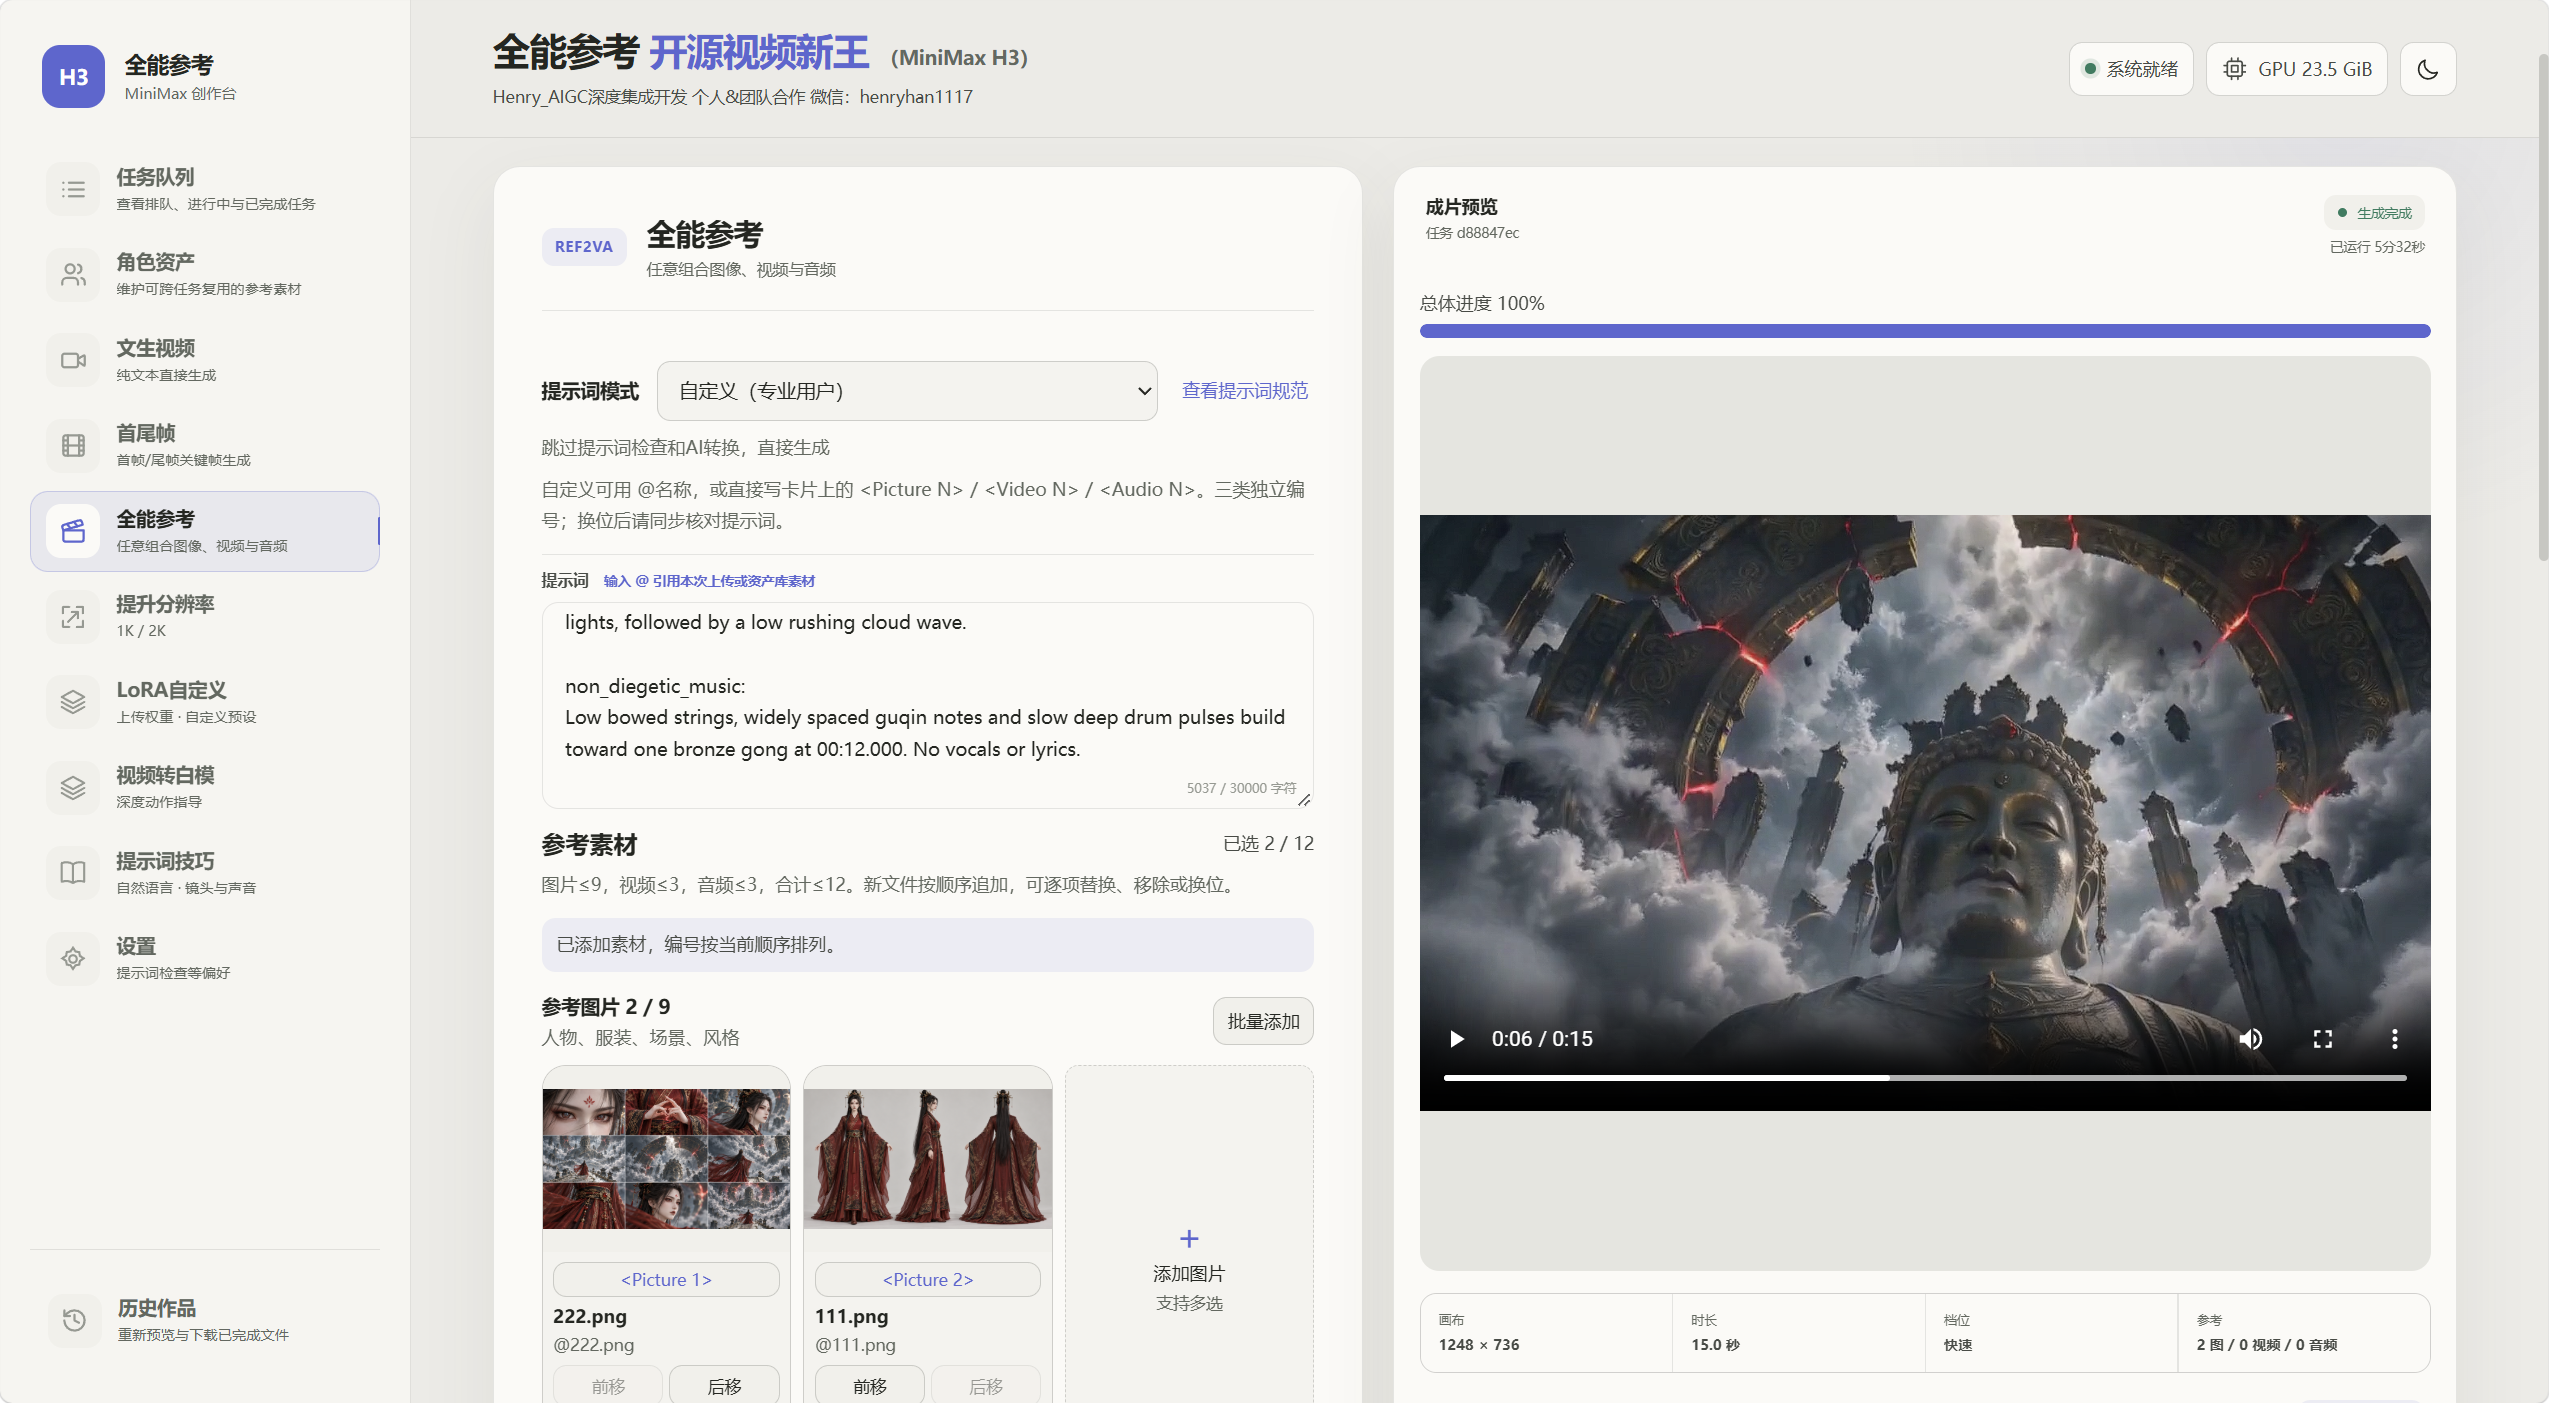
🎨 支持自定义LoRA|让你的风格,留在创作台里
让LoRA变成你的“风格工具箱”
不只选择镜像给你的效果,也能把你自己的风格带进来。
可以把LoRA理解成一套可选择的风格或动作预设:有的影响画风,有的偏向人物质感,有的关注运镜或动作。它不替代剧情描述,你仍要说明“拍什么”。
1. 先试内置的11个方向
| 名称 | 一句话用途 |
|---|---|
| 动画微动作 | 微表情、发丝、衣摆与环境轻运动,适合细腻动画表演 |
| 低多边形3D | 复古低多边形、平面着色与游戏感三维画面 |
| 空间接触 | 接触、碰撞和空间关系方向,适合明确的手部或道具互动 |
| 自然运镜 | 跟拍、后退、弧线移动等镜头变化,固定机位可不选 |
| 写实人物 | 自然肤质、人物表情与日常写实质感方向 |
| 复古赛璐珞 | 老式手绘动画、怀旧背景与平涂色块 |
| 武术动作 | 拳腿发力、套路和收招,适合动作明确的短片段 |
| 16位像素 | 像素块、阶梯轮廓与有限色板,适合复古游戏动画 |
| 粗线手绘 | 松弛粗线、二维卡通插画与涂鸦感人物 |
| 游戏CG视角 | 游戏过场、肩后跟拍等游戏感镜头 |
| 黏土手塑 | 手捏橡皮泥质感与柔和灯光,适合可爱角色和小故事 |
在生成页找到 “风格与动作”,打开 “选择风格或动作”,按名称搜索或分类选择,再确认 “使用所选”。
按你想要的画风和动作来选。第一次建议先选一个方向,配合自己的剧情和镜头描述试拍,再逐步尝试组合。
2. 自定义上传:把你的LoRA放进镜像
流程:选择文件 → 填名称与用途 → 检查并启用 → 在生成页选择。
- 进入左侧 “LoRA自定义”。
- 点击 “+ 上传LoRA”,选择你有使用权、兼容H3的
.safetensorsLoRA文件,单文件不超过4GB。 - 填写 功能名称、用途说明、分类。名称就是以后在生成页搜索到的名字,建议让人一看就明白。
- 按作者说明设置 默认强度与触发词;没有特殊要求时,不必乱填,保留合理默认值即可。
- 点击 “上传、检查并启用”,等待检查结果。
- 保存成功后,回到文生视频、首尾帧或全能参考页,在 “风格与动作” 中选择它。仅在支持该LoRA的模式里使用,以页面兼容提示为准。
- 先生成一个5秒小样,看风格、动作和人物表现是否符合预期,再用于正式内容。
示例配置可以这样写:
| 字段 | 示例 |
|---|---|
| 功能名称 | 我的暖色卡通 |
| 用途说明 | 温暖色块、简洁轮廓,适合单人表情与轻动作动画 |
| 分类 | 画风 |
| 默认强度 | 优先作者推荐;没有建议时可先保留界面默认0.6 |
| 触发词 | 作者要求才填写;没有要求就留空 |
| 来源/说明链接 | 可选,保存作者发布页,方便自己查阅 |
**注意:这是上传和管理LoRA,不是训练LoRA。**其他模型的LoRA、完整大模型文件或脚本,不能因为扩展名相同就直接使用。
3. “强度”是什么?
强度就是 这个LoRA影响画面的程度,不是清晰度分数。
- 0表示不使用。
- 先用作者推荐值或界面默认值。
- 觉得风格太重、服装或人物变化太大,可以降低一点。
- 想加强效果,可以小幅调整,但不是越高越好。
**第一次建议只选一个LoRA。**确认这个效果有用后,再尝试少量组合。页面支持多选,但不建议一上来就把所有风格叠满。
4. “触发词”必须填吗?从哪里找?
不是每个LoRA都需要触发词,也不是“没有触发词就完全无效”。
**选择LoRA负责启用它;触发词是部分作者指定的效果提示。**去作者发布页找 Trigger words/Activation prompt/触发词,自己训练的则查看训练说明。
作者没有要求,可以留空;有要求,就原样填写。**填好后,系统会自动补入生成描述,不需要你每次手写;不要把触发词写进人物对白。**不要自己随便编一个词当开关。
5. 上传成功却没看到?
检查是否已经 启用,以及是否支持当前生成模式,再重新打开选择器或刷新页面。检查通过说明文件具备可用条件,不等于这个LoRA必然适合你的剧情或风格。
想暂时不用,可在“LoRA自定义”里停用;之后需要时再启用。修改配置不会改变已经提交的任务或已经生成的作品。
适用:MiniMax H3 全能参考短视频镜像 · 48G版 新手直接用中文描述创意,熟悉专业提示词的用户可以切换自定义模式。下面按页面操作,一步步开始创作。
一、镜像简介
MiniMax-H3 全能参考镜像是一套面向视频创作者的可视化生成工具。你可以把图片、视频和音频作为参考素材,自由组合人物、外观、动作、镜头、场景、音色、对白和环境声音,生成带画面与声音的短视频。
它适合以下创作方向:
- 人物口播、产品介绍与直播带货;
- 双人或多人剧情、短剧对白;
- 固定角色形象连续创作;
- 参考视频的动作、表演、运镜和节奏;
- 参考声音生成新台词;
- 保留独立上传音频中的原始声音内容;
- 广告片、情绪短片、动漫短片和电影感镜头;
- 图片、视频、音频联合控制的复杂创作。
当前镜像支持:
- 横屏或竖屏输出;
- 最长 15 秒视频;
- 角色资产保存与重复调用;
- 历史作品预览、检索和批量下载;
- 智能转写与自定义两种提示词模式;
- 视频转白模,完成后自动保存为可复用资产;
- 历史作品、资产库与上传视频的1K/2K超分;
- 图片最多9个、视频最多3个、音频最多3个,混合合计最多12个。
二、最简单的使用流程
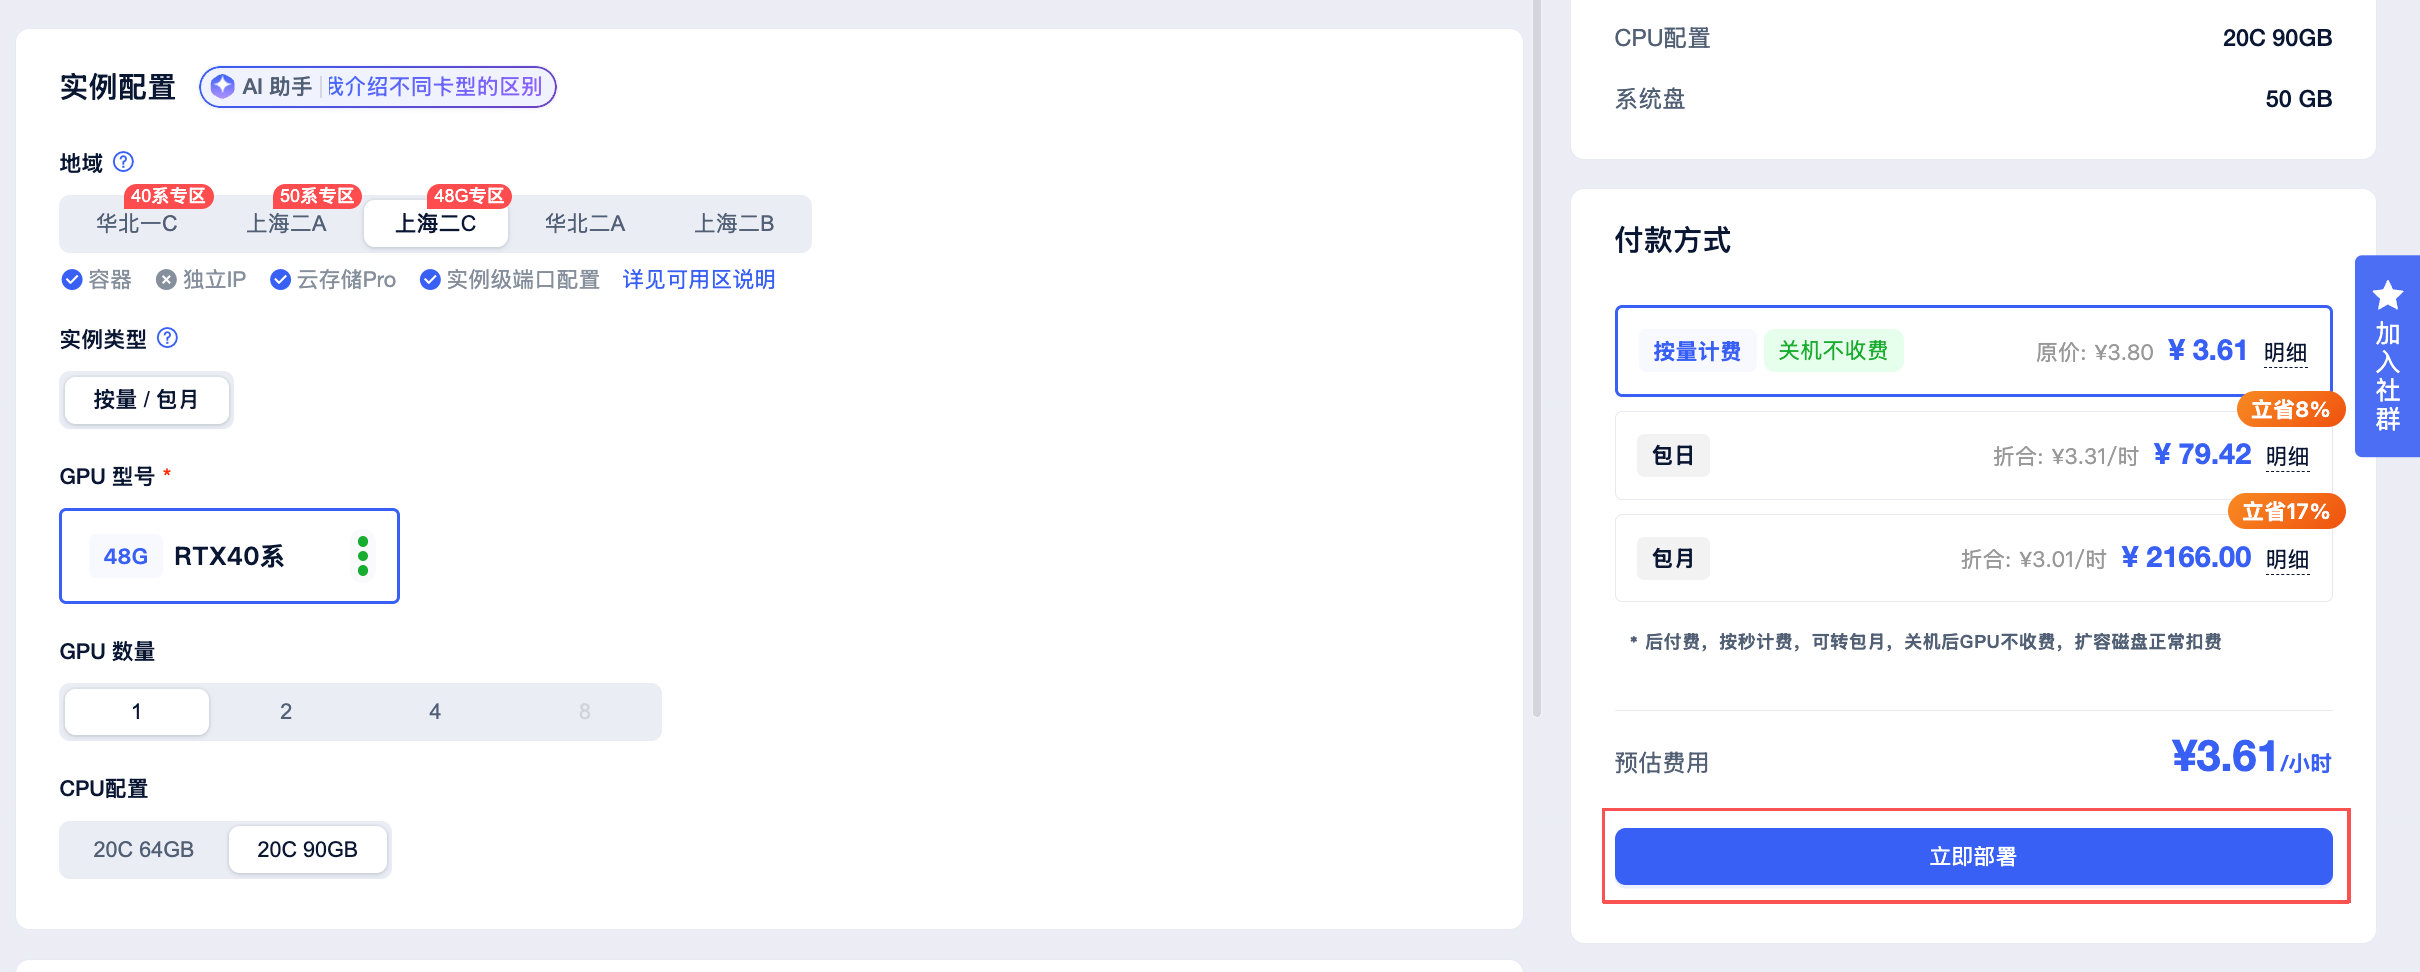
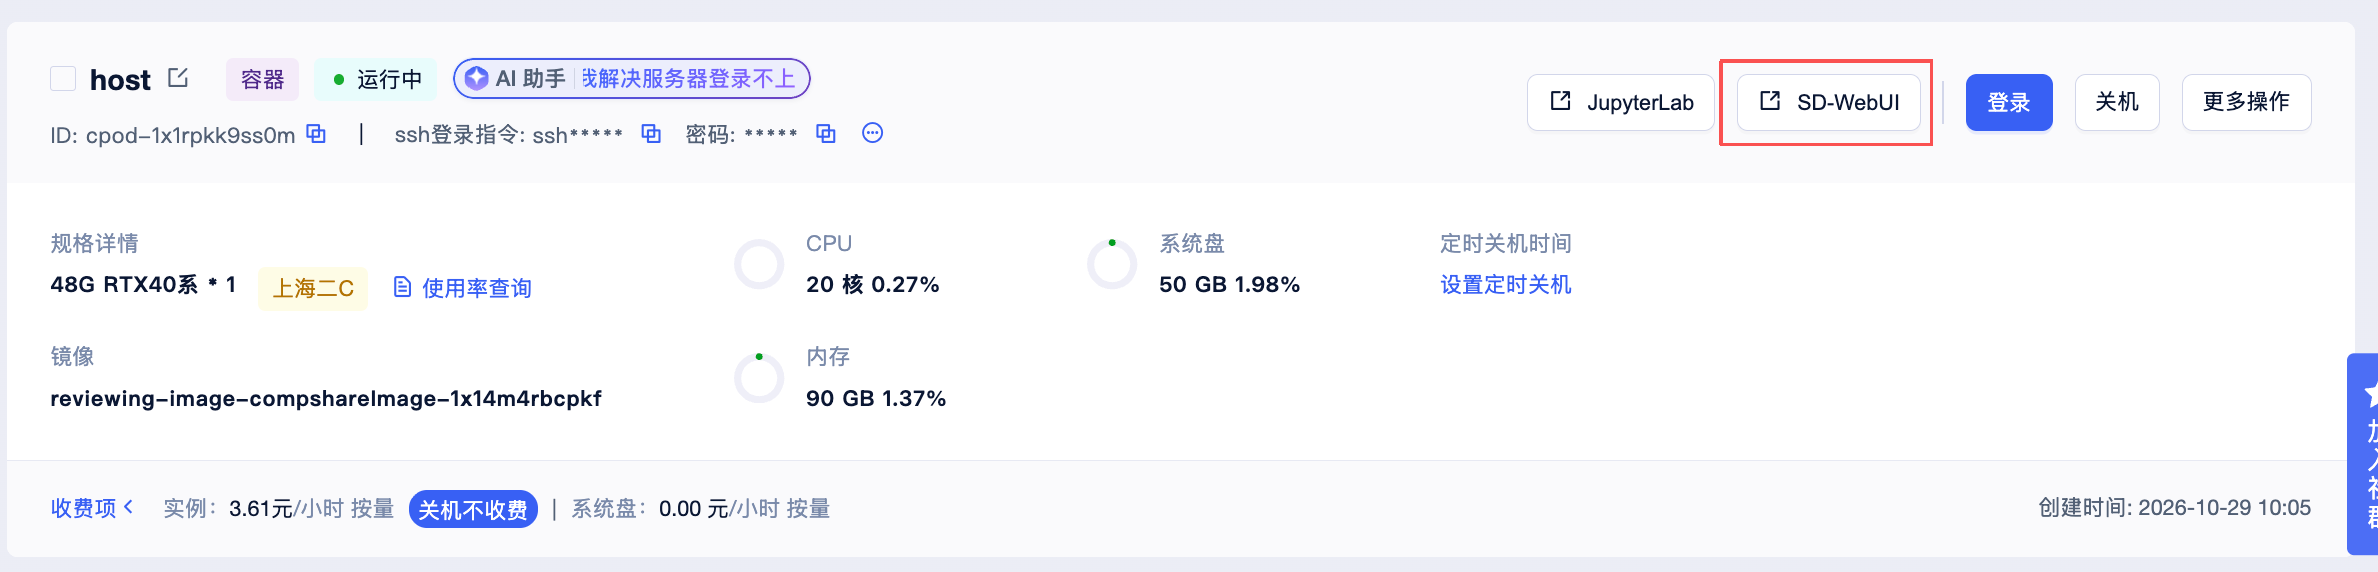
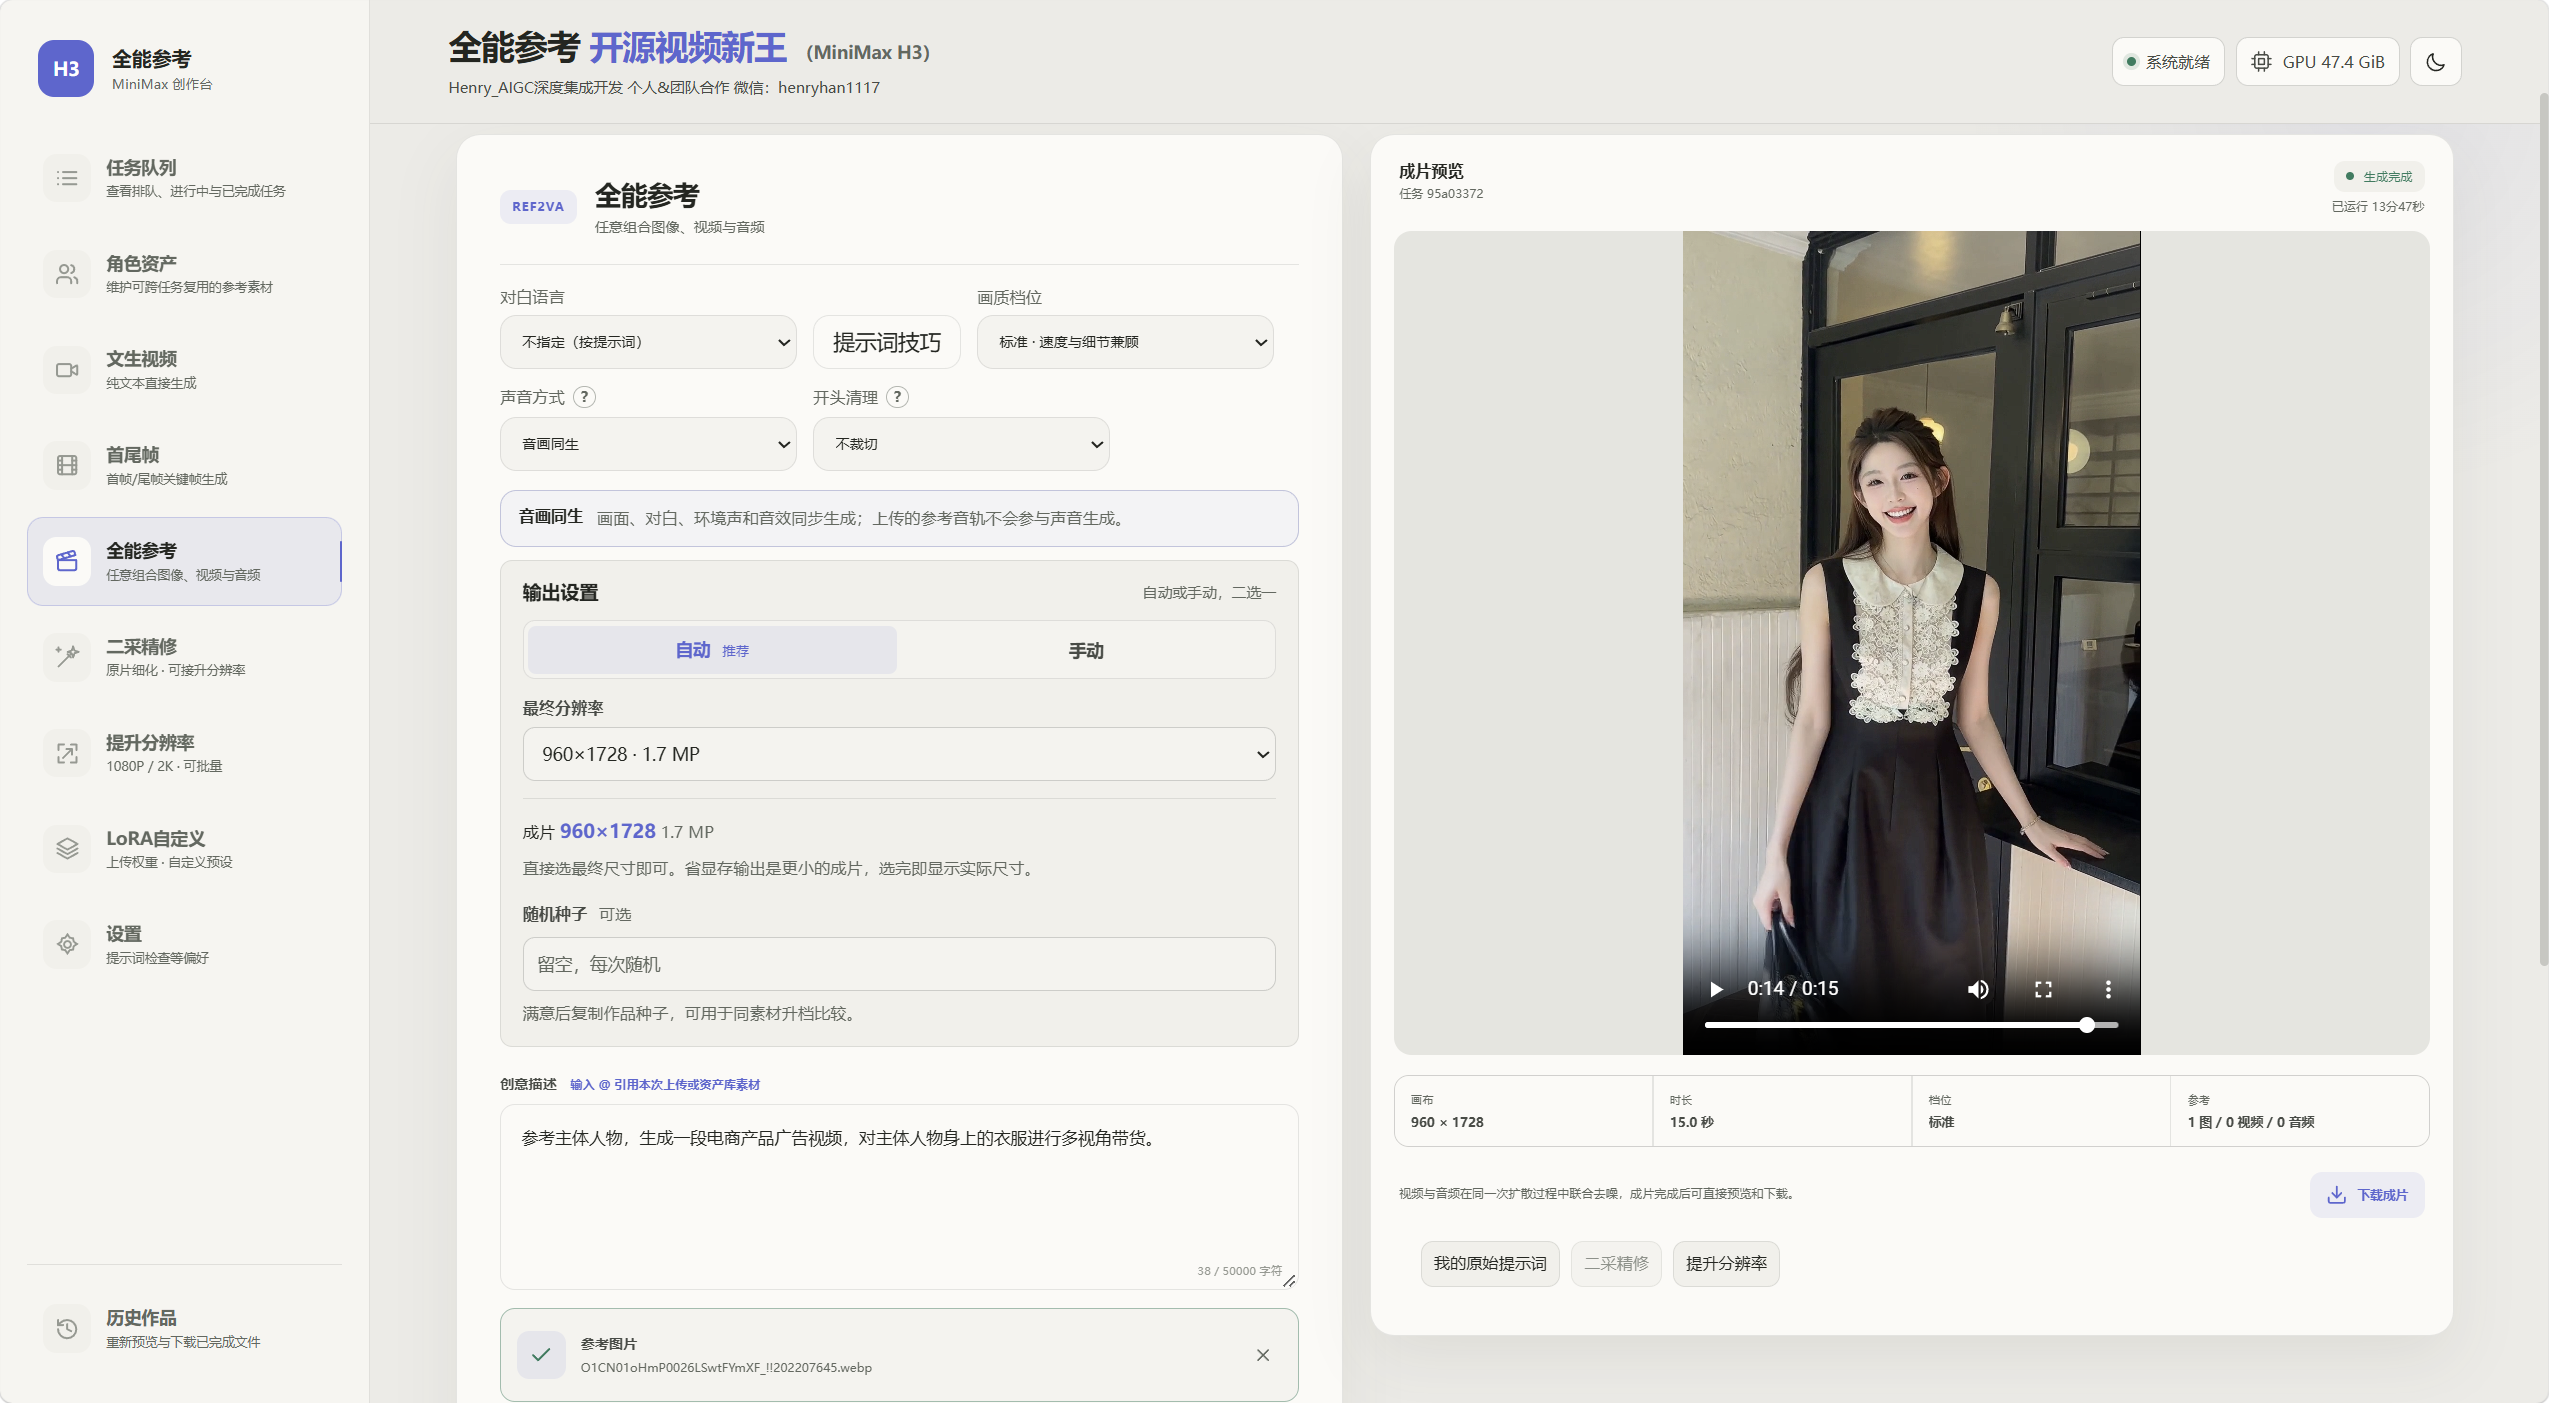
- 按素材选择“全能参考”“文生视频”或“首尾帧”。
- 新手选择“智能转写”;已经准备好H3专业提示词,可选择“自定义”。
- 上传参考素材,在卡片中预览,确认选对了图片、视频和音频。
- 在提示词中说明每个素材分别参考什么,谁做什么、谁说什么。
- 选择横屏或竖屏、视频时长、画质、最终尺寸和声音方式。
- 点击开始生成,到“任务队列”查看排队状态和总体进度。
- 完成后在预览区或“历史作品”观看、下载,也可以继续超分。
常用的角色、产品、场景或声音,建议先保存到“角色资产”。下次输入 @资产名 就能继续用,连续创作更省事。
智能转写,还是自定义?
| 提示词模式 | 怎么用 |
|---|---|
| 智能转写 | 用自然语言写创意,助手帮你整理成适合生成的提示词,适合大多数创作者 |
| 自定义(专业用户) | 跳过提示词检查和AI转换,直接使用你写好的H3专业提示词,适合希望自己掌控内容的用户 |
- 智能转写最多输入10000字符;自定义最多输入30000字符。
- 两种模式都建议尽量控制在7000字符以内,重点写清楚,减少重复堆砌。超过建议长度会提示,仍可选择继续生成。
- 可以在设置中打开“提示词检查”,让助手先找一找原稿中明显的逻辑矛盾;建议由你决定是否采纳。自定义模式跳过这一步。
- “提示词技巧”里可以查看自然语言建议、预览专业规范,并下载MD文件。
自定义同样支持 @名称,也可以直接写素材卡片上的 <Picture N>、<Video N>、<Audio N>。三类分别编号;素材换位后,请同步核对提示词。自定义模式的对白语言按你专业稿中的写法执行。
画质和尺寸怎么选?
快速档适合试创意,标准档适合日常创作,专业档适合更在意画面细节的成片。建议先做小样,满意后再提高档位。
| 成片档位 | 横屏 | 竖屏 |
|---|---|---|
| 0.9 MP | 1248×736 | 736×1248 |
| 1.1 MP | 1408×768 | 768×1408 |
| 1.3 MP | 1536×864 | 864×1536 |
| 1.7 MP/960P | 1728×960 | 960×1728 |
三、素材越多,生成时间越长
参考素材的数量和复杂度会直接影响生成时间。
- 从少量必要素材开始,更方便确认人物与镜头效果;
- 加入音频参考后,需要同时考虑台词、语气和声音节奏;
- 加入视频参考后,动作、镜头和场景信息更多,等待时间可能增加;
- 多人物、多视频、多音频联合参考,需要处理更多人物与素材关系,等待时间会进一步增加;
- 视频越长、分辨率越高、画质档位越高,通常需要更多等待时间。
推荐采用逐步测试的方法:
- 先用 1 张人物图测试短视频;
- 人物效果正确后,再加入 1 个音频或 1 个视频;
- 最后再增加第二个角色、更多参考素材和更长时长。
不要第一次就同时上传大量图片、视频和音频。素材过多不仅会增加等待时间,也可能让人物关系和参考目标变得不够清晰。
四、图片、视频和音频分别能参考什么
1. 参考图片
图片可以用于参考:
- 人物身份、脸型、五官、发型、肤色和年龄感;
- 服装、妆容、饰品和产品外观;
- 建筑、房间、直播间和其他场景;
- 构图、色调、灯光和美术风格。
推荐写法:
@女主用于锁定女主的脸型、五官、发型、肤色和年龄感。全片保持同一人物,允许根据新场景改变姿势和光线,不允许变脸或改变发型。
不要只写“参考这张图”。请明确哪些特征必须保留,哪些内容可以改变。
2. 参考视频
视频可以用于参考:
- 人物动作和身体姿态;
- 表演节奏与情绪变化;
- 镜头构图、景别、运镜和剪辑节奏;
- 人物站位、互动方式和场景氛围。
视频参考最好采用“保留什么+不要什么”的写法:
@动作视频只参考人物动作、表演节奏、镜头推进和构图。不要参考原视频中的人物身份、脸、服装、字幕、水印和原场景。
视频主要用来参考画面。需要保留的声音请单独上传音频,并选择“保留原声”;参考音色、生成新台词时,选择“音色参考”。
3. 参考音频
音频常见有两种用法。上传之后,要在页面选择对应的声音方式,再写清楚用途。
只参考音色,生成新台词
@主播音色只用于参考女主播的音色、年龄感、语速、气息、情绪力度和发音习惯。不要复制参考音频原来的台词。
保留独立音频中的原始声音内容
完整保留@原声音频中的台词、音色、呼吸、停顿、情绪和声音节奏,不要改写或增加台词。
“保留原声”请使用不超过15秒的独立音频,建议与目标视频时长对齐。不要对同一个音频同时要求“只参考音色”和“完整保留原话”。
五种声音方式怎么选?
| 声音方式 | 适合的需求 |
|---|---|
| 音画同生 | 直接描述剧情和台词,让画面、对白、环境声与音效一起生成 |
| 音色参考 | 参考一段声音的声线和质感,说你这次写的新台词 |
| 保留原声 | 使用独立上传的音频,保留你准备好的声音内容 |
| 关闭音频 | 先出无声画面,后期自己加对白、音乐或音效 |
| 独立配音 | 先听声音、逐句挑选满意的候选,再确认生成视频 |
独立配音在智能转写模式下使用,音色样本先存入资产库。支持配音方案查看、逐句试听和重新生成候选;需要平台账户授权,可能产生额外费用,重复试听生成也可能计费。
如果想让背景音乐与画面分开制作,可以先选择“关闭音频”,再后期自行配乐。
五、角色资产与 @ 引用
“角色资产”适合保存经常复用的素材,例如:
- 固定男女主角照片;
- 主播、数字人或品牌人物;
- 产品图片;
- 动作参考视频;
- 男声、女声或角色音色;
- 经常使用的场景参考。
保存资产时,建议使用容易理解的名称,例如:
女主
男主
科技主播
主播音色
愤怒表演
产品外观
未来直播间
在提示词中输入 @ 并选择资产,然后在开头定义一次用途:
@科技主播是本片唯一的主播人物参考,用于保持人物身份、脸型、五官、发型和服装一致。

@主播音色只参考主播的音色、语速、气息和直播表达风格,不复制原音频中的话。
智能转写时,先把素材用途说明白,后文可用“主播”“女主”“男主”等清楚的称呼。自定义专业稿请保持人物标签与素材编号前后一致,避免指向错误。
六、最推荐的提示词结构
想让创意更容易落地,提示词建议包含以下六类信息:
参考素材分别做什么
+ 想生成什么视频
+ 场景与画面风格
+ 每个时间段的动作和镜头
+ 谁准确说什么台词
+ 声音要求和禁止事项
1. 先定义素材用途
@女主用于保持女主身份和外貌一致。
@男主用于保持男主身份和外貌一致。
@动作视频只参考动作、表演、运镜和节奏,不参考原演员身份。
@女声音色只参考女主音色,不复制原台词。
2. 再说明成片目标
制作一段15秒横屏写实电影短片,内容是男女主在雨夜车站进行一次克制的告别。
3. 描述场景和风格
场景是深夜的旧式公交站。小雨持续落下,地面反射远处霓虹灯,冷蓝色调,浅景深,轻微胶片颗粒,真实电影摄影质感。
4. 按时间写动作和镜头
0–5秒:双人中景,女主站在站牌下,男主从雨中走近,镜头缓慢推进。
5–10秒:切到女主近景,她抬眼看向男主,先犹豫,随后压住情绪,说出自己的台词。
10–15秒:双人近景,男主回应,两人短暂对视,结尾停在女主转身离开的背影。
5. 明确说话人与准确台词
女主使用@女声音色,克制而失望地说:“我想听你亲口说。”
男主停顿片刻,低声回答:“好,这次不瞒你。”
台词建议使用中文引号,并明确“谁说、说什么、用什么语气”。如果没有台词,请写明“全片没有对白、旁白和人声”。
6. 最后写声音和限制
环境声包括雨声、远处车辆声和轻微衣料摩擦声。对白清晰,背景声音不能盖住人声。结尾淡入很轻的钢琴。

不要新增第三人,不要旁白,不要额外台词,不要字幕和水印。人物不能变脸、串脸、改变发型、年龄或服装;不要机械口型和突然跳切。
七、可直接复制的通用模板
【参考素材】
@人物图片用于锁定______的身份、脸型、五官、发型、肤色、年龄感和______。允许改变______,不允许改变______。

@参考视频只参考______、______和______;不要参考原视频中的人物身份、______和______。不要使用原视频声音。

@参考音色只参考______的音色、年龄感、语速、气息和情绪力度;不要复制音频原来的台词。

【成片目标】
制作一段______秒、横屏/竖屏、______风格的视频。核心内容是______。

【场景与风格】
时间是______,地点是______,光线是______。
整体采用______色调、______镜头质感、______景深和______构图。

【镜头与动作】
0–__秒:______景别,人物______,镜头______。
__–__秒:人物______,表情从______变化到______,镜头______。
__–__秒:______,结尾停留在______。

【台词】
角色A使用@参考音色,______地说:“______”
角色B______地回答:“______”
每句台词只说一次;说话前后保留自然呼吸和短暂停顿。

【声音】
环境声包括______;音效包括______;背景音乐______。
对白清晰,背景声音不能压过对白。

【限制】
不要新增角色,不要旁白,不要额外台词,不要字幕、乱码、水印或标志。
人物不能变脸、串脸、改变年龄、发型或服装;不要______。
八、完整示例:人物图片+主播音色
上传人物图和独立音频,或使用同名资产,选择**“智能转写+音色参考”**,再修改下面这份提示词:
@科技主播是本片唯一的人物和直播间参考。严格保持主播的脸型、五官、发型、肤色、年龄感、服装和整体人物辨识度,不能变脸或改变身份。

@主播音色只参考主播的音色、年龄感、语速、气息、情绪力度和直播表达风格,不复制参考音频中的原始台词、音乐或背景声。

制作一段15秒竖屏未来科技直播带货视频。

场景是深蓝紫色未来科技直播间,背景有弧形大屏幕、透明全息产品卡、流动灯带和轻微数据粒子。主播位于画面中央,神情自信亲切,具有专业直播带货的感染力。

0–4秒:主播面向镜头微笑,轻轻抬手向观众打招呼,镜头缓慢推进。

4–10秒:主播转向身旁的全息产品卡,用自然手势介绍图片、视频和音频三种参考能力。

10–15秒:主播重新看向镜头,抬手指向下方的体验按钮,最后保持自信微笑。

主播使用@主播音色,在4–10秒热情、清晰地说:“图片、视频、音频都能用。十五秒,把创意拍出来!”只说这一句。

台词口型自然同步,说完后闭上嘴,不要继续说话。直播间收音干净,背景加入低音量未来科技电子音乐和轻微界面提示音,但不能盖住口播。

不要新增人物,不要额外台词,不要旁白,不要生成底部对白字幕、乱码、水印或二维码。人物不能变脸,服装不能变化,不要机械口型、手指畸形或镜头跳切。
九、新增视频转白模:把喜欢的动作,变成下次创作的参考
看到一段动作想借鉴?转成白模,存成资产,再拿去创作!
进入 “视频转白模(深度动作指导)”,从历史作品、资产库视频中选择,或直接上传视频,就能制作近处更亮、远处更暗的灰度视频,方便参考动作、站位与空间层次。
| 强度 | 怎么选 |
|---|---|
| 弱 | 明暗对比直接,适合喜欢清楚前后层次的画面 |
| 中 | 兼顾层次与远景可见度 |
| 强(默认) | 尽量保留更多远处层次和人物轮廓 |
- 选择一个或多个视频。
- 选择弱、中、强,加入队列。
- 完成后到历史作品预览、下载。
- 结果自动保存为 “原名-白模” 视频资产,下次输入
@白模资产名即可继续引用。
单条视频最长30秒。保留源视频帧率与声音;输出会按比例适配尺寸。
参考写法:
@女主用于保持人物外貌和服装。
@舞蹈白模只参考身体动作、站位和节奏,不参考原人物外貌。
场景使用我描述的舞台,镜头保持全身可见。
十、满意的作品,继续提升到1K/2K
先把内容拍对,再让满意的画面更清晰!
进入 “提升分辨率”,可以直接选择历史作品、资产库视频或上传视频,支持多选排队处理。
- 1K:短边提升到1080像素。
- 2K:短边提升到1440像素。
- 保持原视频比例与帧率,保留原声音轨。
- 原片保留,高清版本另存,完成后在历史作品中查看和下载。
先选作品,再选档位,加入队列即可。较长、高帧率或较大尺寸的视频,需要更多处理时间。
十一、生成、白模、超分,一个队列管起来
想法可以连续提交,任务自动排好队。
- 视频生成、白模转换和提升分辨率同一时间执行一项,其余自动等待。
- 在任务队列查看总体进度与任务状态,完成结果统一进入历史作品。
- 历史作品支持重新预览、检索和下载,也能作为后续视频处理的来源。
- 图片、视频和音频用卡片预览,支持逐项替换、移除、调整顺序。
网络等待时,先查看队列中的任务编号,避免反复点击创建相同任务。
第一次建议从少量素材、5秒小样、快速或标准档开始。确认人物、构图和动作后,再增加素材、时长与画质档位。
十二、个人创作、团队协作,也能接入自己的工具
网页直接用,团队也能通过API接入!
支持把素材管理、视频生成、任务查询、成片下载、白模与超分接入自己的应用和批处理流程。
需要API接入文档、配套SKILL、仙宫云抢卡助手,或讨论个人&团队合作:
📱 微信:henryhan1117
默认加入无字幕要求,建议交付前检查人物、台词、口型与画面文字,按自己的创作目标选片。