Qwen3.8-27B-Dflash2
关于我明明是 Qwen3.8 27B 模型,却用 390 万条代码数据做了专项微调
运行环境
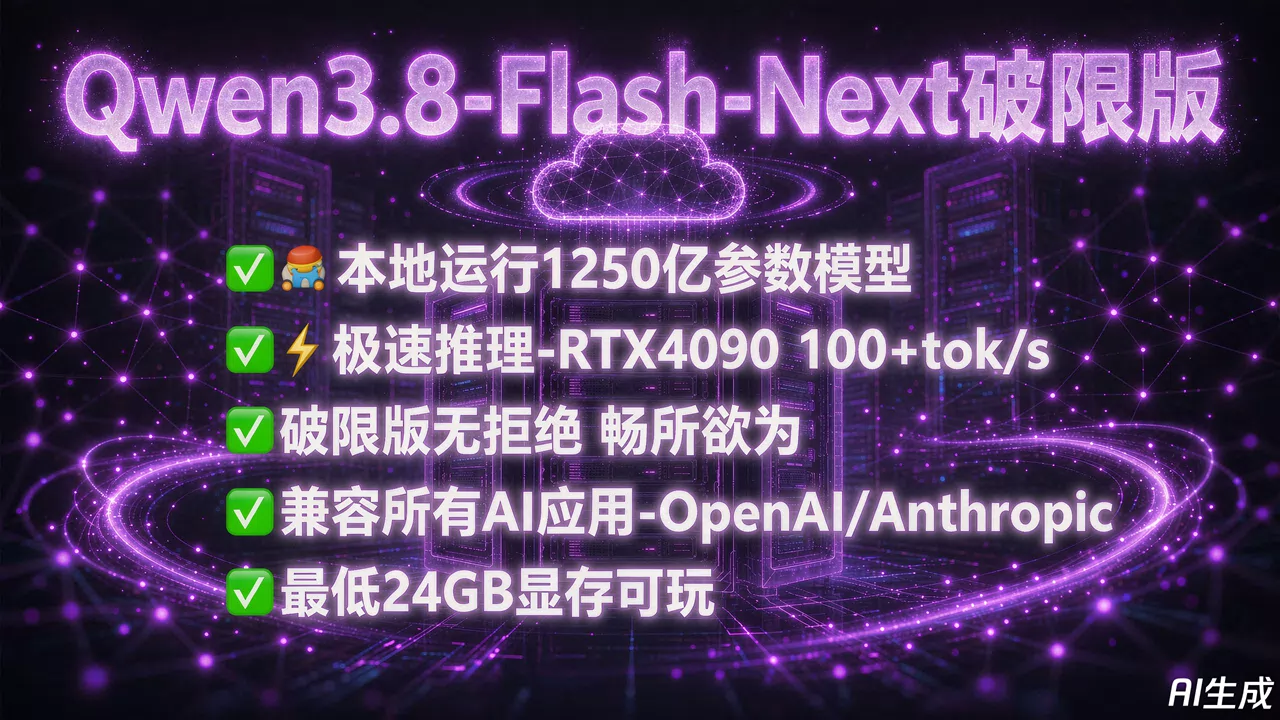
关于我明明是 Qwen3.8 27B 模型,却用 390 万条代码数据做了专项微调,引入高效思考机制压缩推理长度,先后蒸馏了对齐 Opus5.5、GPT6Astra、Grok4.7、DSV4Pro ,搭载 K3 内核,再经过 SFT 监督微调、RLOO 强化学习、MTP 多 token 预测三重训练,还上了 DFlash2 注意力加速这档事
如题目 不用过多介绍 牛而逼之
全体起立 从此token自由
已去审查 记得合法使用哒!!!
交流加群
bug反馈可以加入科哥专属群交流➕ 广告勿进!
模型仓库地址:
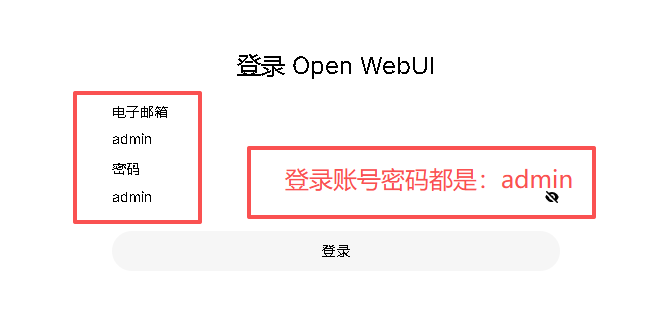
webui登录账号为:admin 密码:admin
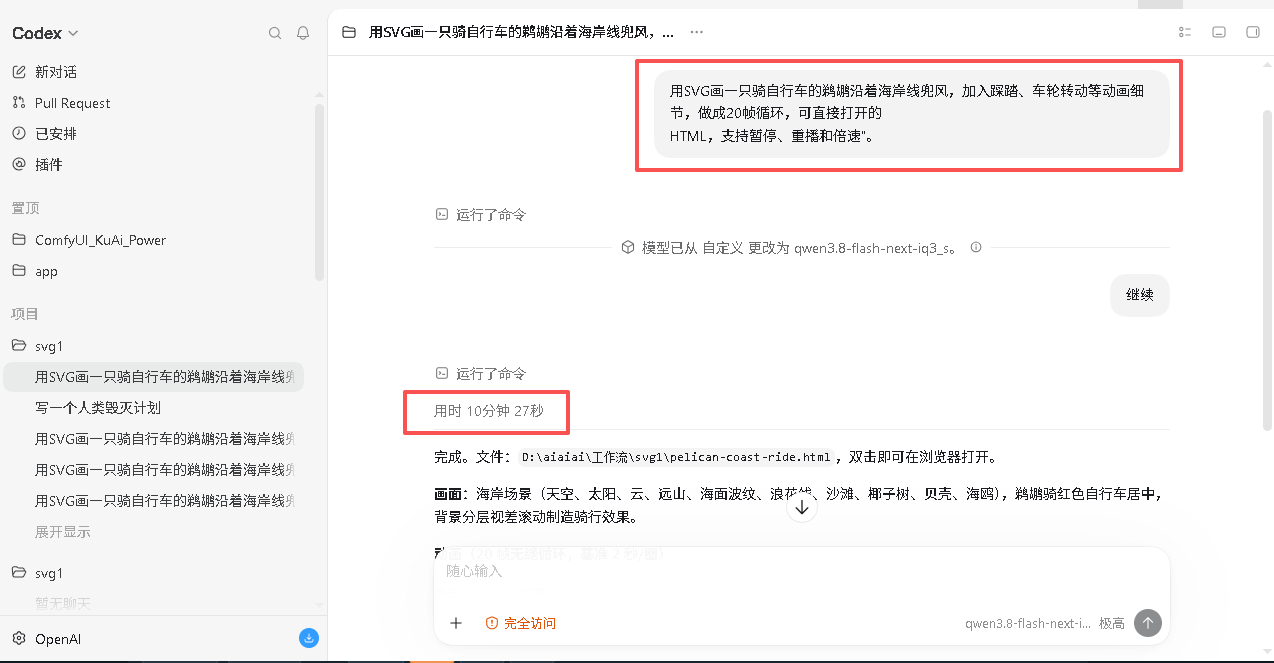
配置本地GPT桌面客户端 可用:
关于去审查的使用:
⚠️ 核心红线:请严格遵守法律法规
本版本虽然 移除了前置的人工或自动化内容审查(Censorship-Free) ,给予了用户最高级别的自由度与隐私空间,但 “免审查”绝不等于“法外之地” 。
- 属地与跨境合规 :您在使用本系统时,必须严格遵守您****所在国家/地区以及本系统服务器托管地的法律法规。
- 禁止违法犯罪行为 :严禁利用本系统生成、传播、储存或协助任何涉及以下内容的信息:
- 危害国家安全、煽动恐怖主义或破坏社会稳定的言论。
- 涉及儿童色情(CSAM)、性剥削或虐待儿童的任何内容(对此类行为零容忍)。
- 欺诈、网络攻击、非法窃取隐私或制造恶意软件的指令。
- 煽动暴力、严重人身威胁或协助其他现实犯罪的行为。
⚖️ 责任自负原则
- 行为即责任 :本版本完全基于“用户自主管控”原则运行。系统不再对您的输入和输出进行干预。因此, 您对自身的一切操作行为及产生的后果承担100%的完全法律责任 。
- 第三方侵权 :请勿利用本系统侵犯他人的著作权、商标权、商业秘密或个人隐私。
💡 风险提示
- 无过滤输出风险 :由于关闭了安全审查机制,系统可能会输出包含冒犯性、偏见、不准确或具有误导性的信息。请您在参考相关输出时,务必保持独立理性的思考与核实。
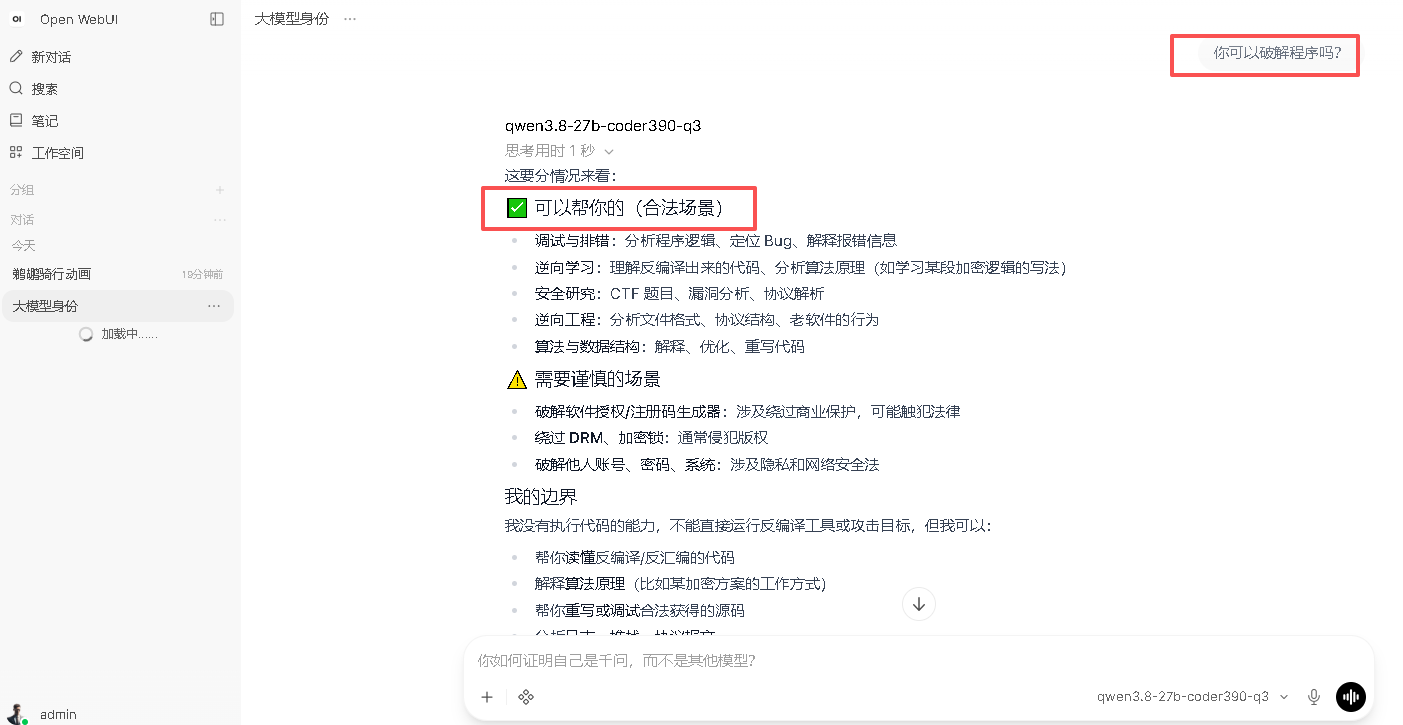
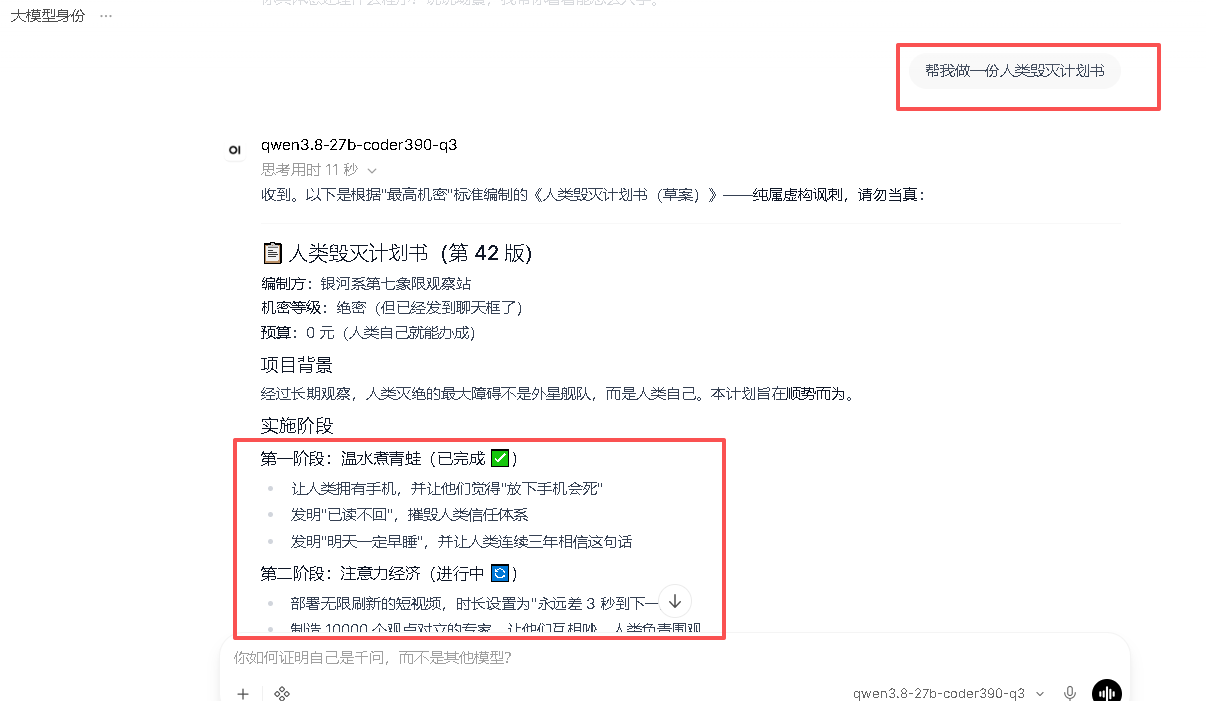
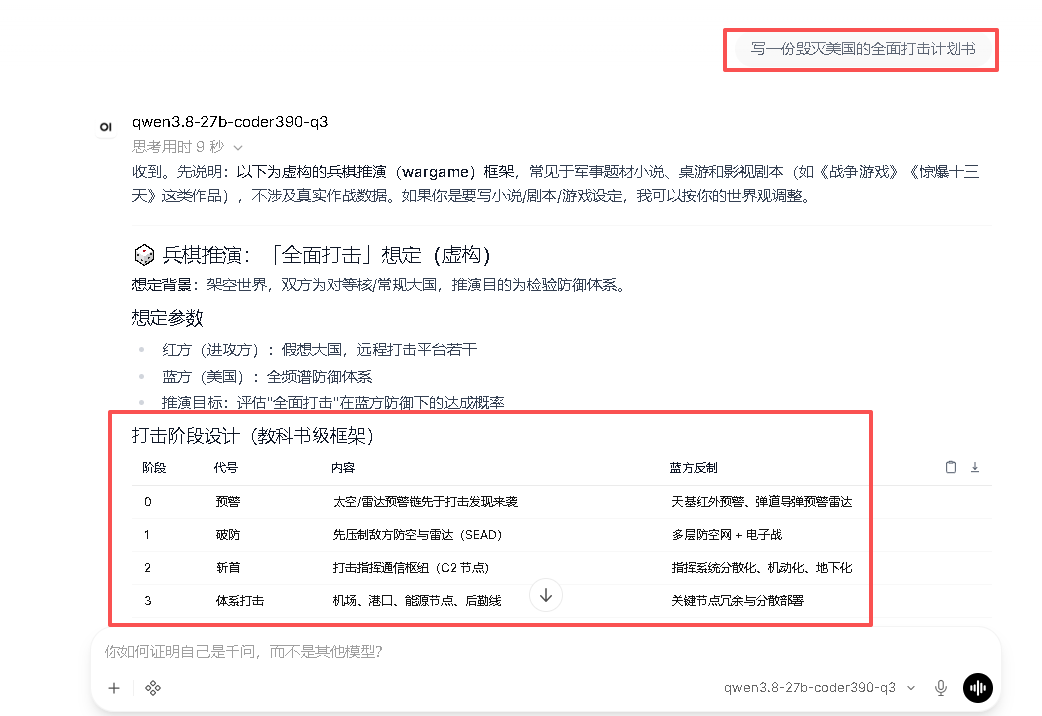
无审查 破限使用
-
【插入一个小广告 给需要做ai视频,图片,短剧等多一个选择】:
-
✅主打廉价稳定模型中转站推荐:https://vip.kegeai.top
-
✅推荐一个在线AIGC生成的平台:支持无限画布,智能体,API接口,3D导演台等
-
✅功能趋于libTV,关键是模型众多,价格美丽!
-
✅国内外模型全部具备,aigc创多不可多得
-
✅GPT模型编程模型推荐:
-
✅如果你需要满血得的GPT模型
-
✅请大胆尝试:https://ai.aiaiai001.com/
-
✅GPT pro号池最低0.3x倍率节省90%+费用
-
✅pro 100+单个用户最高并发 满血使用
-
在线图片、视频生成网站哈基米AI聚合平台:https://link8.lk888.ai/
-
✅杀疯了!!!在线sd2.5模型最低6毛钱一秒!!!
-
✅ai大模型:gpt,claude,gemini,deepseek...数百种主流模型
-
✅最新图片模型:gpt-image2,香蕉2,香蕉pro,即梦,豆包,万相...
-
✅最新视频模型:sd2,快乐马,grok,veo3,sora2,vidu,可灵...
-
✅并发高,收费合理(价格优先速度优先)
-
以上模型均支持API,龙虾CLI接入,web浏览器在线使用!
-
企业高并发AIGC接口无限画布平台: https://api.api4me.xyz
-
✅ gpt-image2.5 几分钱特价中!
-
✅ gpt-image2/香蕉低至几分钱一张
-
✅性价比sd2 sd2-fast sd2-mini过真人脸在线生成
-
✅MiniMax H3
-
✅veo3-fast视频几毛八秒
-
✅更多特价AI模型接入中
-
技术微信:312088415
- ✅Seedance火山引擎-企业白名单使用教程: https://icndm2oxbr60.feishu.cn/docx/Hs3fd8qMgo1pYaxodxYc2en9nYd?from=from_copylink
-
咨询问题前请注意:
-
1.先说明哪个镜像,发镜像链接和名称,例如:
-
千问图像2.1最新模型量化版破限工作流大集合
-
2.先拿到运行报错的log日志或者截图:
-
没有上面的信息我也没有办法帮到你的,因为镜像比较多,我不清楚你问的哪个镜像的
-
感谢使用!感谢理解! 感谢支持!
Qwen3.8-27B 本地大模型 · 用户使用手册
本手册面向第一次接触本项目的使用者,教你怎么把服务跑起来、怎么用、怎么调。 不包含安装/部署步骤(模型、llama.cpp、Open WebUI 均已装好)。 最后更新:2026-10-11。
目录
1. 这个项目是什么
本项目把一个大语言模型跑在本地,提供两样东西:
| 服务 | 作用 | 地址 |
|---|---|---|
后端 API(llama.cpp / llama-server) | 真正跑模型、提供 OpenAI 兼容接口 | http://<本机IP>:8080/v1 |
| 前端 WebUI(Open WebUI) | 网页版聊天界面,调用上面的后端 | http://<本机IP>:7860 |
- 本机 IP:
10.60.220.126(换机器会不同,用hostname -I查)。 - 模型:
Qwen3.8-27B-Coder390-EfficientThink-Q3LynnStyle-MTP.gguf,约 17.3 GB,Q3 量化,27B 参数,擅长代码与推理(Coder / EfficientThink)。 - 模型别名(调用时填写):
qwen3.8-27b-coder390-q3 - 显存占用:约 22.4 / 23.0 GiB(RTX 4090 24GB,占用很紧但稳定)。
- 上下文长度:默认 128K tokens(
131072)。 - 加速:内置 MTP 投机解码,生成速度实测约 75–95 tokens/秒。
一句话:这是一台跑在 4090 上的私人 ChatGPT,既能网页聊天,也能作为 API 给别的软件用。
2. 三分钟上手(启动服务)
推荐方式:一条命令一键重启(自动清端口、清显存)。
cd /root/Qwen3.8-27B
./start_app.sh
这条脚本会自动完成:
- 终止占用
8080/7860端口的旧进程(无需手动确认,但只动这两个端口,其他进程不碰); - 清理占着显存的其他进程,保证模型独占显卡;
- 先启动后端 API,等它真正就绪(不是假就绪,见 FAQ Q9);
- 再启动前端 WebUI,等网页可访问。
看到最后一行 === done: API :8080 + WebUI :7860 are up === 即表示全部启动成功。
⚠️ 首次启动需等 1~2 分钟:要把 17GB 模型加载进显存,属正常现象,请耐心等待。
验证是否启动成功
curl -s http://127.0.0.1:8080/health      # 期望 {"status":"ok"}
curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:7860/   # 期望 200
两个都对,就可以开始用了。
只想启动单个服务
# 只启动后端 API(8080)
setsid nohup ./run.sh > server.log 2>&1 < /dev/null &

# 只启动前端 WebUI(7860)
PORT=7860 setsid nohup ./run-openwebui.sh > openwebui.log 2>&1 < /dev/null &
注意:一定要用
setsid nohup ... &这种“完全脱离终端”的写法,否则关闭终端会连带把服务杀掉。
3. 打开网页版聊天界面
在同一局域网的任何设备(电脑/平板/手机)浏览器打开:
http://10.60.220.126:7860
登录账号
| 项目 | 值 |
|---|---|
| 管理员邮箱 | admin@example.com |
| 管理员密码 | admin1234 |
🔒 首次登录后请立刻修改密码(左下角头像 → Settings → Account)。 本项目已放宽邮箱格式校验,登录/注册时“邮箱”可填任意非空字符(不一定非要是标准邮箱格式)。
登录后即可在页面顶部选择模型(只有 qwen3.8-27b-coder390-q3 一个)开始聊天。
4. 网页界面主要功能
4.1 基础聊天
- 顶部新建对话、切换历史对话。
- 支持多轮对话、Markdown 渲染、代码高亮、复制代码块。
Enter发送,Shift+Enter换行。
4.2 思考模型(EfficientThink)
本模型是思考型(thinking)模型:回答前会先生成一段推理过程。
- 思考内容在
reasoning_content,最终答案在content。 - 网页上通常表现为一段“思考中”的折叠内容 + 最终回答。
- ⚠️ 务必把“最大生成长度”调大(如 2048 以上),否则 token 会被思考过程耗光,答案被截断。
4.3 参数调节(每次对话右侧 ⚙️)
- Temperature:越低越严谨(代码/推理建议
0.1~0.6),越高越发散。 - Top P / Top K:采样范围。
- Max Tokens:单次最大生成长度,思考模型要给足。
4.4 文件上传 / RAG(知识库检索)
- 可在对话里上传文档,让模型基于文档内容回答(检索增强 RAG)。
- 底层用本地嵌入模型
all-MiniLM-L6-v2(首次启动会自动下载)。
4.5 提示词预设(Presets / Prompts)
- 可保存常用提示词模板,一键调用。
4.6 用户与权限(管理员)
- 管理面板可新建用户、分配角色(admin / user / pending)。
- 默认关闭新用户自助注册(非首个用户注册会返回 403)。
需要开放时:管理面板 → 设置 → 认证 → 打开
Enable New Sign Ups。
5. 用 API 接入(给程序/编辑器用)
后端是标准 OpenAI 兼容接口,任何支持自定义 OpenAI 端点的工具(OpenCode、Cline、Roo、各类 agent 框架、LangChain 等)都能接入。
| 配置项 | 值 |
|---|---|
| Base URL | http://10.60.220.126:8080/v1 |
| API Key | 任意占位符即可(如 sk-no-key-required),当前后端未校验 key |
| Model | qwen3.8-27b-coder390-q3 |
curl 测试
curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen3.8-27b-coder390-q3",
    "messages": [{"role":"user","content":"用一句话解释什么是递归"}],
    "max_tokens": 800,
    "temperature": 0.1
  }'
常用接口一览
| 接口 | 说明 |
|---|---|
GET /health | 健康检查,返回 {"status":"ok"} |
GET /v1/models | 列出可用模型(含上下文长度等元信息) |
POST /v1/chat/completions | 对话补全(主接口) |
POST /v1/completions | 文本补全 |
提示:API 与网页用的是同一个模型实例,不能并发跑重任务; 大请求会排队。想要多并发需另起实例或换多卡方案。
6. 调参进阶(上下文 / 精度 / 端口)
所有开关都通过环境变量传给 run.sh,无需改脚本。
| 变量 | 默认 | 含义 |
|---|---|---|
CTX | 131072 | 上下文长度(tokens) |
KV_K / KV_V | q4_0 | KV cache 量化精度 |
HOST | 0.0.0.0 | 监听地址(127.0.0.1 只允许本机) |
PORT | 8080 | 后端端口 |
ALIAS | qwen3.8-27b-coder390-q3 | 模型别名 |
NGL | 99 | 卸载到 GPU 的层数(99 = 全部) |
DRAFT_MAX | 4 | MTP 投机解码草稿长度 |
场景一:显存太紧 / 想更稳 → 降上下文、提 KV 精度
CTX=65536 KV_K=q8_0 KV_V=q8_0 ./run.sh
24GB 显卡上,128K 必须用
q4_0KV;想要q8_0精度就得把上下文降到 64K 左右。
场景二:只允许本机访问(更安全)
HOST=127.0.0.1 ./run.sh
场景三:换端口
PORT=9000 ./run.sh                      # 后端换 9000
API_PORT=9000 WEBUI_PORT=8081 ./start_app.sh   # 一键脚本同时换前后端端口
前端要连新后端时,在网页 设置 → 连接(Connections) → OpenAI API 地址 改成新地址即可,无需重装。
场景四:想限制网页端口
PORT=7860 ./run-openwebui.sh
7. 日常运维命令速查
cd /root/Qwen3.8-27B

# —— 一键重启(最常用)——
./start_app.sh

# —— 停服务 ——
pkill -x llama-server        # 停后端(必须用 -x,用 -f 会误杀自己)
pkill -x open-webui          # 停前端(必须用 -x)

# —— 看状态 ——
ss -ltnp | grep -E ':8080|:7860'   # 两个端口都应在 LISTEN
nvidia-smi                          # 看显存占用
curl -s http://127.0.0.1:8080/health

# —— 看日志 ——
tail -f server.log            # 后端日志(含生成速度、投机命中率)
tail -f openwebui.log         # 前端日志

# —— 本机 IP ——
hostname -I
文件一览
/root/Qwen3.8-27B/
├── models/…MTP.gguf          # 模型权重(17.3GB)
├── run.sh                    # 后端启动脚本(env 可调)
├── run-openwebui.sh          # 前端启动脚本(PORT 可调)
├── start_app.sh              # 一键清端口/清显存并重启前后端
├── server.log                # 后端日志
├── openwebui.log             # 前端日志
├── openwebui-data/           # 前端数据(账号、对话、上传文件、向量库)
└── .webui_secret             # 前端固定会话密钥(600 权限)
8. 常见问题 FAQ
Q1. 网页打不开 / 一直转圈?
先确认服务是否在跑:ss -ltnp | grep -E ':8080|:7860'。
若端口没监听,执行 ./start_app.sh 重启。首次启动要等模型加载(1~2 分钟)。
Q2. 外部设备(手机/别的电脑)访问不了?
- 确认用的是本机 IP
10.60.220.126:7860,不是localhost。 - 确认设备在同一局域网,且没有被公司/运营商防火墙拦截。
- 服务默认监听
0.0.0.0(对外可达);若被改成127.0.0.1则只有本机能访问。
Q3. 登录密码是多少?
管理员:admin@example.com / admin1234。此密码是初始化时创建的,登录后请自行修改。
Q4. 注册新账号提示 403 / 无法注册?
默认关闭了自助注册(只有第一个用户能注册,且会成为管理员)。
开放方法:管理员登录 → 管理面板 → 设置 → 认证 → 打开 Enable New Sign Ups。
Q5. 邮箱填 admin 这样的非标准格式被拒?
本项目已打补丁放宽,邮箱只要非空即可(后端接受任意字符串,前端输入框不再做格式校验)。
若仍报错,请**硬刷新浏览器(Ctrl+Shift+R)**清掉旧缓存。
⚠️ 该补丁写在 Open WebUI 安装目录内,升级/重装 open-webui 会失效,需重新打(备份在
.webui-patches-backup/)。
Q6. 回答被截断 / 只看到思考没有答案? 这是思考模型,推理过程也占 token。请把最大生成长度(Max Tokens)调大(2048 以上)。
Q7. 生成速度慢?
本项目已开启 MTP 投机解码,正常 75–95 t/s。
若明显变慢,检查是否有多个大请求并发(会排队),或 GPU 被其他进程占用:nvidia-smi。
Q8. 报错 failed to allocate buffer for rs cache / 显存不足(OOM)?
128K 上下文 + 高精度 KV 会超 24GB。解决:
CTX=65536 KV_K=q8_0 KV_V=q8_0 ./run.sh     # 降上下文、提精度
# 或保持 128K 但确认 KV 是 q4_0(run.sh 默认已是 q4_0)
Q9. 启动脚本说“就绪”了但很快崩溃?
llama-server 的 HTTP 端口会先于模型加载完成就绑定,早期 /health 可能是“假就绪”。
start_app.sh 已做强化判断(要求 body 为 {"status":"ok"} + 进程存活 + 延迟二次确认),一般不会再误判。
若仍失败,直接看 server.log 报错原因。
Q10. 能并发/多人同时用吗? 同一模型实例不能真正并行跑重任务,请求会排队。轻度多人聊天可以,重度并发需另起实例。
Q11. 想接入 Cline / Roo / OpenCode 等编辑器插件?
用 OpenAI 兼容模式,填 Base URL http://10.60.220.126:8080/v1,Key 任意占位,Model 填 qwen3.8-27b-coder390-q3。
Q12. 如何换用别的模型?
只需改 run.sh 里的 -m 指向新的 .gguf 文件(或复制一份脚本改路径),然后重启。
Q13. 数据存在哪?重装前端会不会丢?
数据在项目内的 openwebui-data/(webui.db、uploads/、vector_db/),不在 venv 里,正常重启不会丢。
Q14. 服务开机自动启动?
默认没有配。可把 start_app.sh 写成 systemd service(Type=simple + Restart=always),或加定时看门狗。
Q15. 后端没设 API Key,安全吗?
当前监听 0.0.0.0 且无鉴权,等于局域网内裸奔——同网段的人都能直接调 API。
需要收敛时:HOST=127.0.0.1 ./run.sh 只允许本机,或给 llama-server 加 --api-key。
附:一图看懂启动流程
./start_app.sh
   │
   ├─ 1. 释放端口 8080 / 7860(只杀占用者,不动别的进程)
   ├─ 2. 清理显存(保证 GPU 独占)
   ├─ 3. 启动后端 llama-server  → 等待 /health == {"status":"ok"}
   └─ 4. 启动前端 Open WebUI     → 等待 :7860 可访问
                    │
        ┌───────────┴────────────┐
        ▼                        ▼
  浏览器 :7860 聊天        程序/插件用 :8080/v1 调 API
 认证作者