SGLang 源码推理开发环境
源码安装 SGLang 0.5.22,提供 Qwen 文本与视觉模型启动配置、OpenAI 兼容接口示例及 GPU 选型说明。
运行环境
这台镜像能做什么
镜像里已经从源码安装 SGLang v0.5.22,源码在 /workspace/sglang,运行环境叫 sgl。它可以把本地模型变成 OpenAI 兼容接口,供聊天、代码生成和视觉语言任务调用。
模型权重放在 /model 挂载盘,不包含在镜像文件里。GPU 显存决定模型能不能启动:先用 0.6B 走通流程,再按机器显存升级模型尺寸,别一上来就让 32B 和显存较劲。
本机模型菜单
下面列的是这台实例 /model/ModelScope/Qwen 下已有的代表模型,按用途分组。模型族的支持情况依据 SGLang v0.5.22 源码和官方模型说明;同一模型族的不同量化格式、权重改版和硬件组合仍可能有差异。表格列的是模型目录,不保证每个尺寸都能装进当前 GPU。
| 类型 | 本机模型目录(相对 /model/ModelScope/Qwen/) |
|---|---|
| 轻量聊天 | Qwen2.5-0.5B-Instruct、Qwen3-0.6B |
| 通用聊天 | Qwen2.5-3B-Instruct、Qwen2.5-7B-Instruct、Qwen3-4B、Qwen3-8B、Qwen3-14B、Qwen3-32B |
| 量化聊天 | Qwen2.5-14B-Instruct-GPTQ-Int4、Qwen3-32B-FP8 |
| 代码 | Qwen2.5-Coder-7B-Instruct、Qwen3-Coder-30B-A3B-Instruct、Qwen3-Coder-30B-A3B-Instruct-FP8 |
| 看图问答(VL) | Qwen2.5-VL-3B-Instruct、Qwen3-VL-4B-Instruct、Qwen3-VL-8B-Instruct、Qwen3-VL-30B-A3B-Instruct、Qwen3-VL-32B-Instruct、Qwen3-VL-32B-Thinking、Qwen3-VL-32B-Thinking-FP8 |
| 多模态(Omni) | Qwen2.5-Omni-7B、Qwen3-Omni-30B-A3B-Instruct |
| Qwen3.5 | Qwen3.5-0.8B、Qwen3.5-9B、Qwen3.5-27B、Qwen3.5-27B-FP8、Qwen3.5-35B-A3B、Qwen3.5-35B-A3B-FP8 |
| Qwen3.6 | Qwen3.6-27B、Qwen3.6-35B-A3B-FP8 |
| Qwen3.8 | Qwen3.8-27B、Qwen3.8-27B-FP8 |
已列出 30 多个本机模型目录。 想看挂载盘上的完整目录(有时模型名比奶茶配料还长):
ls -1 /model/ModelScope/Qwen
SGLang v0.5.22 已包含 Qwen3.5 模型实现;Qwen3.8-Flash-Next 的官方部署说明要求 v0.5.20 或更新版本,因此该版本满足最低版本要求。Qwen3.6 及各类量化权重的支持会受具体 checkpoint、GPU 后端和量化格式影响,建议先用小流量启动验证。Qwen3-Omni 在 SGLang 中属于多模态工作流,音频输入输出等完整语音能力请优先看本镜像的 SGLang-Omni 指南。
完整支持信息可查看 SGLang 多模态模型列表、Qwen3.8-Flash-Next 部署说明 和 v0.5.22 发布说明。
5 分钟启动:Qwen3-0.6B
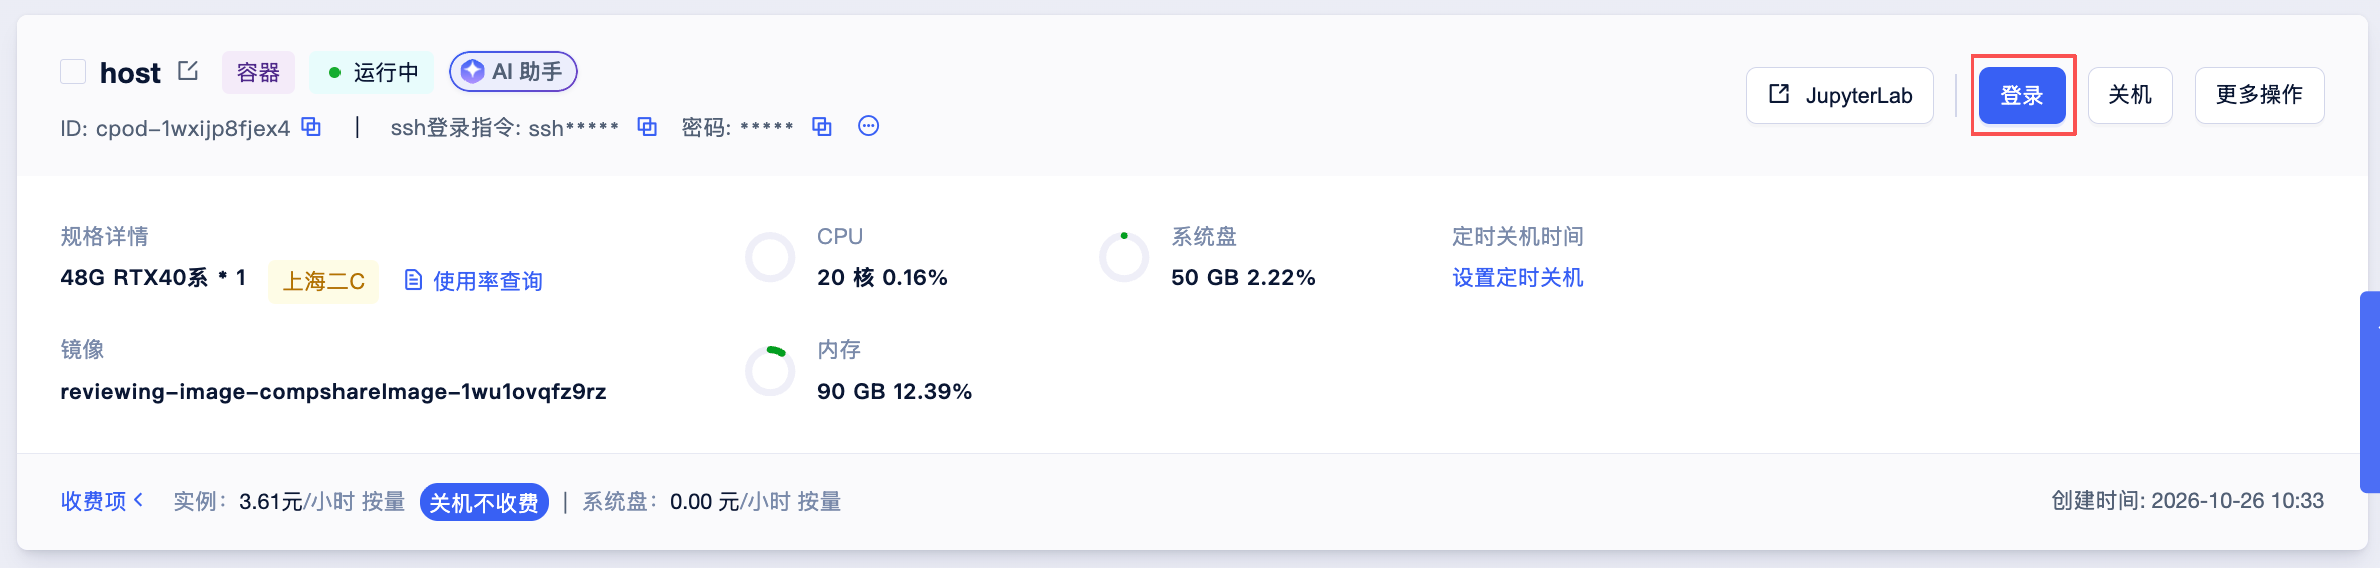
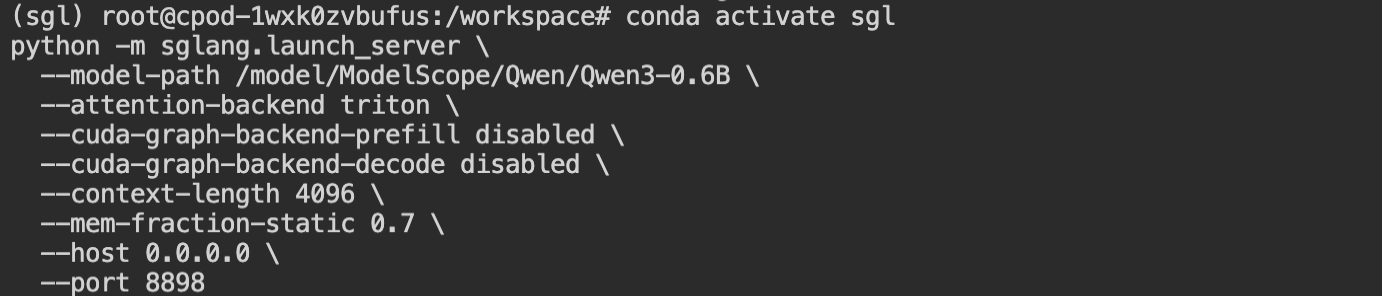
先从轻量模型确认环境、挂载盘和服务端口都正常。登录实例后运行:
conda activate sgl
python -m sglang.launch_server \
  --model-path /model/ModelScope/Qwen/Qwen3-0.6B \
  --attention-backend triton \
  --cuda-graph-backend-prefill disabled \
  --cuda-graph-backend-decode disabled \
  --context-length 4096 \
  --mem-fraction-static 0.7 \
  --host 0.0.0.0 \
  --port 8898
第一次启动要等权重加载和服务初始化。看到服务就绪后,另开一个终端检查模型列表:
curl http://127.0.0.1:8898/v1/models
发出第一条请求
curl http://127.0.0.1:8898/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "/model/ModelScope/Qwen/Qwen3-0.6B",
    "messages": [
      {"role": "user", "content": "你好,请介绍一下你自己。"}
    ],
    "temperature": 0.7,
    "max_tokens": 256,
    "stream": false
  }'
如果想看文字像打字一样逐步出现,把 stream 改为 true,并给 curl 加 -N:
curl -N http://127.0.0.1:8898/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "/model/ModelScope/Qwen/Qwen3-0.6B",
    "messages": [{"role": "user", "content": "用三句话介绍杭州。"}],
    "stream": true
  }'
model 字段要和启动时的模型路径一致。要切换模型,先停止服务,再同时更换启动参数和请求里的模型名。
想试大一点的模型?
多卡时可用 --tp 设置张量并行数,例如给 32B 模型分配两张 GPU:
conda activate sgl
python -m sglang.launch_server \
  --model-path /model/ModelScope/Qwen/Qwen3-32B \
  --tp 2 \
  --host 0.0.0.0 \
  --port 8898
--tp 2 要求实例确实分配了两张可用 GPU。启动显存不足时,先换小尺寸或量化权重;具体可用规模取决于 GPU 显存、上下文长度和并发设置。
常用小抄
- 看 GPU 和显存:
nvidia-smi - 看模型目录:
ls -1 /model/ModelScope/Qwen - 看服务是否在线:
curl http://127.0.0.1:8898/v1/models - 停止服务:回到启动服务的终端按
Ctrl+C
祝推理顺利,愿显存条常绿、首 token 不迟到。
按场景继续
- 视觉理解应用指南
- OCR 文字识别应用指南
GPU、显存与兼容范围
本次仅实测 nvidia-smi 显示为 RTX 4090、49140 MiB 显存的实例(Ada,SM89)。这是平台提供的48GB实例,不能直接将结果套到通常24GB的零售4090。日期:2026-10-23。
“文档架构支持但未实测”仅表示该架构属于软件栈目标范围;“有条件支持”需要核对具体型号、精度、后端和显存。以下状态不代表所有模型均能运行。
| 平台选卡项 | 架构和状态 | 限制 |
|---|---|---|
| RTX40系 48GB | 仅本次RTX4090实例有实测结果 | 其他40系48GB型号未测;以本指南的场景结果为准 |
| RTX40系 24GB | 有条件支持,未实测 | 核实完整型号与SM;不能按系列泛称或显存判断全部兼容 |
| RTX50系 32GB | 有条件支持,未实测 | 例如RTX5090为Blackwell/SM120;需确认具体型号及各CUDA、Triton、FlashInfer算子兼容 |
| RTX3080 Ti 12GB | Ampere/SM86,有条件支持,未实测 | 可尝试小文本模型;4B VL和1.7B TTS需进一步控制显存,8B图片任务不推荐 |
| RTX3090 24GB | Ampere/SM86,文档架构支持但未实测 | 可用BF16;图片任务24GB不保证,其他场景按各自显存建议 |
| RTX2080 8GB | Turing/SM75,不支持本指南默认BF16方案 | 无原生BF16;需另建FP16兼容方案验证算子和显存,当前镜像不作即用承诺 |
| A800 80GB | Ampere/SM80,文档架构支持但未实测 | BF16路径;量化和优化后端仍需按模型验证 |
| H20 96GB | Hopper/SM90,文档架构支持但未实测 | BF16路径;FP8等额外方案未测 |
| A100 80GB | Ampere/SM80,文档架构支持但未实测 | BF16路径;不能据此宣称所有量化算子均兼容 |
| P40 24GB | Pascal/SM61,不支持当前CUDA13方案 | CUDA13已移除对应离线编译与库支持,需另建旧CUDA环境 |
| V100S 32GB | Volta/SM70,不支持当前CUDA13方案 | CUDA13已移除该架构支持,且无原生BF16,需另建旧CUDA/FP16环境 |
软件基线:Python 3.12、SGLang 0.5.22、SGLang-Omni 0.1.9、PyTorch 2.14.1+cu130、Transformers 5.19.0,PyTorch运行库CUDA13.0。本次驱动为610.57.04;其他实例必须使用与实际CUDA13.x运行库匹配的驱动,不能认为所有13.x都只需同一个最低驱动版本。
本次按BF16模型做单请求冒烟,未验证FP8、NVFP4、GPTQ、AWQ或GGUF权重。文本和VL/OCR使用Triton attention、4096上下文,并关闭prefill/decode CUDA图;完整默认优化组合不计入通过范围。TTS默认融合算子在SM89上曾要求114688字节共享内存,超过101376字节硬件上限,已通过兼容配置复测(启用确定性推理、关闭相关CUDA图);默认融合优化仍不计入通过范围。
资料:NVIDIA计算能力、历史GPU计算能力、CUDA13架构与驱动限制。
本场景结果及显存建议:文本服务已通过。最低显存尚未实测;0.6B模型建议8GB起步、16GB以上更稳妥。 所列起步和推荐值为选型估计,不能视作已测最低显存。