SGLang-Omni 多模态开发环境
源码安装 SGLang-Omni,预装语音与图像生成依赖,提供模型配置、兼容启动参数和 API 示例。
运行环境
这台镜像能做什么
SGLang-Omni 是镜像里的多模态服务框架,源码位于 /workspace/sglang-omni,当前分支为 wes/sensenova-umm-adapter,与 SGLang v0.5.22 配套。它用配置把模型和处理阶段连接成一个可调用的服务。本镜像中已经整理好的工作流包括 Qwen3-TTS 语音生成,以及 SenseNova-U1.5 文生图和图片编辑。
模型权重位于 /model 挂载盘,不随镜像复制。服务启动时要同时指定模型目录和对应的流水线配置。模型文件存在不代表 Omni 已有可用配置;目前能按本镜像示例直接启动的工作流见下表。
本机已配置的工作流
| 能力 | 模型 | 配置文件 |
|---|---|---|
| 预设音色语音生成 | Qwen3-TTS-12Hz-1.7B-CustomVoice | examples/configs/qwen3_tts_1_7b_customvoice.yaml |
| 轻量语音生成 | Qwen3-TTS-12Hz-0.6B-CustomVoice | examples/configs/qwen3_tts_0_6b_customvoice.yaml |
| 参考音频语音生成 | Qwen3-TTS-12Hz-1.7B-Base | examples/configs/qwen3_tts_1_7b.yaml |
| 描述音色语音生成 | Qwen3-TTS-12Hz-1.7B-VoiceDesign | examples/configs/qwen3_tts_1_7b_voicedesign.yaml |
| 文生图、图片编辑 | SenseNova-U1.5-8B-MoT | 当前分支内置集成示例 |
Qwen-Image、FLUX、CosyVoice、Fish Speech、IndexTTS 等目录也在挂载盘中,但当前分支没有为它们准备本镜像的一键配置。扩展这些工作流前,需要确认模型兼容性并完成相应流水线配置。
启动服务的通用方式
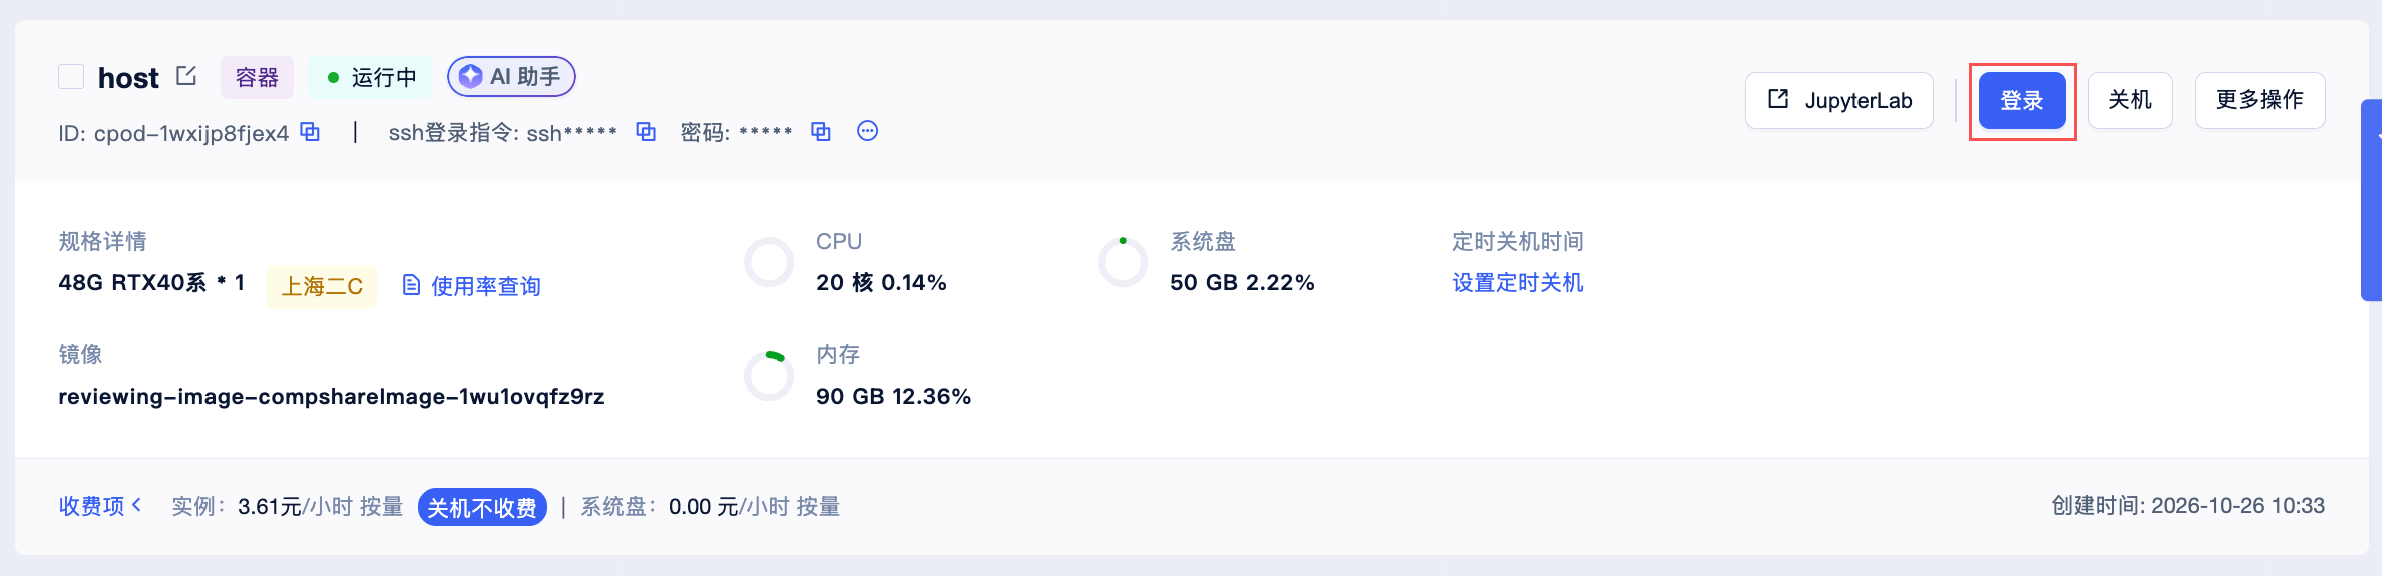
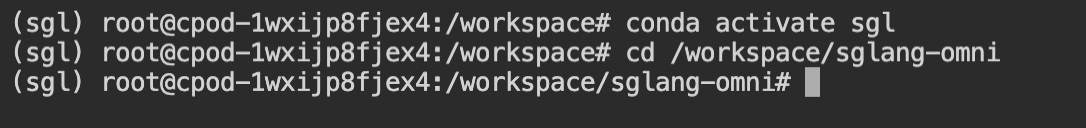
登录实例后进入环境和 Omni 源码目录,再使用匹配的模型路径与配置文件启动:
conda activate sgl
cd /workspace/sglang-omni
python -m sglang_omni.cli serve \
  --model-path /model/模型目录 \
  --config examples/configs/对应工作流.yaml \
  --host 0.0.0.0 \
  --port 8000
模型目录 和 对应工作流.yaml 必须配对。实际可复制的启动命令在各场景指南中;图片生成示例还指定了生成阶段使用的 GPU。默认端口为 8000,同时运行多个服务时请改用不同端口。
另开终端查看服务状态和已加载模型:
curl http://127.0.0.1:8000/health
curl http://127.0.0.1:8000/v1/models
镜像环境与注意事项
- 使用 Conda 环境
sgl。启动服务前确认模型挂载正常:ls /model/ModelScope/Qwen。 - 查看 GPU 显存:
nvidia-smi。能否运行取决于实际分配的 GPU、显存和生成分辨率。 - Qwen3-TTS 所需的
qwen-tts==0.1.1、SoX、einops、SoundFile、librosa 等依赖已装入sgl环境,直接按语音生成应用指南启动即可。 - 图片服务和语音服务通常分别启动;停止服务可在其终端按
Ctrl+C。
按场景继续
- 语音生成应用指南
- 图像生成应用指南
本框架使用 OpenAI 风格接口,也有语音合成、图像生成等专用端点。每个场景指南都给出对应的启动命令和完整请求报文。
GPU、显存与兼容范围
本次仅实测 nvidia-smi 显示为 RTX 4090、49140 MiB 显存的实例(Ada,SM89)。这是平台提供的48GB实例,不能直接将结果套到通常24GB的零售4090。日期:2026-10-23。
“文档架构支持但未实测”仅表示该架构属于软件栈目标范围;“有条件支持”需要核对具体型号、精度、后端和显存。以下状态不代表所有模型均能运行。
| 平台选卡项 | 架构和状态 | 限制 |
|---|---|---|
| RTX40系 48GB | 仅本次RTX4090实例有实测结果 | 其他40系48GB型号未测;以本指南的场景结果为准 |
| RTX40系 24GB | 有条件支持,未实测 | 核实完整型号与SM;不能按系列泛称或显存判断全部兼容 |
| RTX50系 32GB | 有条件支持,未实测 | 例如RTX5090为Blackwell/SM120;需确认具体型号及各CUDA、Triton、FlashInfer算子兼容 |
| RTX3080 Ti 12GB | Ampere/SM86,有条件支持,未实测 | 可尝试小文本模型;4B VL和1.7B TTS需进一步控制显存,8B图片任务不推荐 |
| RTX3090 24GB | Ampere/SM86,文档架构支持但未实测 | 可用BF16;图片任务24GB不保证,其他场景按各自显存建议 |
| RTX2080 8GB | Turing/SM75,不支持本指南默认BF16方案 | 无原生BF16;需另建FP16兼容方案验证算子和显存,当前镜像不作即用承诺 |
| A800 80GB | Ampere/SM80,文档架构支持但未实测 | BF16路径;量化和优化后端仍需按模型验证 |
| H20 96GB | Hopper/SM90,文档架构支持但未实测 | BF16路径;FP8等额外方案未测 |
| A100 80GB | Ampere/SM80,文档架构支持但未实测 | BF16路径;不能据此宣称所有量化算子均兼容 |
| P40 24GB | Pascal/SM61,不支持当前CUDA13方案 | CUDA13已移除对应离线编译与库支持,需另建旧CUDA环境 |
| V100S 32GB | Volta/SM70,不支持当前CUDA13方案 | CUDA13已移除该架构支持,且无原生BF16,需另建旧CUDA/FP16环境 |
软件基线:Python 3.12、SGLang 0.5.22、SGLang-Omni 0.1.9、PyTorch 2.14.1+cu130、Transformers 5.19.0,PyTorch运行库CUDA13.0。本次驱动为610.57.04;其他实例必须使用与实际CUDA13.x运行库匹配的驱动,不能认为所有13.x都只需同一个最低驱动版本。
本次按BF16模型做单请求冒烟,未验证FP8、NVFP4、GPTQ、AWQ或GGUF权重。文本和VL/OCR使用Triton attention、4096上下文,并关闭prefill/decode CUDA图;完整默认优化组合不计入通过范围。TTS默认融合算子在SM89上曾要求114688字节共享内存,超过101376字节硬件上限,已通过兼容配置复测(启用确定性推理、关闭相关CUDA图);默认融合优化仍不计入通过范围。
资料:NVIDIA计算能力、历史GPU计算能力、CUDA13架构与驱动限制。
本场景结果及显存建议:图片与语音服务均已通过最小请求;语音需采用场景指南中的4090兼容参数。最低显存未实测;语音建议12GB起步、24GB推荐,图片建议32GB起步、48GB推荐。 所列起步和推荐值为选型估计,不能视作已测最低显存。