Comfyui AI漫剧生成机
装好就能用的 ComfyUI,不用装环境、不用下模型。图片能直接变视频,做了 4 步加速,图片10秒生成,一条 5 秒片约 1 分钟,中文提示词直接写。
运行环境
ComfyUI 漫剧出片机 v1.0
FLUX 出图 + Wan2.1 图生视频(4 步加速)
免配置、免装模型,开机就能出图出片。
一、镜像介绍
这是一个装好就能用的 ComfyUI 镜像。不用折腾 Python 环境、不用装依赖、不用下模型。
和同类镜像最大的不同:图生视频已经做了 4 步蒸馏加速。Wan2.1 I2V 14B 原生要跑 20-30 步,一条 5 秒视频要 4-5 分钟;这个镜像预装了 LightX2V 的四步蒸馏 LoRA,把步数压到 4 步,实测 81 帧 / 832×480 约 57 秒一条,速度快 5 倍左右。
镜像里预置了两条生成链路:
- FLUX.1 Dev —— 文生图,1024×576 横屏,适合短剧场景图
- Wan2.1 I2V 14B —— 图生视频,上传首帧即可让画面动起来
所有模型都是实体文件打包进镜像,不是软链接,不会出现"打开发现模型没了"的情况。全部使用官方原生节点,没有第三方自定义节点,不会满屏报红。
适合:做竖屏短剧、漫剧分镜、年代剧场景的创作者,以及需要日更量产的小团队。
一个熟练工的实际用法:一集 100 秒的片子,23 张场景图 + 6-8 个动作镜头,图生视频只跑动作镜头,其余用剪辑软件做运镜,一集出片成本能压在十几分钟机时内。
二、功能特性
一句话:同样一条 5 秒视频,别人 4 分钟,你 1 分钟
| 场景 | 普通 ComfyUI 环境 | 本镜像 |
|---|---|---|
| 一条 5 秒图生视频 | 4-5 分钟 | 约 57 秒 |
| 一集 8 个动作镜头 | 约 35 分钟 | 约 8 分钟 |
| 一天出 5 集 | 基本不可能 | 可以 |
差距不在显卡,在步数。Wan2.1 I2V 14B 原生要跑 20-30 步;本镜像预装 LightX2V 四步蒸馏 LoRA,把 20-30 步压到 4 步,画质在动画风格下几乎看不出差别,速度直接快 5 倍。
四个真正的优势
1. 快 —— 4 步出片,日更不再是体力活
- 蒸馏 LoRA 已挂好,不需要你自己去 HF 找、去下、去接线
steps 4/cfg 1.0是蒸馏模型的黄金参数,镜像里已经调好- 视频 81 帧约 57 秒,比原生快 5 倍,一集成本从半小时降到几分钟
2. 稳 —— 模型是实体文件,不是软链接
- 同类镜像常见坑:镜像里只是软链接,开机后模型"消失"
- 这里 FLUX、Wan I2V、文本编码器、VAE 全部实体打包,打开就在
- 全原生节点,零第三方插件,不会满屏报红、不会因为某个插件更新而崩
3. 省 —— 49G,不是 128G
- Wan 的 CLIP Vision 参考通道完整保留,人物长相在长镜头里更稳
- 镜像体积小 → 部署快、系统盘占用少、迁移便宜
- 同类镜像动辄 128G,要求 150G 系统盘;这里 80G 就够
4. 顺 —— 为横屏短剧调过参数
- 出图默认 16:9 横屏 1024×576,正好嵌进横屏剧的画面区
- 出视频默认 832×480,是 480p 模型的最佳工作点,再高只会变慢不变好
- 支持中文提示词(Wan 链路用 umt5_xxl),不用先翻成英文
- 可以传配音,直接输出带音轨的 mp4,省一次合成
适合谁
- 日更短剧团队:一集 6-8 个动作镜头,10 分钟出完,其余镜头用静图 + 运镜
- 漫剧创作者:先出图定人物,再挑几个关键镜头动起来,成本可控
- 预算敏感的个人:24G 卡就能跑,不用上 48G
- 不想折腾环境的人:开机即用,不写一行配置
⚠️ 重要:本镜像不带文生视频(T2V),也不带超分/放大模型。视频原生是 480p,投平台前需要用 ffmpeg 拉到 1080×608,详见「常见问题」。
三、使用教程
步骤 1:创建实例
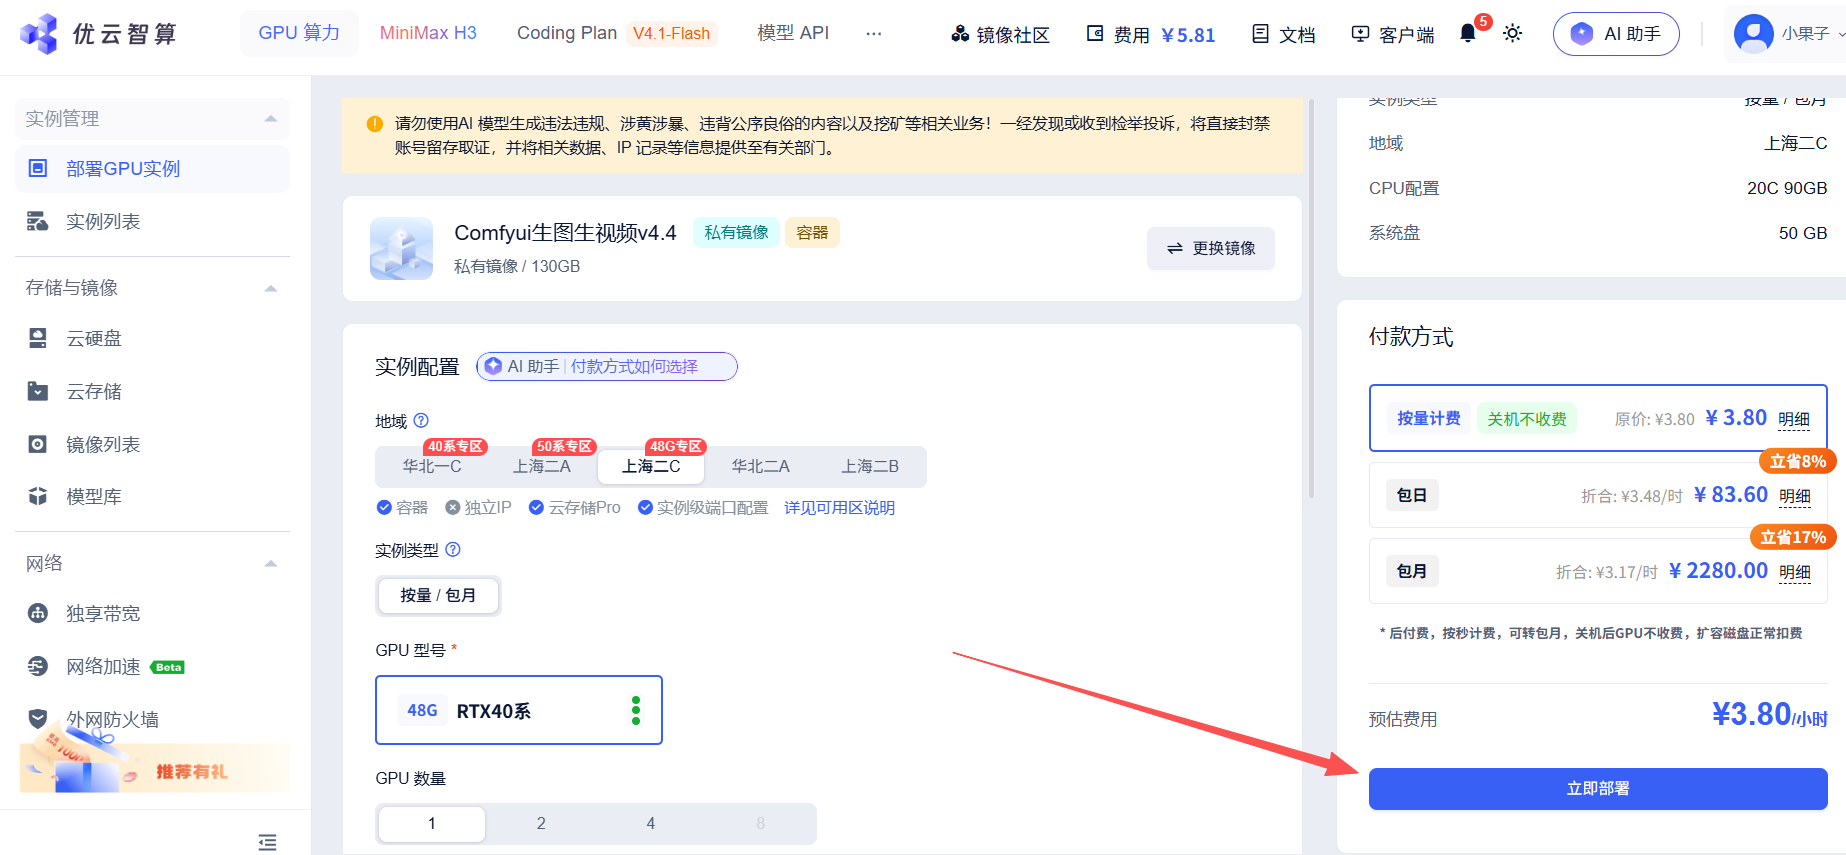
图片说明:在镜像市场选择本镜像,卡型选 24G 及以上 RTX40 系(4090 足够跑 480p),系统盘填 80G 以上,点击「立即部署」。
- 只是出图,24G 显存完全够
- 要跑图生视频,24G 也能跑,但别同时开两个任务
- 系统盘必须大于镜像体积(约 49G),给少了会创建失败
步骤 2:启动 ComfyUI
在实例终端执行 bash /root/ComfyUI/start.sh,看到 To see the GUI go to: http://0.0.0.0:8188 即启动完成。首次启动要加载模型索引,等 1-2 分钟属正常。
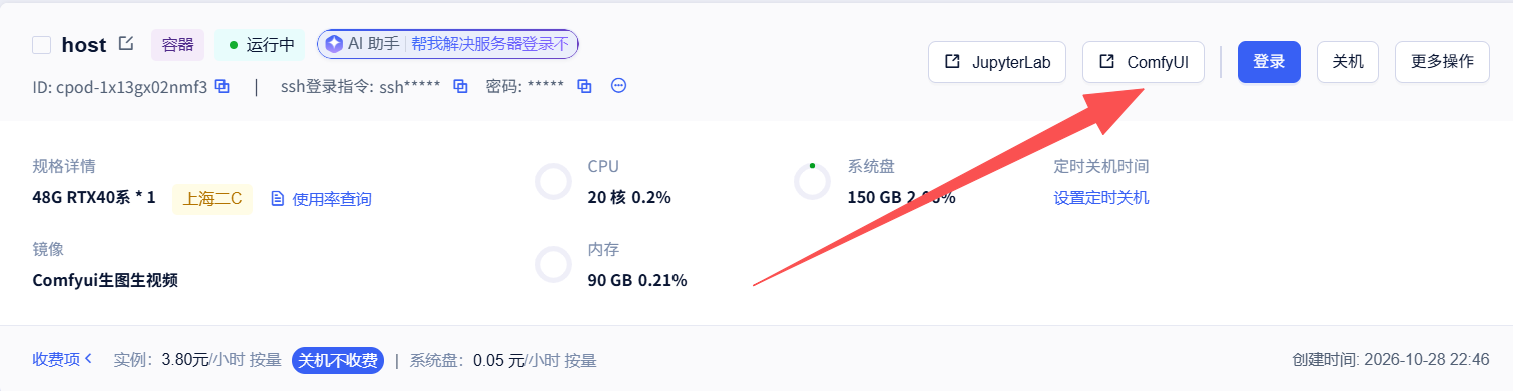
也可以先点击jupyterLab,终端打开后等1分钟左右,点击comfyui启动即可(马上打开可能会没加载出来)
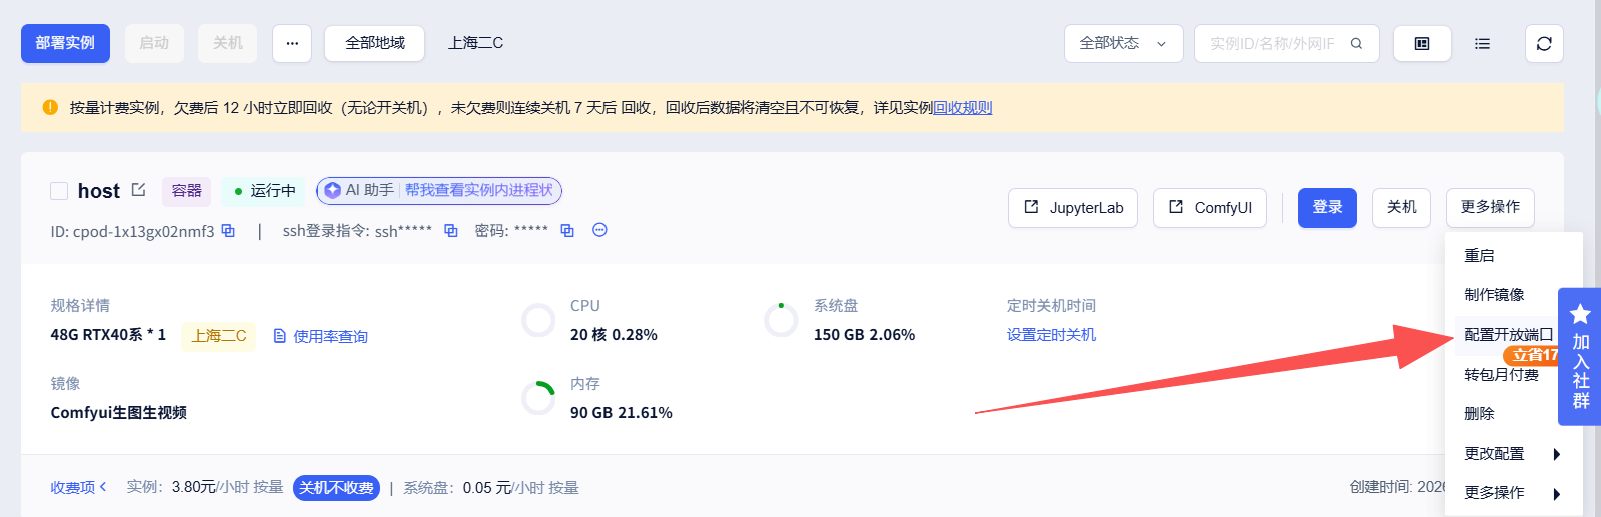
或者先打开终端,再点击8188端口打开
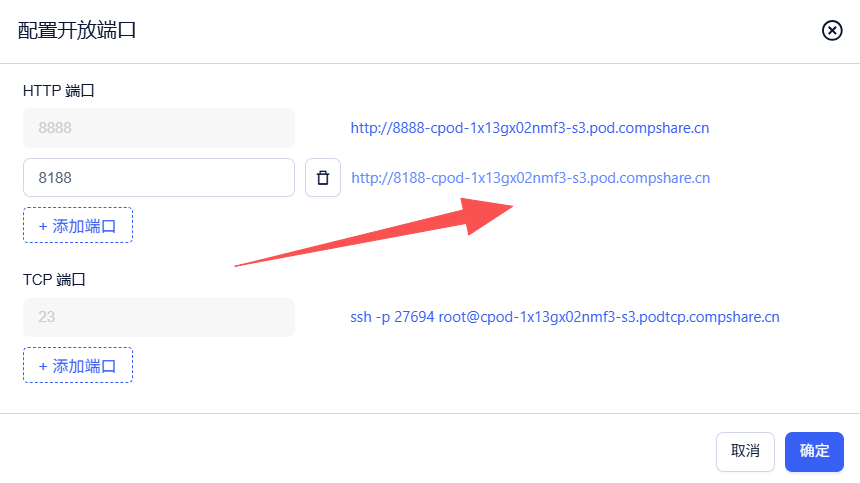
bash /root/ComfyUI/start.sh
步骤 3:出图
打开后左侧双击工作流。
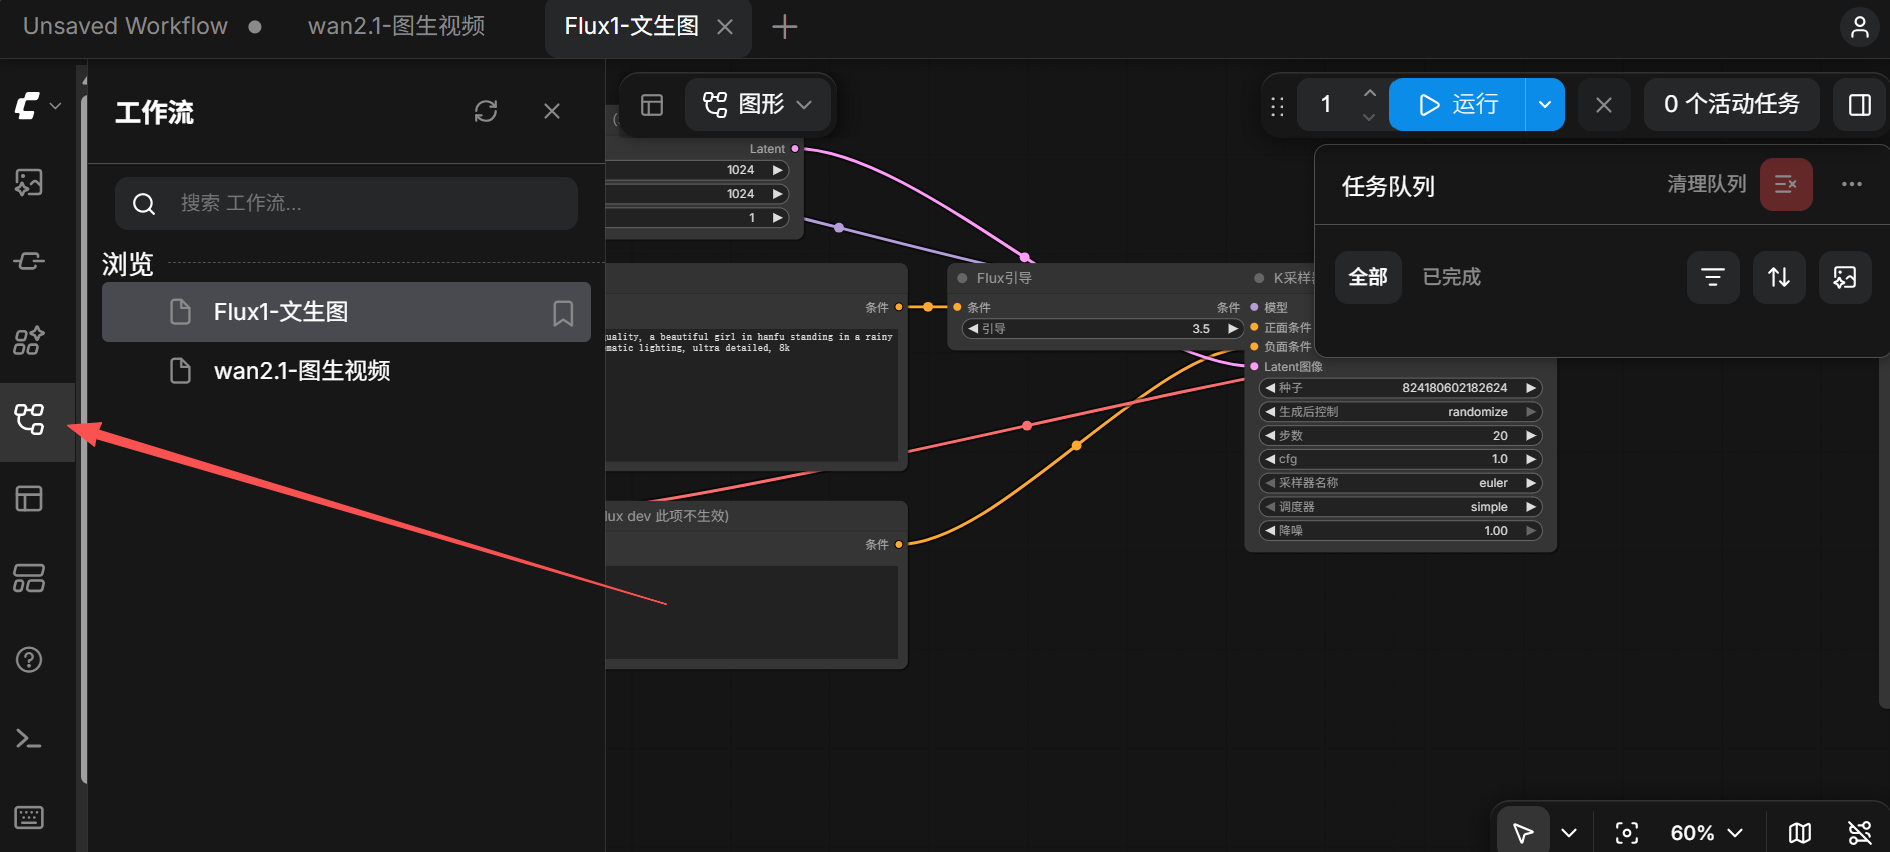
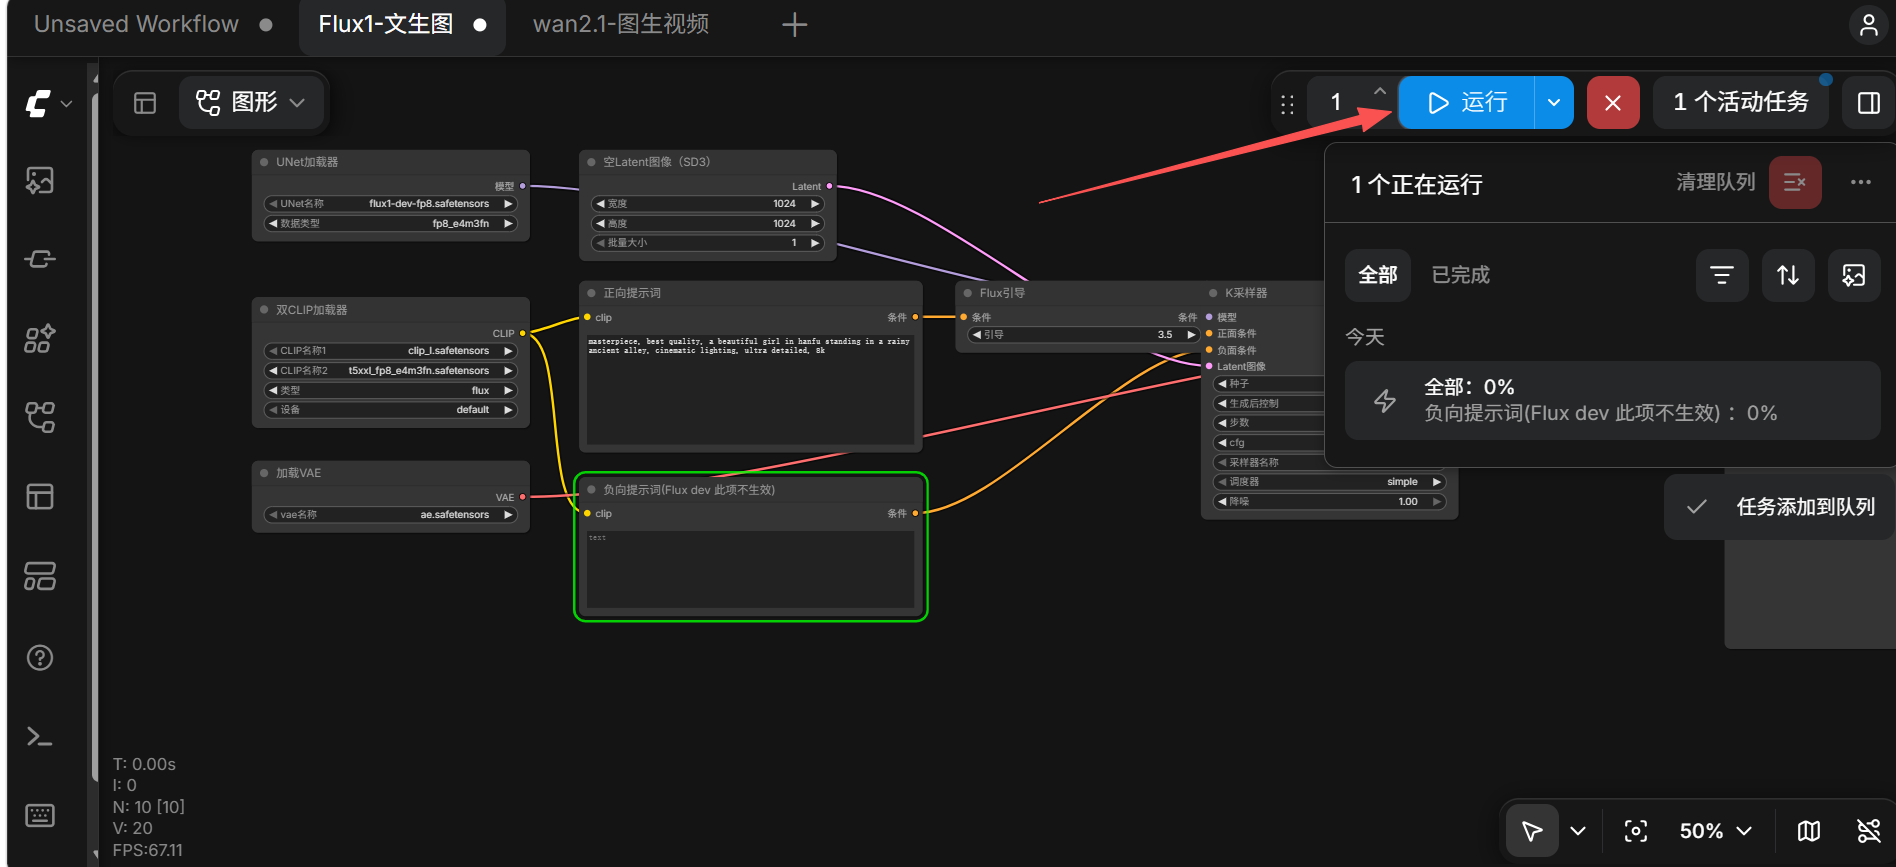 图片说明:在 CLIPTextEncode 节点填入画面描述,参数按上表设置(1024×576 / 24 步 / guidance 3.5 / euler + simple),点运行。
图片说明:生成完成后在右侧预览窗口查看结果,满意再继续。建议先确认人物长相,再批量出场景图,否则脸会前后不一致。
步骤 5:图生视频
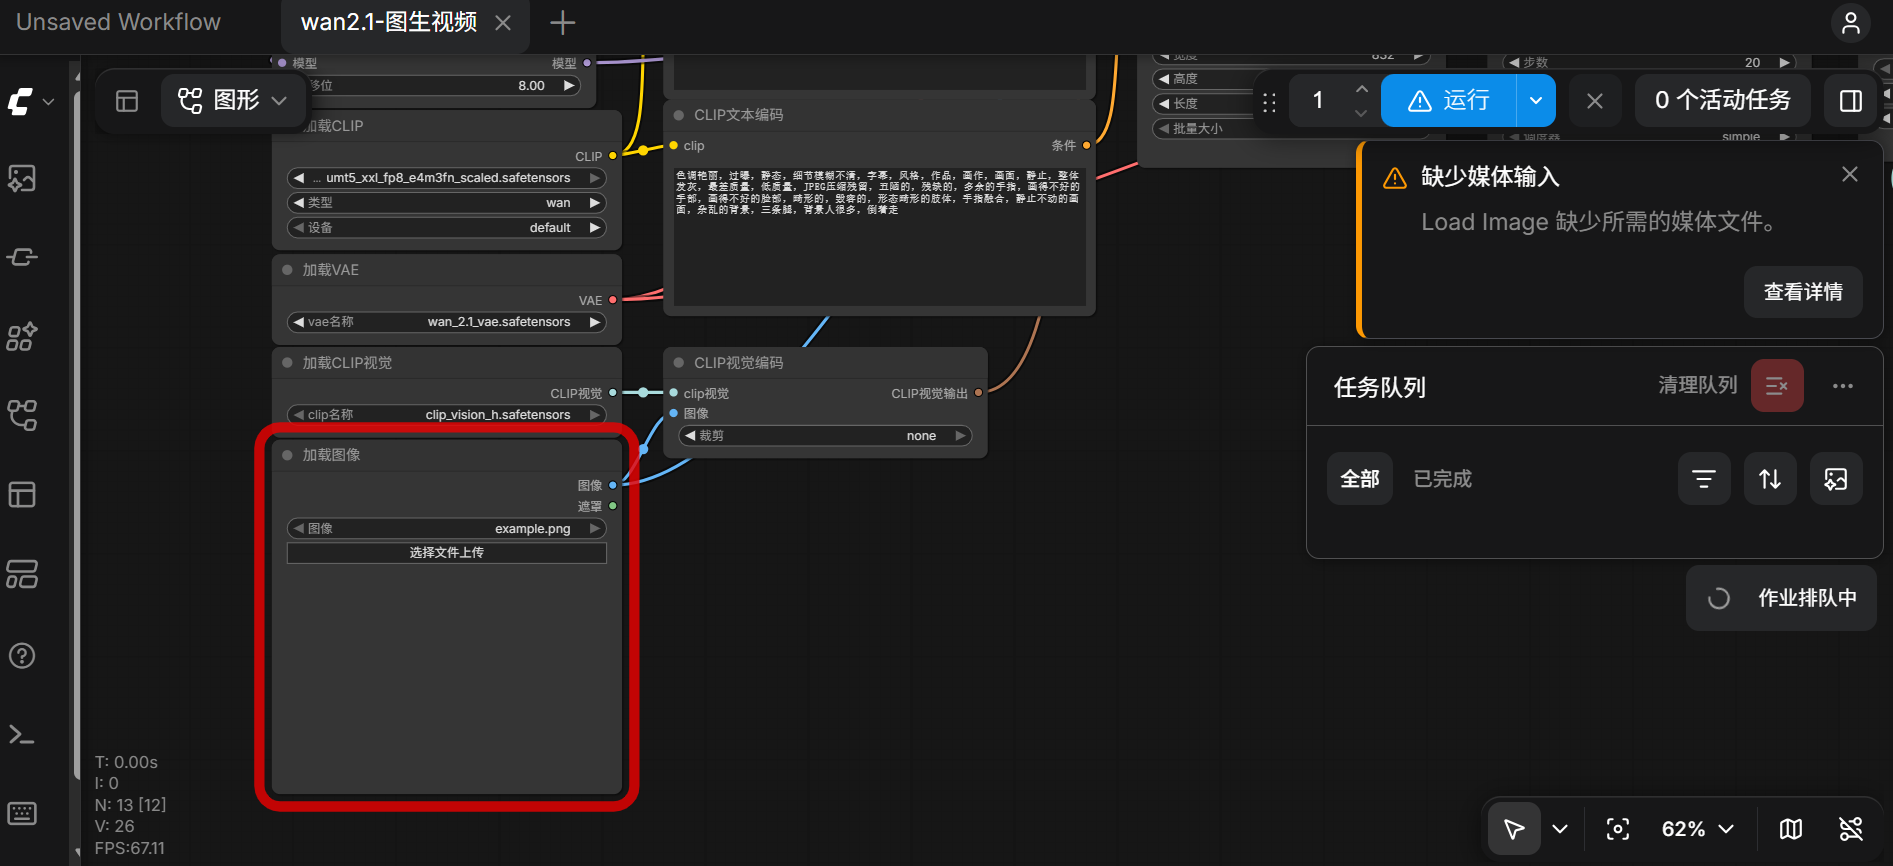
直接运行图生视频会出错,因为这个模型需要导入图片,根据图片生成视频,从本地选择文件后生成视频。
图片说明:用 LoadImage 载入首帧,WanImageToVideo 里填 832×480 / 81 帧,LoraLoaderModelOnly 挂上蒸馏 LoRA,KSampler 设 steps 4 / cfg 1.0。
关键参数:
| 节点 | 参数 | 值 |
|---|---|---|
LoraLoaderModelOnly | lora | Wan21_I2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors |
KSampler | steps | 4 |
KSampler | cfg | 1.0 |
WanImageToVideo | 尺寸 | 832×480(16 的倍数) |
WanImageToVideo | length | 49(3 秒)或 81(5 秒) |
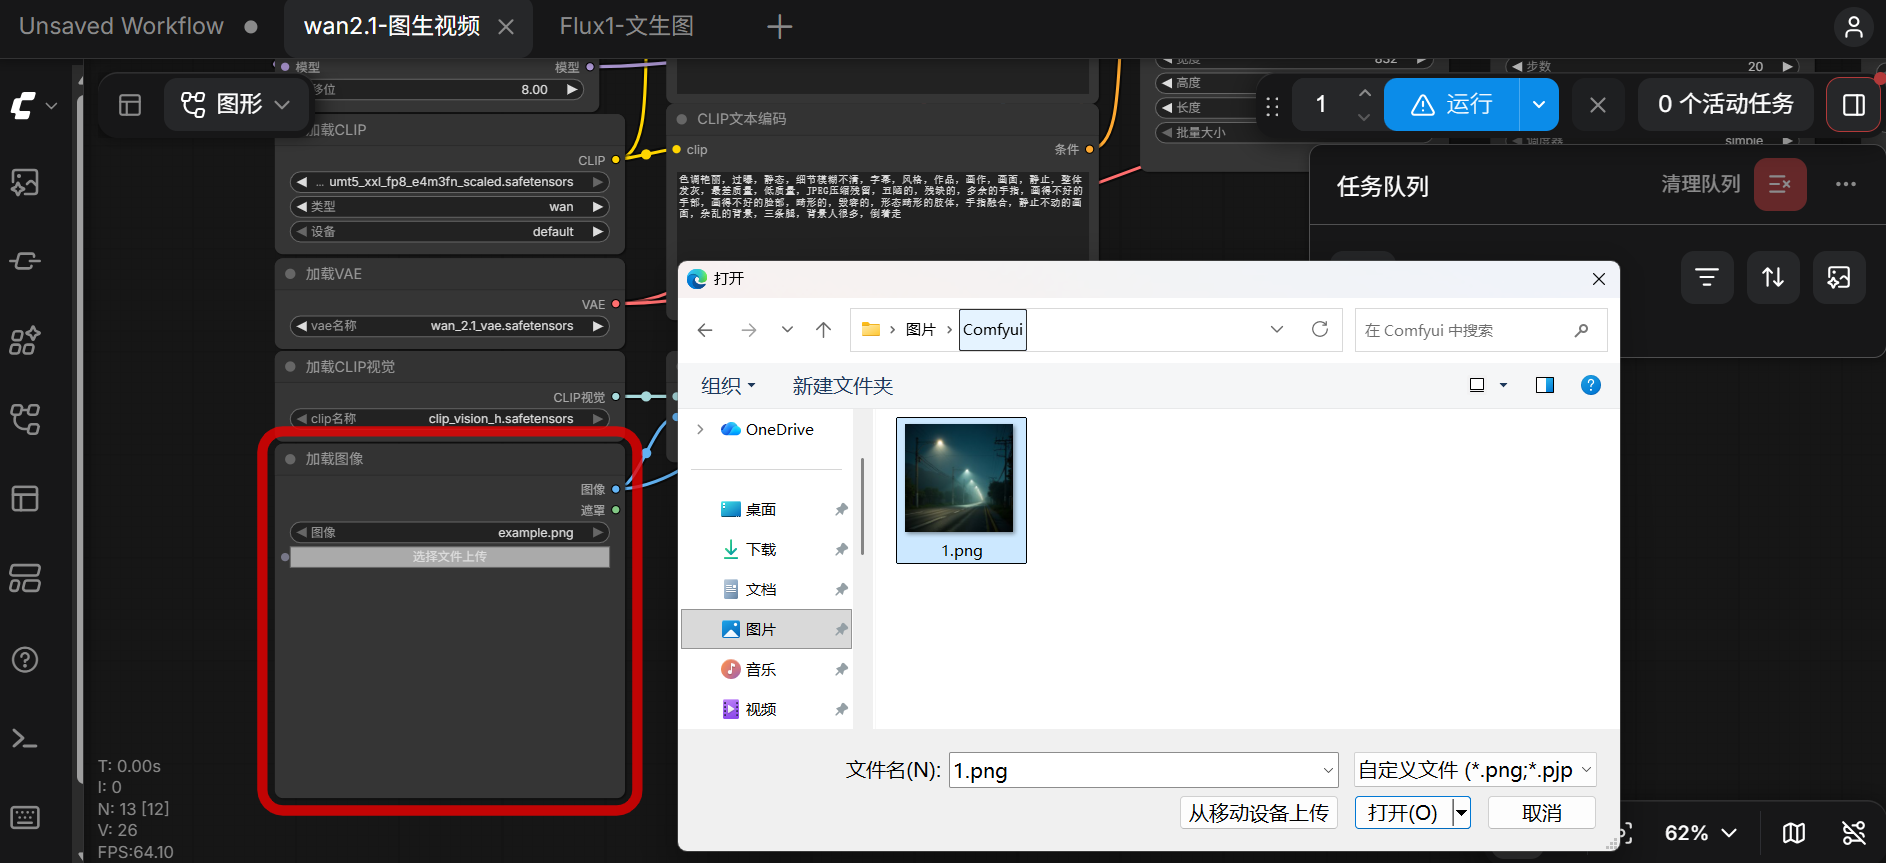
视频生成完成后可在预览窗口直接播放,确认人物没有变形、动作幅度合理再保存。
步骤 6:取回结果
图片说明:图片和视频都在 output 目录下,可通过 JupyterLab 文件树批量下载。
ls -lh /root/ComfyUI/ComfyUI/output/
步骤 7:投平台前处理
视频原生 480p、16fps,平台要求 1080 宽、30fps:
ffmpeg -i in.mp4 -vf "scale=1080:608:flags=lanczos,unsharp=5:5:0.8:5:5:0.0,minterpolate=fps=30:mi_mode=mci" \
  -c:v libx264 -crf 16 -preset slow -pix_fmt yuv420p out_1080.mp4
四、环境验证
进入实例终端(可选,仅用于自检),依次执行:
1. 显卡是否挂载
nvidia-smi
通过标准:能看到显卡型号与显存(4090 显示约 24564MiB)。
2. ComfyUI 是否在运行
curl -s --noproxy '*' -o /dev/null -w '%{http_code}\n' http://127.0.0.1:8188/
通过标准:返回 200。
3. 模型是否完整
du -sh /root/ComfyUI
通过标准:约 49G。若只有几个 G,说明镜像不完整。
4. 关键文件是否都在
ls -lh /root/ComfyUI/ComfyUI/models/diffusion_models/
ls -lh /root/ComfyUI/ComfyUI/models/loras/
ls -lh /root/ComfyUI/ComfyUI/models/text_encoders/
ls -lh /root/ComfyUI/ComfyUI/models/vae/
ls -lh /root/ComfyUI/ComfyUI/models/clip_vision/
通过标准:
diffusion_models里有flux1-dev-fp8和wan2.1_i2v_480p_14B_fp8_scaledloras里有蒸馏 LoRA,739472104 字节text_encoders里有clip_l、t5xxl_fp8、umt5_xxl_fp8vae里有ae、wan_2.1_vaeclip_vision里有clip_vision_h.safetensors,1264219396 字节
5. LoRA 是否可加载
cd /root/ComfyUI/ComfyUI
python -c "
from safetensors.torch import load_file
sd = load_file('models/loras/Wan21_I2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors')
print('tensors', len(sd))
"
通过标准:能打印出张量数量,不报错。
图片说明:截一张终端同时显示 nvidia-smi、curl 200、du -sh 三个结果图,最有说服力。
| 验证项 | 通过标准 |
|---|---|
| 显卡 | nvidia-smi 正常输出 |
| 服务 | curl 返回 200 |
| 体积 | du 约 49G |
| 模型 | 五类文件齐全 |
| LoRA | 可正常加载 |
五、常见问题
Q:生成的视频为什么没有声音?
Wan2.1 是纯视觉模型,只输出画面帧。要么生成时传音频参数把配音烧进去,要么后期在剪映统一铺 TTS 和 BGM。后者更省事,一集只铺一次,避免逐镜 BGM 断裂。
ffmpeg -i 视频.mp4 -i 配音.mp3 -c:v copy -c:a aac -shortest 输出.mp4
Q:57 秒是真实速度吗?
是,但前提是没有命中缓存。ComfyUI 会跳过参数完全相同的节点,这时会显示 0 秒或极短耗时,那不是真实速度。测速要用全新的图或全新 seed,看界面上的 Prompt executed in X seconds。
Q:视频糊、人脸发蜡怎么办?
三个方向:
- LoRA 强度从 1.0 降到 0.8
- 摘掉 LoRA,steps 改回 20、cfg 改回 5.0,慢 5 倍但细节更好
- 首帧图先出好一点,i2v 的质量上限由输入图决定
Q:图生视频人物变形、和首帧不像?
用主体完整、构图清晰的图做首帧;WanImageToVideo 的宽高调到和首帧同比例;length 从 81 降到 49 先试;cfg 保持 1.0(蒸馏模型不建议乱改)。
Q:8188 打不开,返回 502?
实例还活着但服务没起。先看进程:
ps aux | grep main.py | grep -v grep
没有输出就重新启动:
cd /root/ComfyUI/ComfyUI
python main.py --listen 0.0.0.0 --port 8188
Q:报 clip_vision_h.safetensors 缺失 / CLIP Vision Loader 缺少模型文件?
本镜像已内置 clip_vision_h.safetensors(1.26G),正常打开不会报这个错。真遇到了,按顺序排查:
- 刷新页面(Ctrl+F5)。前端会缓存旧的节点定义,刷新后
CLIP Vision Loader的下拉里才看得到文件 - 确认文件在:
ls -lh /root/ComfyUI/ComfyUI/models/clip_vision/
应看到 clip_vision_h.safetensors,大小 1264219396 字节。若目录为空,说明文件没打进来,重新下载:
unset http_proxy https_proxy all_proxy HTTP_PROXY HTTPS_PROXY ALL_PROXY
cd /root/ComfyUI/ComfyUI/models/clip_vision
wget -c https://hf-mirror.com/Comfy-Org/Wan_2.1_ComfyUI_repackaged/resolve/main/split_files/clip_vision/clip_vision_h.safetensors
- 也可以不用它。
WanImageToVideo的clip_vision_output是可选输入,把CLIP Vision Loader和CLIPVisionEncode删掉照样能出片,只是人物在长镜头里可能稍微漂一点
Q:显存不够、跑到一半崩?
24G 上 480p 是安全区,别直接生 720p。降低办法:帧数 81→49、尺寸 832×480→768×432、一次只跑一条。
Q:下载模型特别慢?
默认会走代理访问海外 CDN。走国内镜像并关掉代理会快很多:
unset http_proxy https_proxy all_proxy HTTP_PROXY HTTPS_PROXY ALL_PROXY
wget -c https://hf-mirror.com/<org>/<repo>/resolve/main/<path>
Q:端口被占用?
pkill -f main.py
bash /root/ComfyUI/start.sh
仍冲突就把启动参数里的 --port 8188 换成 8189。
六、注意事项
- 本镜像只包含系统盘内容,不含平台预装盘(
/cloud)里的文件 - 视频原生 480p、16fps,投平台前必须放大到 1080×608 并补帧到 30fps
- 不含 T2V、不含超分、不含换脸锁脸,需要这些要另行安装,建议先基于当前镜像再保存一个新版本,别在原镜像上改
- 镜像定价与 GPU 租赁费分别计算,计费规则以优云智算平台为准
- ComfyUI 为 GPL v3 开源协议;模型权重遵循各自许可(FLUX.1 Dev 为非商业许可,商用请自行确认)
- 素材版权:人物形象、剧本、配音需自有版权或已获授权