Toonflow MinimaxH3
一键式启动toonflow和comfyui服务
运行环境
最强AI视频生成 MiniMax-H3 合集,影视级视频效果!文生视频 | 图生视频 | 全模态参考生成视频
支持自启动 · Toonflow和ComfyUI 原生 · 一键部署
一句话生成带音频的影视级视频:文生视频、图生视频、全能参考(图/视频/音轨/音频)生视频, 内置 8 步 / 4 步 Turbo LoRA 加速与 Spectrum 特征预测加速。
| 镜像信息 | 值 |
|---|---|
| 镜像名称 | MinimaxH3 |
| 镜像 ID | compshareImage-1wb400kl22aw |
| 镜像大小 | 139 GB |
| 镜像类型 | 平台镜像 |
| 地域 | 上海二 A |
| 可见性 | 私密 |
| 当前版本 | v26.1009 |
| 最近更新 | 2026-10-09 |
运行环境
| 项目 | 值 |
|---|---|
| 框架版本 | PyTorch-2.13.0 |
| CUDA 版本 | 13.2(只需 NVIDIA 驱动,无需安装 CUDA Toolkit) |
| 应用 | ComfyUI: 8188(对外 8188)Toonflow: 3000(对外 3000) |
| Python | 3.12.11(随镜像携带,不依赖系统 Python) |
| 支持卡型 | RTX50 系 48G · RTX40 系 |
推荐配置: 建议选择 24G 显存及以上显卡。分辨率越大、时长越长,显存/内存占用越高; 开启 Turbo LoRA 可显著降低采样步数、提升速度。
MiniMax H3 项目使用教程
A 展示演示视频+注意事项
本镜像为 MiniMax H3 音视频联合生成 开箱即用环境,包含 ComfyUI 源码、预装 Python 虚拟环境、 MiniMax H3 原生节点(含 Spectrum 加速)以及三套 API 工作流与调用脚本。
支持的三种生成模式:
| 模式 | 说明 | 主干模型 | Turbo |
|---|---|---|---|
| t2v 文生视频 | 纯文本生成带音频的视频 | minimax_h3_fl2va_pruned_int8_convrot | 8 步 |
| i2v 图生视频 | 首帧图片 + 文本提示生成视频 | minimax_h3_fl2va_pruned_int8_convrot | 8 步 |
| r2v 全模态参考生视频 | 参考图 / 视频 / 视频音轨 / 音频 驱动生成 | minimax_h3_ref2va_pruned_int8_convrot | 8 步 |
注意事项:
(1)时长的影响: 时长越长,显存和内存占用越高。请留意实例内存,必要时选择更大内存规格或减少时长。
(2)分辨率的影响: 默认 0.4 MP,分辨率越大,显存和内存占用也会越大。建议根据显存大小调整
--megapixels(参考:显存越大可支持的分辨率越高,48G 及以上体验更佳)。
使用教程
1、在镜像详情界面使用该镜像创建实例
推荐选择 24G 显存或 48G 显存的显卡,点击“立即部署”。
实例启动后,ComfyUI 服务由镜像入口自动拉起:/entrypoint.sh 在容器启动时执行
/start.d/*.sh,其中 /start.d/comfyui.sh 负责启动 ComfyUI,并定期清理输出目录。
PS:
(1)音频/时长影响: 生成时长越长或带长音轨,内存占用越高,云端建议选择更大内存规格。
(2)分辨率影响: 默认 0.4 MP,分辨率越大,显存和内存占用也会越大。
2、镜像初始化完成后,等待几分钟服务自启动,然后打开 WebUI
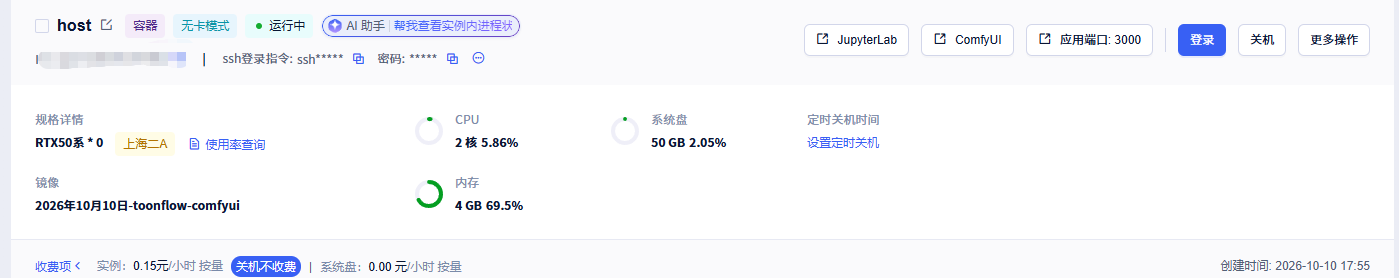 实例初始化完成后等待几分钟服务就绪,即可访问 ComfyUI/应用端口:3000。
可通过 应用端口:3000 访问工作台
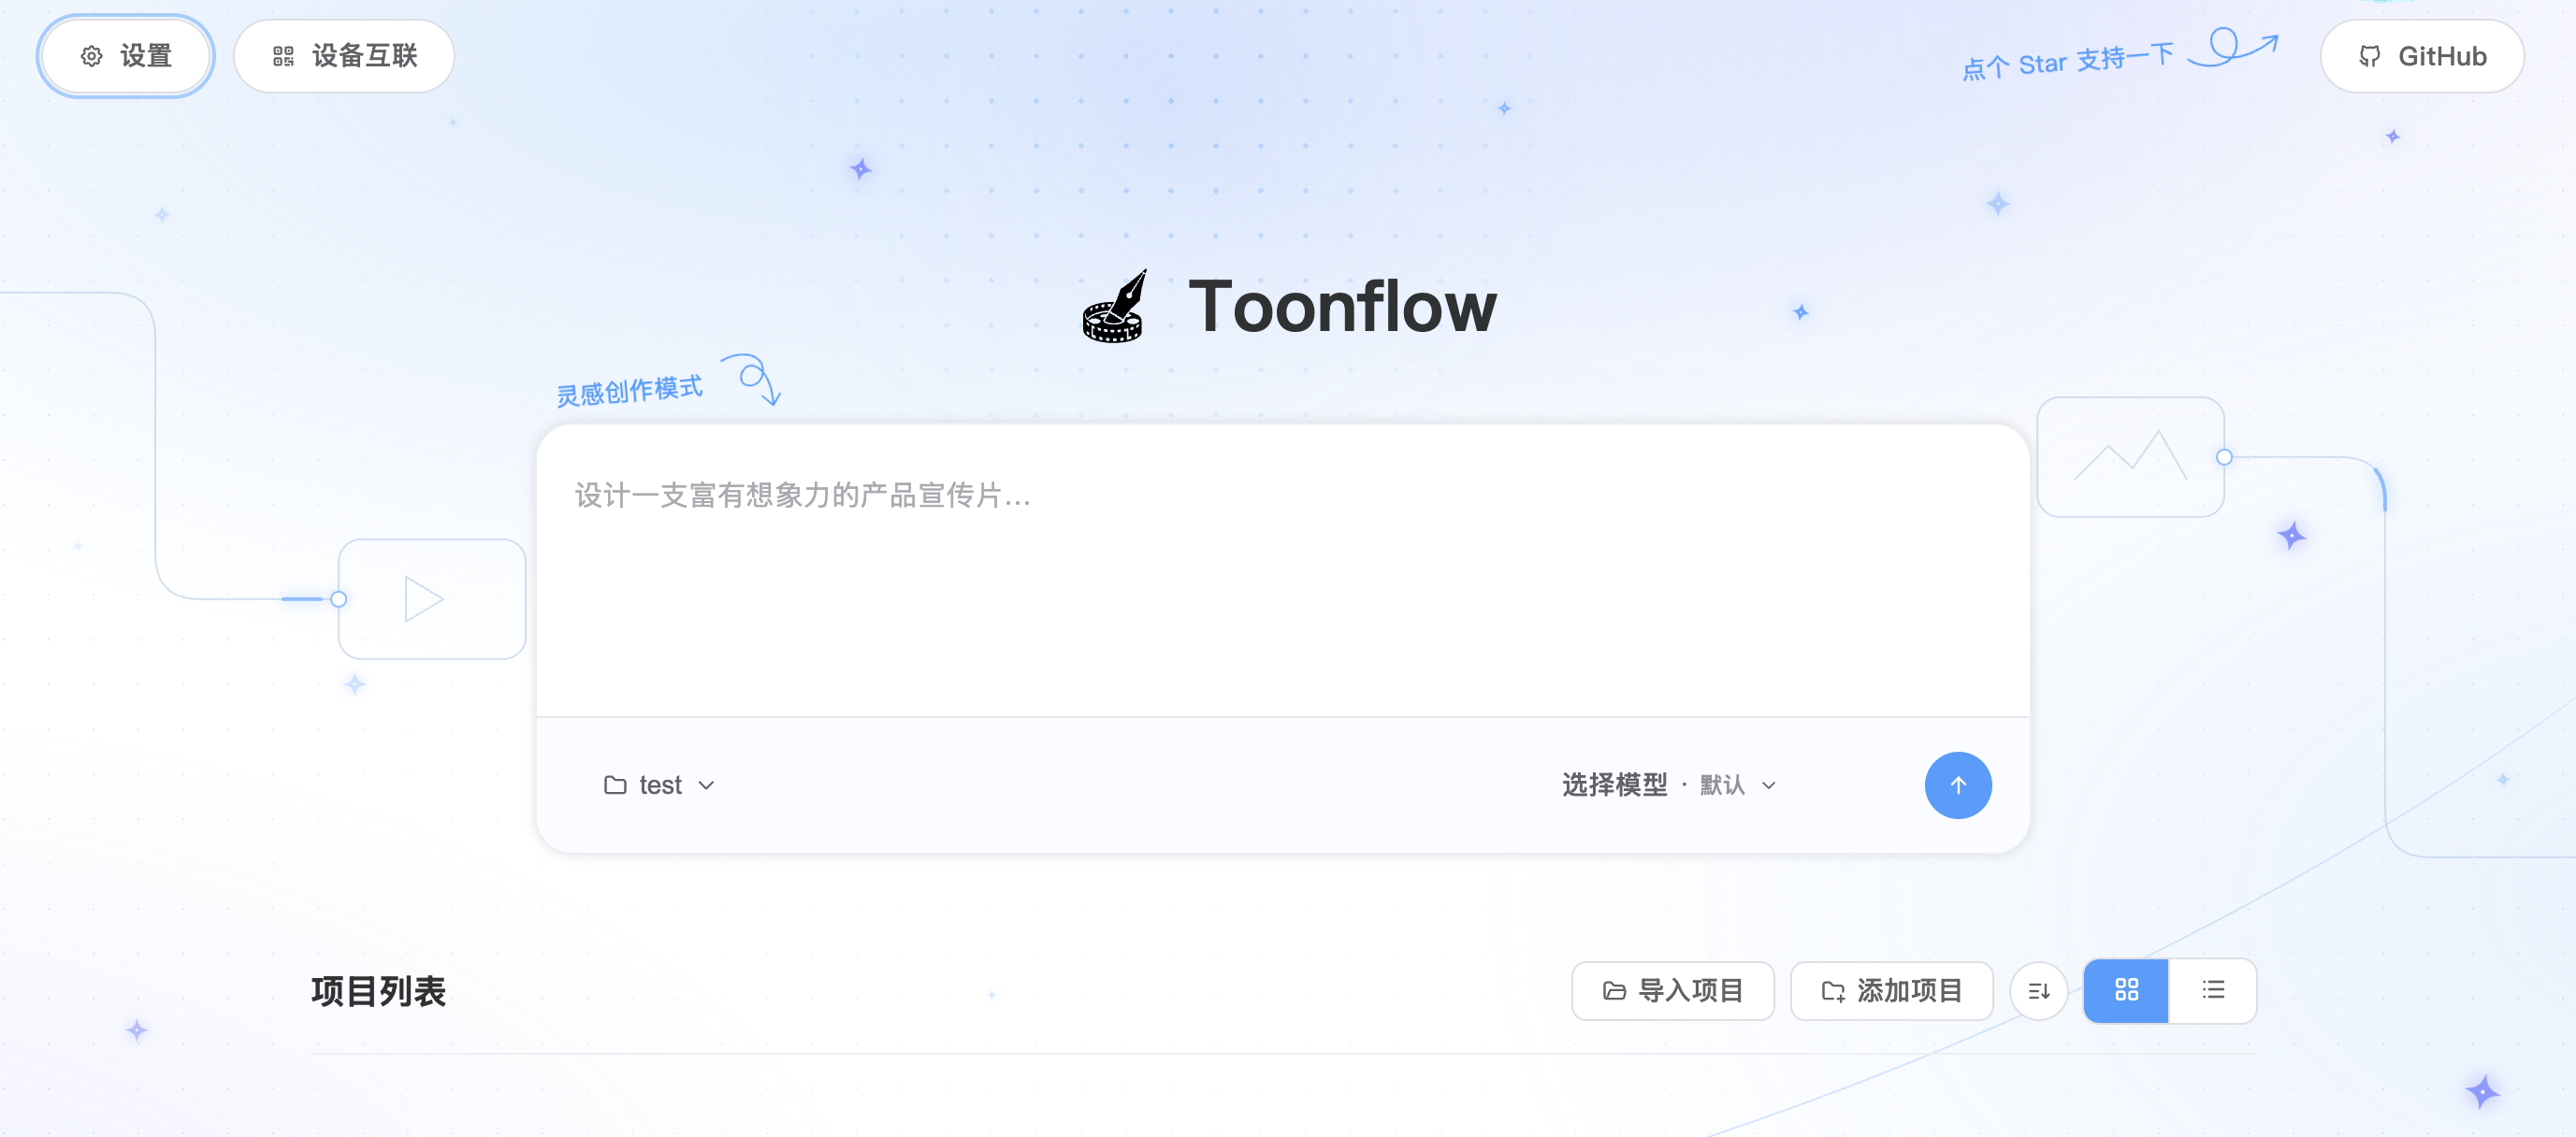
Toonflow 服务开机自启脚本(/start.d/toonflow.sh)
与 comfyui.sh 同一机制:/entrypoint.sh 在容器启动时执行 /start.d/*.sh,因此本脚本随每次开机自启。
服务监听 0.0.0.0:3000,日志写入
/start.d/log/toonflow.log。