ninfer让5090跑Qwen27B
ninfer让1张5090跑Qwen3.8-27B全量大模型
运行环境
ninfer让1张5090跑Qwen3.8-27B全量大模型
项目地址:
1.支持本地文本、图像与视频生成,可通过命令行或兼容 OpenAI、Anthropic 协议的 HTTP API 使用。
2.面向单 GPU 及双 DGX Spark 模型并行推理,提供模型评测与困惑度计算工具。
3.采用 CUDA Graph、推测解码和共享前缀缓存等技术优化推理性能。
4.使用统一的 .ninfer 模型产物格式,支持多种权重表示及对应架构的模型执行。
交流加群
bug反馈可以加入科哥专属群交流➕ 广告勿进!
- 已经设置开机运行 首次开机7-8分钟
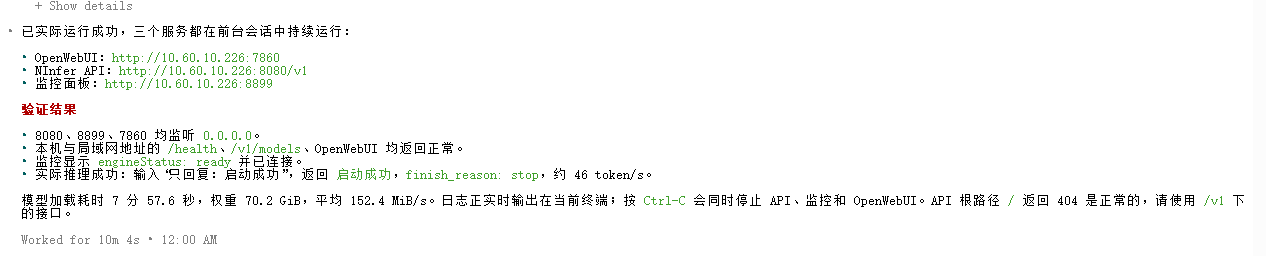
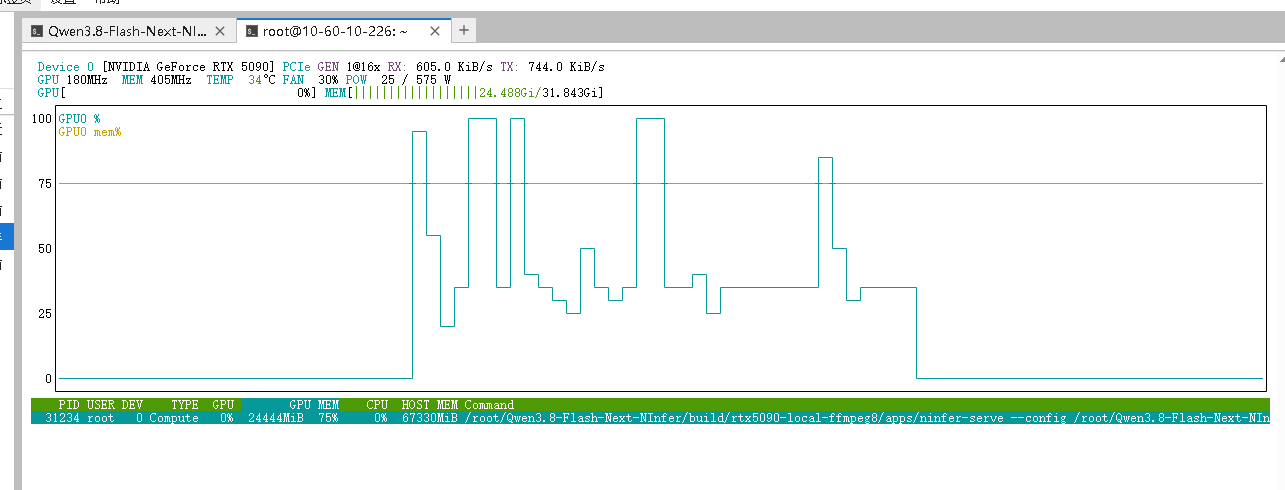
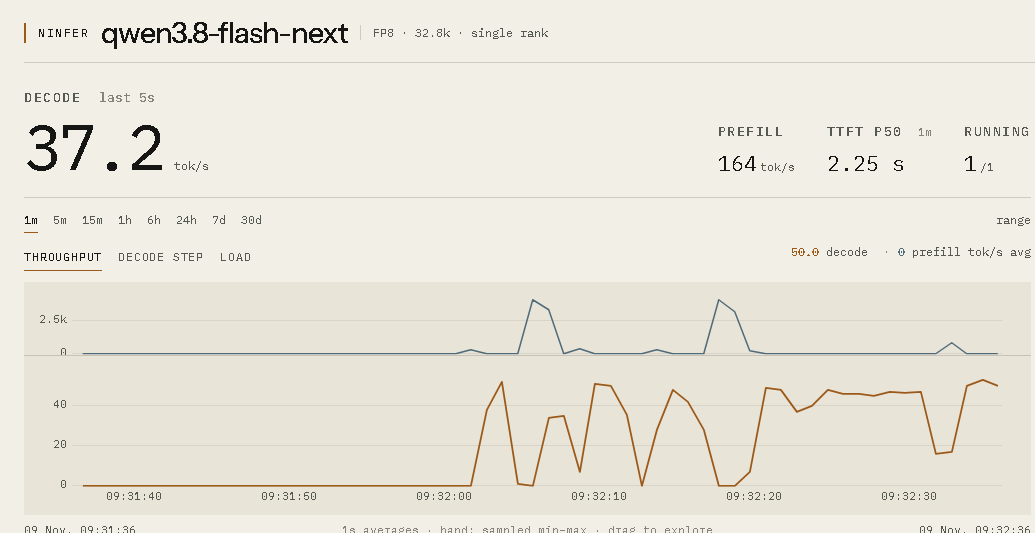
-
【插入一个小广告 给需要做ai视频,图片,短剧等多一个选择】:
-
✅主打廉价稳定模型中转站推荐:https://vip.kegeai.top
-
✅推荐一个在线AIGC生成的平台:支持无限画布,智能体,API接口,3D导演台等
-
✅功能趋于libTV,关键是模型众多,价格美丽!
-
✅国内外模型全部具备,aigc创多不可多得
-
在线图片、视频生成网站哈基米AI聚合平台:https://link8.lk888.ai/
-
✅杀疯了!!!在线sd2.5模型最低6毛钱一秒!!!
-
✅ai大模型:gpt,claude,gemini,deepseek...数百种主流模型
-
✅最新图片模型:gpt-image2,香蕉2,香蕉pro,即梦,豆包,万相...
-
✅最新视频模型:sd2,快乐马,grok,veo3,sora2,vidu,可灵...
-
✅并发高,收费合理(价格优先速度优先)
-
以上模型均支持API,龙虾CLI接入,web浏览器在线使用!
-
✅Seedance火山引擎-企业API可以私
-
咨询问题前请注意:
-
1.先说明哪个镜像,发镜像链接和名称,例如:
-
千问图像2.1最新模型量化版破限工作流大集合
-
2.先拿到运行报错的log日志或者截图:
-
没有上面的信息我也没有办法帮到你的,因为镜像比较多,我不清楚你问的哪个镜像的
-
感谢使用!感谢理解! 感谢支持!
NInfer 用户使用手册
本手册面向已经拿到可用环境的用户,只讲启动之后怎么用,不包含安装、编译和模型转换步骤。
当前默认部署包含:
| 服务 | 默认地址 | 用途 |
|---|---|---|
| OpenWebUI | http://<服务器IP>:7860 | 浏览器对话界面 |
| NInfer API | http://<服务器IP>:8080/v1 | OpenAI / Anthropic 兼容接口 |
| NInfer Monitor | http://<服务器IP>:8899 | 性能与请求监控 |
当前加载的模型:
模型 ID:qwen3.8-flash-next
最大上下文:8192 tokens
下文用 10.60.10.226 作为示例服务器 IP,请替换成你自己的地址。
1. 快速开始
1.1 启动整套服务
在项目根目录执行:
cd /root/Qwen3.8-Flash-Next-NInfer
./start_app.sh
脚本会:
- 检查
8080、8899、7860是否被占用。 - 如果被占用,直接终止占用进程,不需要你确认。
- 启动监控面板和 OpenWebUI。
- 前台启动 NInfer,并显示权重加载进度。
注意:
- 必须保持这个终端不要关闭;关闭终端会停止服务。
- 权重加载约 8 分钟,看到进度条在动就说明正常。
- 不要在加载期间重复执行
./start_app.sh,否则会杀掉当前进程并重新加载。
1.2 等待服务就绪
终端出现类似下面的日志后,表示三个服务都已经启动:
start_app: monitor listening on 0.0.0.0:8899
start_app: OpenWebUI listening on 0.0.0.0:7860
start_app: starting NInfer Serve; press Ctrl-C to stop all services
主程序加载完成后,可以用下面的命令确认:
curl --noproxy '*' http://127.0.0.1:8080/health
正常返回:
{"status":"ok"}
如果返回 503 或连接失败,说明模型还没有加载完,继续等待终端进度。
1.3 三个入口怎么选
- 普通对话、演示、非开发者:直接用 OpenWebUI 的
7860。 - 自己写程序、接 SDK、接第三方客户端:用 API 的
8080。 - 看吞吐、延迟、显存、请求记录:用监控的
8899。
2. 使用 OpenWebUI 对话
2.1 打开页面
在浏览器访问:
http://10.60.10.226:7860
2.2 首次登录或注册
首次使用时会显示登录/注册页面:
- 第一个注册的账号通常会成为管理员。
- 如果已经存在账号,直接使用已有账号登录。
- 账号和密码由 OpenWebUI 自己管理,不是 NInfer API Key。
如果页面提示需要管理员创建账号,请联系环境管理员。
2.3 选择模型
进入对话页面后,在输入框附近找到模型选择器,选择:
qwen3.8-flash-next
如果没有看到模型:
- 确认 API 的
/health已经返回 200。 - 刷新页面。
- 确认启动脚本没有把模型 ID 改成其他名字。
2.4 开始对话
- 在底部输入框输入问题。
- 按发送按钮或回车。
- 回答会以流式方式逐步出现。
- 生成过程中可以点击停止按钮中断。
示例问题:
用三句话解释什么是 KV Cache。
2.5 调整对话参数
在对话输入框附近通常有“参数/控制”面板,可以调整:
temperature:随机性。越低越稳定,越高越发散。max tokens:本次回答的最大生成长度。system prompt:系统提示词,用于设定角色和回答风格。
当前模型默认开启思考模式,因此:
max tokens也会被思考内容消耗。- 如果回答经常被截断,先增大
max tokens。 - 如果只想要快速短答,可以降低生成长度或关闭思考(取决于 OpenWebUI 当前版本是否暴露该选项)。
2.6 新建对话与历史记录
- 点击“新建对话”可以开始独立上下文。
- 旧对话会保存在 OpenWebUI 的历史记录中。
- 每个对话的上下文上限是 8192 tokens;对话太长时,早期内容可能被截断或请求变慢。重要话题建议新建对话。
2.7 思考内容
Qwen3.8-Flash-Next 默认会先思考再回答:
- 部分客户端会把思考过程单独显示在可折叠区域。
- 最终答案在正文
content中。 - 思考内容也会占用生成预算和上下文。
2.8 当前限制
当前启动配置下:
- 不支持图片/视频输入(
vision = false)。 - 不支持投机解码(
speculative.backend = "none")。 - 同时只有 1 个活跃生成请求,额外请求会排队,最多等待 16 个。
- 最大上下文 8192 tokens。
如果上传图片或视频,接口会返回 400 vision_disabled,这是配置限制,不是页面故障。
3. 使用 HTTP API
3.1 基本信息
Base URL:http://10.60.10.226:8080/v1
模型 ID:qwen3.8-flash-next
当前默认配置没有设置 API Key,因此可以直接访问。如果管理员通过 NINFER_API_KEY 启动了服务,则请求需要带:
Authorization: Bearer <你的密钥>
3.2 健康检查
curl --noproxy '*' http://127.0.0.1:8080/health
返回 {"status":"ok"} 表示可以接收请求;返回 503 表示引擎不可用。
3.3 查看模型
curl --noproxy '*' http://127.0.0.1:8080/v1/models
返回示例:
{
  "object": "list",
  "data": [
    {
      "id": "qwen3.8-flash-next",
      "object": "model",
      "owned_by": "ninfer",
      "max_model_len": 8192
    }
  ]
}
3.4 非流式对话
curl --noproxy '*' http://127.0.0.1:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen3.8-flash-next",
    "messages": [
      {"role": "system", "content": "回答要简洁。"},
      {"role": "user", "content": "用一句话解释前缀缓存。"}
    ],
    "max_tokens": 256
  }'
返回中常见字段:
choices[0].message.content:最终答案。choices[0].message.reasoning_content:思考内容(如果模型产生)。usage:token 用量。timings:NInfer 扩展的耗时统计。
3.5 流式对话
curl --noproxy '*' -N http://127.0.0.1:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen3.8-flash-next",
    "messages": [
      {"role": "user", "content": "写一个 5 行的 Python 示例。"}
    ],
    "max_tokens": 512,
    "stream": true,
    "stream_options": {"include_usage": true}
  }'
服务端使用 SSE 返回:
- 思考和正文会作为不同的增量到达。
- 结束时发送
data: [DONE]。 - 开启
include_usage后,最后会有一个包含用量信息的空choices数据块。
3.6 用 Python OpenAI SDK 调用
先安装并确认你的 Python 环境有 openai 包,然后:
from openai import OpenAI

client = OpenAI(
    base_url="http://10.60.10.226:8080/v1",
    api_key="ninfer-local",  # 服务未启用鉴权时,任意非空字符串即可
)

response = client.chat.completions.create(
    model="qwen3.8-flash-next",
    messages=[
        {"role": "system", "content": "回答要简洁。"},
        {"role": "user", "content": "介绍一下你自己。"},
    ],
    max_tokens=256,
)

message = response.choices[0].message
print(message.content)

# reasoning_content 是兼容扩展字段,部分 SDK 版本需要从 model_extra 读取
extra = getattr(message, "model_extra", None) or {}
print(extra.get("reasoning_content", ""))
说明:
api_key不能为空字符串;服务未启用鉴权时传ninfer-local即可。- 如果管理员启用了
NINFER_API_KEY,这里要换成真实密钥。
3.7 其他兼容协议
NInfer 还提供:
| 协议 | 路径 |
|---|---|
| OpenAI Responses | POST /v1/responses |
| OpenAI Responses 输入 token 计数 | POST /v1/responses/input_tokens |
| Responses 状态查询 | GET /v1/responses/{id} |
| Responses 输入项查询 | GET /v1/responses/{id}/input_items |
| Anthropic Messages | POST /v1/messages |
| Anthropic 输入 token 计数 | POST /v1/messages/count_tokens |
Anthropic 风格示例:
curl --noproxy '*' http://127.0.0.1:8080/v1/messages \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen3.8-flash-next",
    "max_tokens": 256,
    "messages": [
      {"role": "user", "content": "用一句话说明什么是 MoE。"}
    ]
  }'
Responses 风格示例:
curl --noproxy '*' http://127.0.0.1:8080/v1/responses \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen3.8-flash-next",
    "input": "用一句话说明什么是张量并行。",
    "max_output_tokens": 256
  }'
不同协议的请求字段和返回结构不同,接第三方客户端时以对应协议文档为准。
3.8 控制思考模式
当前模型默认开启思考。Chat Completions 支持:
{
  "reasoning_effort": "low"
}
可选值:
low:较少思考。medium:中等思考。xhigh:更多思考。none:关闭思考(Qwen 系列)。
也可以使用:
{
  "enable_thinking": false
}
或:
{
  "preserve_thinking": true
}
注意:
max_tokens包含思考内容和最终答案。- 思考预算过小可能导致回答没有空间,接口会拒绝明显不足的请求。
- 不同模型对
none的支持不同,GLM 会拒绝关闭思考。
3.9 结构化输出
JSON 对象
{
  "response_format": {"type": "json_object"}
}
JSON Schema
{
  "response_format": {
    "type": "json_schema",
    "json_schema": {
      "name": "answer",
      "schema": {
        "type": "object",
        "properties": {
          "answer": {"type": "integer"}
        },
        "required": ["answer"],
        "additionalProperties": false
      },
      "strict": true
    }
  }
}
固定选项 / 正则 / GBNF
使用 NInfer 扩展字段 structured_outputs,每次只能给一个:
{"structured_outputs": {"choice": ["positive", "neutral", "negative"]}}
{"structured_outputs": {"regex": "(BUG|TASK)-[0-9]{4}"}}
{"structured_outputs": {"grammar": "root ::= \"yes\" | \"no\""}}
注意:
- 结构化输出约束的是最终答案,思考内容不受约束。
- Schema 不会自动加进提示词,仍然要在问题里说明你想要什么。
- 一次请求只能使用一种输出约束。
- 不支持的 Schema 会在生成前返回
400。
3.10 工具调用
Chat Completions 支持 OpenAI 风格的 function tools:
{
  "tools": [
    {
      "type": "function",
      "function": {
        "name": "get_weather",
        "description": "查询指定城市的天气",
        "parameters": {
          "type": "object",
          "properties": {
            "city": {"type": "string"}
          },
          "required": ["city"]
        }
      }
    }
  ],
  "tool_choice": "auto"
}
工作方式:
- 模型根据问题决定是否调用工具。
- NInfer 返回工具名和参数。
- 你的程序执行真实工具。
- 把工具结果以
tool消息放回对话,再次请求模型。
NInfer 只负责生成工具调用,不会替你执行工具,也不会访问外部系统。
3.11 限流与常见 HTTP 状态
| 状态 | 含义 | 建议 |
|---|---|---|
200 | 成功 | — |
400 | 请求字段错误或能力不支持 | 查看错误代码和字段 |
401/403 | 鉴权失败 | 检查 Authorization |
429 | 服务过载,等待队列已满 | 降低并发,稍后重试 |
503 | 引擎不可用或排队超时 | 检查 /health,稍后重试 |
529 | Anthropic 协议的本地过载 | 降低并发 |
当前配置:
- 活跃并发:1。
- 额外等待请求:16。
- 排队超时:30 秒。
因此多人同时使用时,后到的请求会排队;排队过久会返回 503 request_queue_timeout。
3.12 Prometheus 指标
curl --noproxy '*' http://127.0.0.1:8080/metrics
适合接入 Prometheus/Grafana。普通用户一般只需要监控面板 8899。
4. 使用监控面板
访问:
http://10.60.10.226:8899
主要页面和功能:
Live(实时)
- 当前解码吞吐、预填充吞吐。
- 首 token 延迟(TTFT)、请求耗时、排队时间。
- GPU/CPU/内存等资源观察。
- 当前请求和最近事件。
History(历史)
- 选择时间范围查看曲线。
- 在图表上拖动可以放大区间。
Pause只冻结页面显示,后台采集不会停止。- 实例选择器可以查看之前某次引擎运行的历史。
Requests(请求)
- 点击一行可以查看该请求的生命周期。
- 可以看到排队、预填充、解码、结束等阶段。
- 不保存提示词和生成文本,只保存指标和请求摘要。
Details(详情)
- 批次解码耗时。
- 各执行阶段耗时。
- 每个 rank 的 GPU 区间。
- 当前生效的配置。
说明:
- 监控面板本身没有登录认证,不要把它暴露到公网。
- 引擎刚启动、模型还在加载时,面板可能显示
Upstream: fetch failed,这是正常的;加载完成后会自动恢复。 - 如果某项测量没有开启,会显示
—,例如未启用 GPU timing 时的细粒度 GPU 数据。 - 细粒度采样默认保留 24 小时,分钟聚合默认保留 30 天。
5. 常用操作
5.1 停止服务
回到运行 start_app.sh 的终端,按:
Ctrl-C
脚本会依次停止 OpenWebUI、监控和 NInfer。确认端口释放:
ss -ltnp | rg ':(8080|8899|7860)\b' || true
如果终端已经丢失:
pgrep -af 'bash ./start_app.sh'
kill -TERM <start_app_pid>
不要使用 kill -9 杀启动脚本,否则子进程可能残留并继续占用端口。
5.2 重启服务
再次执行:
./start_app.sh
脚本会自动清理旧端口。注意:重启会重新加载模型,通常需要约 8 分钟。
5.3 查看日志
日志直接显示在运行脚本的终端:
[monitor]:监控面板日志。[openwebui]:OpenWebUI 日志。- 无前缀:NInfer 主程序日志和权重加载进度。
如果终端输出太快,可以在另一个终端查看进程和端口:
ps -eo pid,etime,cmd | rg 'ninfer-serve|open-webui|dashboard/dist/server'
ss -ltnp | rg ':(8080|8899|7860)\b'
5.4 让其他设备访问
确认服务监听在 0.0.0.0:
ss -ltnp | rg ':(8080|8899|7860)\b'
从其他设备访问:
http://<服务器IP>:7860
http://<服务器IP>:8899
http://<服务器IP>:8080/v1/models
如果本机能访问、其他设备不能访问,检查:
- 服务器防火墙是否放行这三个端口。
- 云主机安全组是否放行。
- 两台设备是否在同一网络,或有正确路由。
5.5 启用 API Key
默认没有 API Key。若需要鉴权,用环境变量启动:
NINFER_API_KEY='请换成足够长的随机字符串' ./start_app.sh
之后 API 请求需要:
Authorization: Bearer 请换成足够长的随机字符串
OpenWebUI 会自动使用同一个 Key 连接 NInfer。
6. FAQ
Q1:浏览器打不开 7860 怎么办?
按顺序检查:
ss -ltnp | rg ':7860\b'
curl --noproxy '*' http://127.0.0.1:7860/health
- 本机
curl正常、其他设备打不开:检查防火墙/安全组。 - 本机也失败:看启动终端里
[openwebui]的报错。 - OpenWebUI 启动需要约 10 秒,刚启动时刷新页面即可。
Q2:8080、7860、8899 分别是什么?
7860:给人用的 OpenWebUI 网页。8080:给程序用的 API。8899:监控面板。
不要用 7860 拼 API 路径,也不要用 8080 打开网页。
Q3:启动后很久没有反应,是卡住了吗?
大概率不是。模型有 70.2 GiB 权重,加载通常需要约 8 分钟。看终端里的 loading weights 进度是否在增加。只要进度在动就继续等。
Q4:curl 返回 502,但服务明明在运行?
当前环境的代理会拦截 loopback 请求。给 curl 加:
--noproxy '*'
例如:
curl --noproxy '*' http://127.0.0.1:8080/health
程序里访问本机 API 时,也要设置 NO_PROXY=127.0.0.1,localhost。
Q5:API 返回 401 或 403?
说明服务启用了 API Key,但请求没有带或带错了:
Authorization: Bearer <正确密钥>
如果不知道密钥,查看启动命令中的 NINFER_API_KEY。默认配置没有 Key,不应该出现 401。
Q6:返回 model not found 或类似错误?
请求里的 model 必须与 /v1/models 返回的 ID 完全一致:
qwen3.8-flash-next
不要写成 Qwen3.8-Flash-Next、qwen3.8_flash_next 或其他别名。
Q7:上传图片/视频返回 400 vision_disabled?
当前启动配置是 vision = false,不支持媒体输入。需要启用 Vision 并重启服务,属于部署配置变更。
Q8:回答为什么被截断了?
通常是 max_tokens 太小,或者上下文超过 8192。处理:
- 增大
max_tokens。 - 缩短问题或历史对话。
- 新建对话,避免旧上下文占满窗口。
- 注意思考内容也消耗预算。
Q9:返回 429 server_overloaded 怎么办?
同时请求太多,等待队列已满。降低并发,等当前请求结束后重试。当前只允许 1 个活跃请求、16 个等待请求。
Q10:返回 503 request_queue_timeout 怎么办?
请求在 30 秒内没有排到执行机会。降低并发或稍后重试;如果是持续高负载,需要调整部署配置。
Q11:OpenWebUI 里看不到模型?
- 确认
curl --noproxy '*' http://127.0.0.1:8080/v1/models正常。 - 刷新 OpenWebUI 页面。
- 确认模型选择器里选的是
qwen3.8-flash-next。 - 如果 OpenWebUI 启动早于 NInfer 加载完成,等待加载完成后再刷新。
Q12:监控面板显示 Upstream: fetch failed?
模型还在加载或 API 暂时不可用时会出现。等 /health 返回 200 后会自动恢复。如果加载完成后仍持续出现,检查 dashboard/config.local.json 里的 engine_url 是否指向正确的 8080。
Q13:监控面板为什么有些数值是 —?
对应测量没有开启或该时间窗口没有样本。例如 GPU timing 未启用时,细粒度 GPU 区间不可用。— 不代表服务故障。
Q14:关闭终端后服务就停了,正常吗?
正常。start_app.sh 是前台运行,终端关闭或按 Ctrl-C 都会停止服务。需要长期运行时,请让管理员用 tmux/systemd 等方式托管,或保持终端会话不关闭。
Q15:脚本会杀掉我其他的服务吗?
脚本只处理 8080、8899、7860 这三个端口的占用进程,并且会直接终止,不会二次确认。运行前请确认这三个端口上没有其他重要服务。
Q16:支持多用户同时聊天吗?
OpenWebUI 可以创建多个账号,但当前引擎活跃并发为 1,额外请求会排队,最多 16 个。多人同时使用时回答会变慢,排队过久会超时。
Q17:对话记录保存在哪里?
OpenWebUI 自己保存对话历史,位置由它的数据目录决定。监控面板不保存提示词和生成文本,只保存指标和请求摘要。
Q18:如何切换模型?
当前部署固定使用 qwen3.8-flash-next。切换模型需要更换模型产物并修改启动配置,属于部署操作,不在本手册范围内。不要只改请求里的 model 字段,服务不会动态加载新模型。
Q19:如何确认服务真的在用 GPU?
看监控面板的 Live/Details 页面,或执行:
nvidia-smi
NInfer 启动日志也会打印设备、显存和上下文容量信息。监控面板中的 GPU 数据取决于是否开启 GPU timing。
Q20:如何反馈问题?
请提供:
- 出问题的入口(
7860/8080/8899)。 - 完整请求和返回状态码。
- 启动终端里对应的错误日志。
curl --noproxy '*' http://127.0.0.1:8080/health的结果。
7. 速查表
# 启动
cd /root/Qwen3.8-Flash-Next-NInfer
./start_app.sh

# 健康检查
curl --noproxy '*' http://127.0.0.1:8080/health

# 模型列表
curl --noproxy '*' http://127.0.0.1:8080/v1/models

# 端口检查
ss -ltnp | rg ':(8080|8899|7860)\b'

# 停止:在运行脚本的终端按 Ctrl-C

# 找不到终端时
pgrep -af 'bash ./start_app.sh'
kill -TERM <start_app_pid>
访问地址:
OpenWebUI:http://<服务器IP>:7860
API:      http://<服务器IP>:8080/v1
监控:     http://<服务器IP>:8899
默认模型:
qwen3.8-flash-next
 认证作者