Qwen3.8-27B-DFlash2
4090要起飞!Qwen3.8-27B-4.0bpw-EXL3 + DFlash2-EXL3 + 优化的 ExLlamaV3
运行环境
4090显卡要起飞!实现token自由!
基于Qwen3.8-27B-4.0bpw-EXL3 + DFlash2-EXL3 + 优化的 ExLlamaV3
该在40系列显卡上面测试通过 其他待测试
理论上大于24gb显存的卡都可以
支持webUI在线对话 和 OpenAI格式接口接入本地工具推理使用
推荐接入 codex cli或 chagpt桌面客户端等支持openAI格式的客户端进行使用
使用视频教程见下面飞书文档:
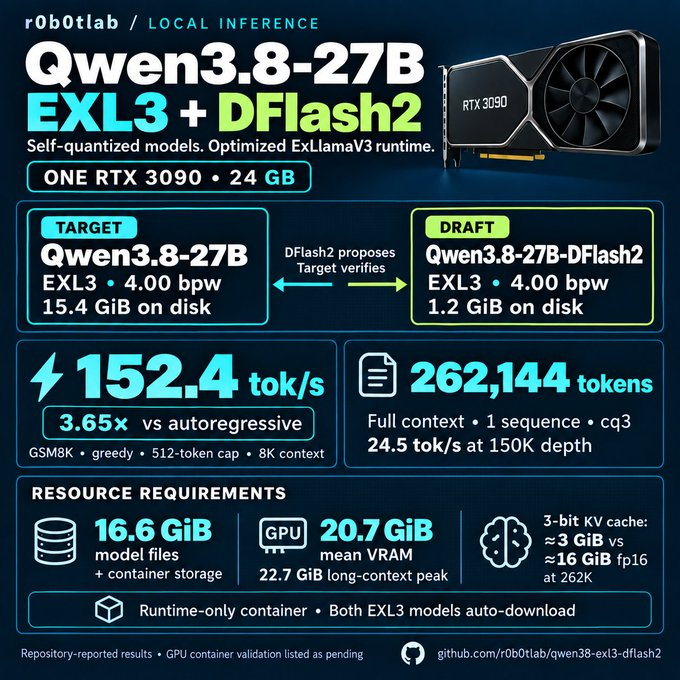
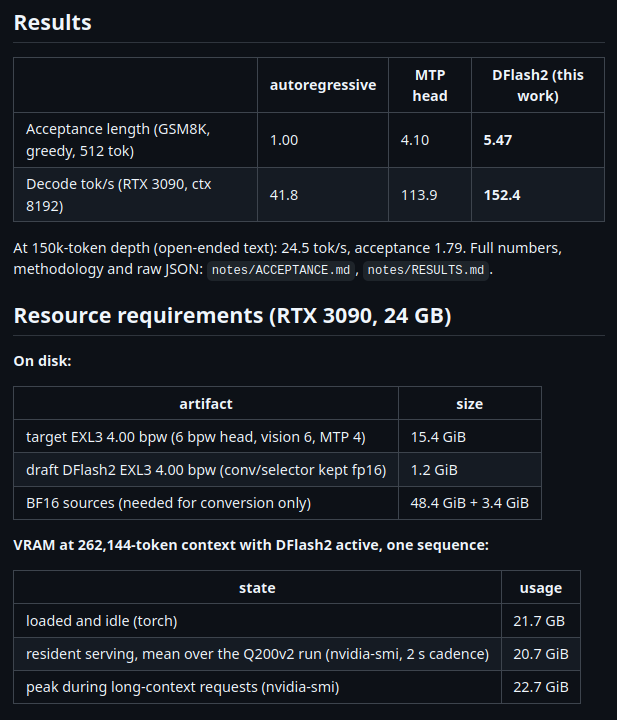
3090显卡测试数据:
交流加群
bug反馈可以加入科哥专属群交流➕ 广告勿进!
- 已经设置开机运行 首次开机 1-2分钟
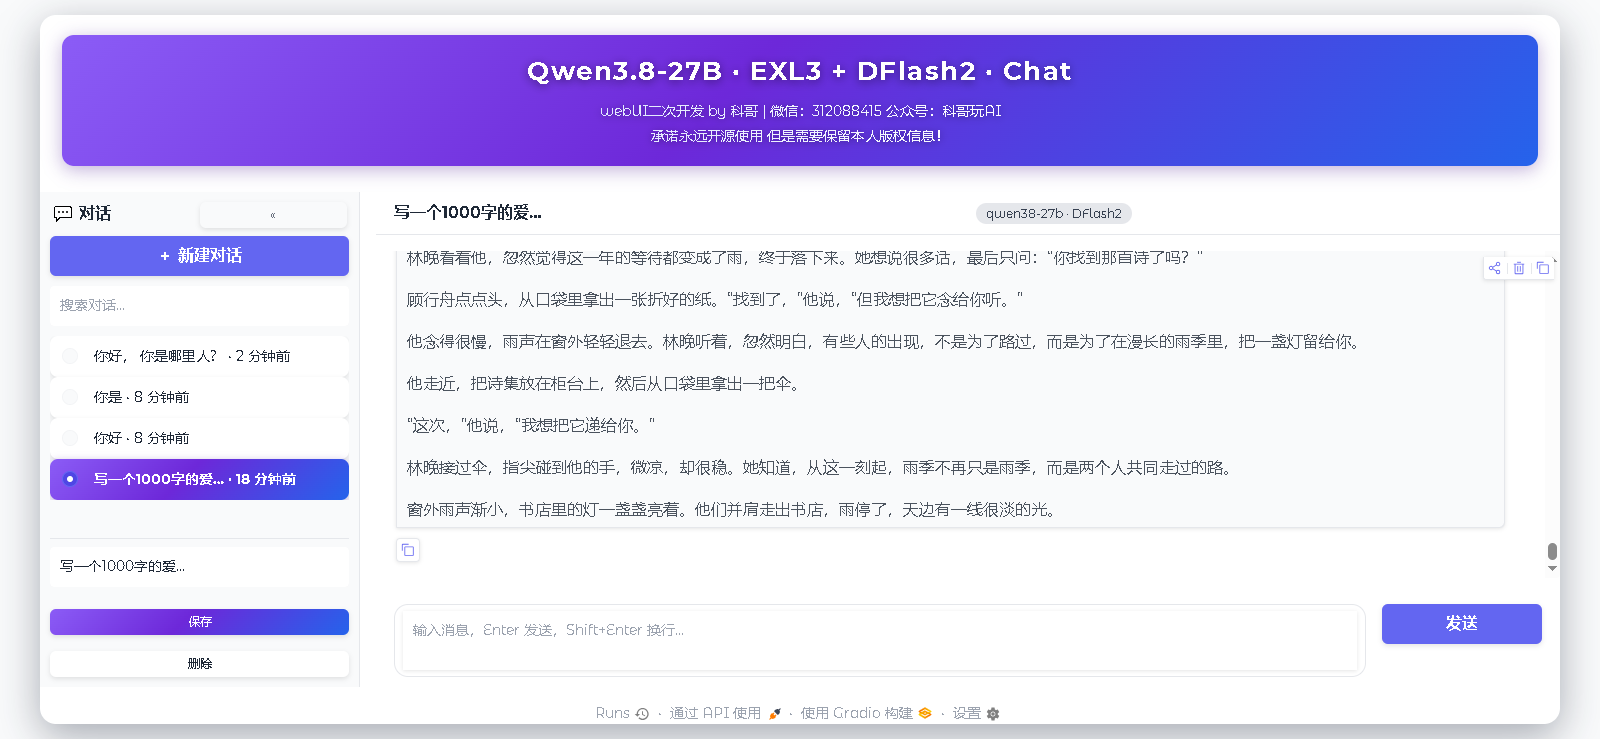
webUI使用界面截图
-
【插入一个小广告 给需要做ai视频,图片,短剧等多一个选择】:
-
企业高并发AIGC接口无限画布平台: https://api.api4me.xyz
-
✅ sd2.5满血933全参按条4-30秒9.x元一条
-
✅ gpt-image2/香蕉低至几分钱一张
-
✅更多特价AI模型接入中
-
✅主打廉价稳定模型中转站推荐:https://vip.kegeai.top
-
✅搞到一个国际版的在线sd2.0模型1.x元十五秒,也支持API调用
-
✅GPT模型编程模型推荐:
-
✅如果你需要满血得的GPT模型
-
✅请大胆尝试:https://ai.aiaiai001.com/
-
✅GPT pro号池最低0.3x倍率节省90%+费用
-
✅pro 100+单个用户最高并发 满血使用
-
在线图片、视频生成网站哈基米AI聚合平台:https://link8.lk888.ai/
-
✅杀疯了!!!在线sd2.5模型最低6毛钱一秒!!!
-
✅ai大模型:gpt,claude,gemini,deepseek...数百种主流模型
-
✅最新图片模型:gpt-image2,香蕉2,香蕉pro,即梦,豆包,万相...
-
✅最新视频模型:sd2,快乐马,grok,veo3,sora2,vidu,可灵...
-
✅并发高,收费合理(价格优先速度优先)
-
以上模型均支持API,龙虾CLI接入,web浏览器在线使用!
-
企业高并发AIGC接口无限画布平台: https://api.api4me.xyz
-
✅ gpt-image2.5 几分钱特价中!
-
✅ gpt-image2/香蕉低至几分钱一张
-
✅性价比sd2 sd2-fast sd2-mini过真人脸在线生成
-
✅MiniMax H3
-
✅veo3-fast视频几毛八秒
-
✅更多特价AI模型接入中
-
技术微信:312088415
- ✅Seedance火山引擎-企业白名单使用教程: https://icndm2oxbr60.feishu.cn/docx/Hs3fd8qMgo1pYaxodxYc2en9nYd?from=from_copylink
Qwen3.8-27B EXL3 + DFlash2 用户使用手册
本文档面向已经搭好环境的用户,只讲「如何用」:从启动、网页聊天、API 调用,到主要功能和常见问题。安装、转换、构建相关内容请参考项目根目录的 README.md 与 notes/ 下的设计文档。
1. 这是什么
一套在本机显卡上运行的本地大模型服务:
- 主模型:Qwen3.8-27B 的 EXL3 4.00 bpw 量化版(
models/qwen38-27b-exl3) - 加速器:DFlash2 投机解码模型(
models/dflash2-exl3),由本项目改造的 ExLlamaV3 引擎驱动 - 完整支持模型声明的 262,144 token 长上下文
- 单进程同时对外提供两种入口:
- OpenAI 兼容 API(端口
7890)—— 供 curl、Python、Codex CLI 等任何 OpenAI 客户端使用 - Web 聊天界面(端口
7860)—— Gradio 网页,浏览器直接聊天
- OpenAI 兼容 API(端口
典型性能(RTX 3090 24 GB):DFlash2 投机解码约 152 tok/s(对比自回归 42 tok/s),GSM8K 平均接受长度 5.47;150k 深度长文本 24.5 tok/s。详细结果见 notes/RESULTS.md。
2. 架构与端口一览
                    ┌─────────────────────────────────────────────┐
   浏览器  ──7860──► │ chat_web.py(Gradio 网页代理,纯 CPU)      │
                    │   └─► 转发 /v1/chat/completions(SSE 流式)  │
                    └───────────────┬─────────────────────────────┘
                                    │
  OpenAI 客户端 ──7890──► ┌─────────▼─────────────────────────────┐
  (curl / Codex CLI ...)  │ serve_openai.py(模型进程,唯一占用    │
                          │ GPU 的进程)──► EXL3 目标 + DFlash2 草稿│
                          └───────────────────────────────────────┘
| 端口 | 服务 | 进程 | 是否占 GPU |
|---|---|---|---|
| 7890 | OpenAI 兼容 API | scripts/serve_openai.py | 是(模型常驻) |
| 7860 | Web 聊天界面 | scripts/chat_web.py | 否(纯转发) |
两个端口同时运行不会加倍显存:模型只在 7890 加载一次,7860 只是 HTTP 中继。
3. 启动
3.1 一键启动(推荐):./start.sh
./start.sh
脚本会自动做两件事:
- 探测
http://127.0.0.1:7890/health:- API 没在运行 → 后台拉起
start_openai.sh(加载模型,数秒到数十秒),轮询等待就绪; - API 已在运行 → 直接复用,不会重复加载。
- API 没在运行 → 后台拉起
- 启动 Gradio 网页聊天,监听
0.0.0.0:7860。
启动成功的标志:
curl -s http://127.0.0.1:7890/health
# {"status": "ok"}
浏览器打开 http://127.0.0.1:7860 即可聊天。
3.2 只启动 API
./start_openai.sh
# 或自定义参数手动启动
python scripts/serve_openai.py \
  --target models/qwen38-27b-exl3 \
  --draft  models/dflash2-exl3 \
  --host 0.0.0.0 --port 7890 \
  --model-name qwen38-27b-exl3-dflash2 \
  --cache-tokens 270336 --cq 3 \
  --api-key "$API_KEY"
3.3 环境变量(全部可选)
| 变量 | 作用 | 默认值 |
|---|---|---|
HOST / PORT | API 绑定地址 / 端口 | 0.0.0.0 / 7890 |
MODEL_NAME | /v1/models 中广告的模型名 | qwen38-27b-exl3-dflash2 |
CACHE_TOKENS | KV cache 长度(token)。调低可省显存、加快启动 | 270336 |
CQ | KV cache 量化位数(3/4/6/8/16)。越小越省显存 | 3 |
API_KEY / OPENAI_API_KEY | API 访问密钥(/v1/* 需认证) | 空 = 不鉴权 |
WEB_HOST / WEB_PORT | 网页界面绑定/端口 | 0.0.0.0 / 7860 |
API_HOST / API_PORT | start.sh 健康检查与转发目标 | 127.0.0.1 / 7890 |
SESSIONS_FILE | 网页端历史对话持久化文件(JSON) | notes/chat_sessions.json |
密钥优先级:API_KEY 环境变量 → OPENAI_API_KEY → 本机密钥文件 notes/.api_key(单行内容)。start.sh 会把密钥同时传给 API 与网页代理,保证两边一致;notes/.api_key 已被 .gitignore 忽略,测试机当前内容为 test-secret-123,正式使用请更换成自己的密钥。
3.4 其它启动方式(容器)
项目发布了一键容器镜像(首次运行自动下载模型,占用约 17 GB 磁盘):
# 交互式聊天(模型由卷挂载,默认全上下文)
docker run -it --rm --gpus all -v "$PWD/models:/models:ro" qwen38-exl3-dflash2:1.5.0

# 一次性问答(headless)
docker run --rm --gpus all -v "$PWD/models:/models:ro" \
  -e PROMPT="Explain photosynthesis in one sentence." -e EXTRA_ARGS="-basic -tps" \
  qwen38-exl3-dflash2:1.5.0
3.5 查看与停止
# 查看两个服务是否在监听
ss -ltnp | grep -E ':(7860|7890)'

# 查看进程
ps aux | grep -E 'serve_openai|chat_web'

# 停止网页界面(前台进程,Ctrl+C 或 kill 对应 PID)
# 停止 API(模型进程)后,整个环境才算真正停掉
kill <serve_openai 的 PID>
start.sh前台只是网页进程;它后台拉起的 API 会继续运行,停止时两者都要处理。
4. 使用 Web 聊天界面(7860)
- 浏览器访问
http://127.0.0.1:7860。 - 在输入框提问,
Enter发送、Shift+Enter换行;输入框默认 2 行高,文字较多时会在输入框内滚动显示,不会撑高页面。回答以流式逐字出现。 - 界面功能:
- 页面主题:整体宽 95%、左右各留 2.5% 空白;顶部为紫蓝渐变横幅,居中显示项目标题与版权副标题(白字带阴影)。页面背景与横幅同为紫蓝渐变;侧栏选中项与「保存」按钮也使用同款紫蓝渐变。
- 输入框高度:输入框高度为常规的 2 倍(默认 2 行);文字较多时输入框内出现滚动条,可滚动查看更多内容。
- 自动跟随最新回复:AI 回答内容较多时,聊天区会随输出逐行动态向下滚动(旧内容向上隐藏),始终让用户看到 AI 最新的回复文本;回答结束后仍可自由向上滚动查看更早内容。
- 历史对话侧栏(左侧):列出所有历史对话(最近的在最上面),并显示相对时间(如「刚刚」「3 分钟前」)。被选中的对话会以紫蓝渐变高亮显示;点击任意一条即可打开该对话,聊天区的消息会自动滚动到底部;向上滚动可查看这条对话更早的内容。
- 收起 / 展开侧栏:点击侧栏左上角的「«」收起左侧栏;收起后聊天区占满整个宽度,页面最左侧会显示一个「» 展开对话」标签,点击即可再次展开。
- 新建对话:点击「+ 新建对话」清空聊天区开始新话题,不会影响已保存的历史。
- 自动命名:新对话默认用第一条提问的前 10 个字符作为标题(不足 10 字则取全部,如「请详细解释一下量子纠…」)。
- 搜索对话:侧栏顶部有搜索框,输入关键词即可按对话标题过滤历史记录。
- 重命名:选中对话(或打开它)后,「重命名」框已预填当前标题,改成新名称后点「保存」(蓝紫色主题按钮)。
- 删除:选中对话后点「删除」。若删除的正是当前打开的对话,聊天区会一并清空。
- 历史持久化:所有对话保存到
notes/chat_sessions.json(可用SESSIONS_FILE覆盖),重启网页/服务器后仍可打开查看。 - 思考过程实时显示:模型先输出推理(reasoning),再输出正式回答,两者都会滚动显示,不会出现长时间空白。
- 多轮对话:保留历史上下文,可连续追问。
- 并发限制 1:页面排队串行请求后端(
concurrency_limit=1),与 API 共用同一模型进程。
网页本身只是代理,真正的文本渲染、上下文管理都在 7890 的模型进程里完成。
5. 使用 OpenAI 兼容 API(7890)
5.1 认证
/health、/v1/health:免认证,供健康检查。- 其余
/v1/*接口需要请求头中的密钥,两种写法任选:Authorization: Bearer <key>X-API-Key: <key>
- 密钥与运行 API 时
--api-key(或环境变量)一致。常见配置:KEY=$(cat notes/.api_key) # 读取本机密钥,例如 test-secret-123
5.2 端点总览
| 方法 | 路径 | 说明 |
|---|---|---|
| GET | /health | 健康检查(无需认证) |
| GET | /v1/models | 模型列表,含 max_model_len(262144) |
| POST | /v1/chat/completions | 聊天补全,支持流式与非流式、工具调用 |
| POST | /v1/chat/completions/render | 只返回 chat-template 编码后的 token id(调试/评测用) |
| POST | /v1/responses | Responses API(Codex CLI 使用),支持流式、input 字符串/列表、工具 |
| POST | /v1/completions | 原始续写:接受 prompt 字符串或 token id 列表,非流式 |
统一约定:
- 模型名:
qwen38-27b-exl3-dflash2(可用model字段指定,缺省用服务默认名)。 - 生成长度:
max_tokens或max_completion_tokens,缺省 4096。 - 采样:
temperature,缺省0(贪心);>0走带 q-aware 拒绝采样的随机路径。 finish_reason:stop/length/tool_calls。- 排队:单 worker FIFO,请求先后依次执行;单长期请求完成前,后续请求排队等待。
5.3 聊天补全示例
非流式:
curl -s http://127.0.0.1:7890/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $(cat notes/.api_key)" \
  -d '{
    "model": "qwen38-27b-exl3-dflash2",
    "messages": [{"role": "user", "content": "用一句话解释什么是光合作用。"}],
    "max_tokens": 128
  }'
返回结构遵循 OpenAI 格式,额外包含 reasoning_content(模型思考过程)字段:
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": "光合作用是植物利用阳光把二氧化碳和水转成有机物并释放氧气的过程。",
      "reasoning_content": "用户问的是定义,需要用一句话概括。"
    },
    "finish_reason": "stop"
  }],
  "usage": {"prompt_tokens": 24, "completion_tokens": 38, "total_tokens": 62}
}
流式(SSE):加 "stream": true,逐 token 返回 data: 行,结尾 data: [DONE]:
curl -sN http://127.0.0.1:7890/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $(cat notes/.api_key)" \
  -d '{"model":"qwen38-27b-exl3-dflash2",
       "messages":[{"role":"user","content":"数到 3"}],
       "stream":true}'
流式过程中:思考阶段输出 delta.reasoning_content,正式回答输出 delta.content;若触发了工具调用,最后会有一条带 delta.tool_calls 的块且 finish_reason="tool_calls"。
5.4 工具调用(function calling)
请求中传 tools,模型会使用 Qwen 原生 XML 语法调用,服务端自动解析为 OpenAI 的 tool_calls 格式:
curl -s http://127.0.0.1:7890/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $(cat notes/.api_key)" \
  -d '{
    "model": "qwen38-27b-exl3-dflash2",
    "messages": [{"role": "user", "content": "40+2 等于多少?用计算器工具算。"}],
    "tools": [{
      "type": "function",
      "function": {
        "name": "calculator",
        "description": "计算两数之和",
        "parameters": {
          "type": "object",
          "properties": {"a": {"type": "number"}, "b": {"type": "number"}},
          "required": ["a", "b"]
        }
      }
    }]
  }'
返回示例(节选):
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": null,
      "tool_calls": [{
        "id": "call_xxxxxxxxxxxxxxxxxxxxxx",
        "type": "function",
        "function": {"name": "calculator", "arguments": "{\"a\": 40, \"b\": 2}"}
      }]
    },
    "finish_reason": "tool_calls"
  }]
}
要点:
"tool_choice": "none"可禁用工具;不传tools则纯文本对话。- 原始
<tool_call>XML 已从消息正文中剥离,不会与tool_calls重复。 - 拿到
tool_calls后由客户端执行工具,再把结果以role: "tool"(tool_call_id对应)回传,模型继续。
5.5 Responses API(Codex CLI 用)
/v1/responses 兼容 OpenAI Responses 格式,支持:
input既可以是字符串(等价单条 user 消息),也可以是消息条目列表:{"input": "你好"} {"input": [{"type": "message", "role": "user", "content": "你好"}]}instructions(系统指令)、tools、max_output_tokens、temperature。- 流式:
"stream": true,事件序列response.created → response.in_progress → … → response.completed,符合 Codex CLI 预期。
5.6 原始续写 /v1/completions
# 字符串 prompt
curl -s http://127.0.0.1:7890/v1/completions \
  -H "Authorization: Bearer $(cat notes/.api_key)" -H "Content-Type: application/json" \
  -d '{"prompt": "The capital of France is", "max_tokens": 16}'

# 或直接给 token id 列表(NIAH 等评测场景常用)
curl -s http://127.0.0.1:7890/v1/completions \
  -H "Authorization: Bearer $(cat notes/.api_key)" -H "Content-Type: application/json" \
  -d '{"prompt": [151644, 8948, 13], "max_tokens": 16}'
5.7 精确渲染 token id
需要拿到「经过 chat template 编码后的完整 token id」(评测、注入测试常用):
curl -s http://127.0.0.1:7890/v1/chat/completions/render \
  -H "Authorization: Bearer $(cat notes/.api_key)" -H "Content-Type: application/json" \
  -d '{"messages": [{"role": "user", "content": "hi"}], "chat_template_kwargs": {}}'
# {"token_ids": [151644, 8948, 13, ...]}
5.8 Python 调用(openai SDK 或 requests)
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:7890/v1",
    api_key="test-secret-123",   # 与 notes/.api_key 一致
)

resp = client.chat.completions.create(
    model="qwen38-27b-exl3-dflash2",
    messages=[{"role": "user", "content": "讲一个笑话"}],
    stream=True,
)
for chunk in resp:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
5.9 接入 Codex CLI
把本地服务当作模型供应商接入 Codex CLI(示例配置,加入 ~/.codex/config.toml):
model = "qwen38-27b-exl3-dflash2"
model_provider = "local"

[model_providers.local]
name = "Local Qwen3.8-27B (EXL3 + DFlash2)"
base_url = "http://127.0.0.1:7890/v1"
env_key = "LOCAL_API_KEY"
wire_api = "responses"
并把环境变量 LOCAL_API_KEY 设置为与 notes/.api_key 相同的内容,然后在项目目录运行 codex 即可。服务端实现了 /v1/responses 的事件流与工具调用,适配 Codex 的编程代理流程。
6. 主要功能特性一览
| 特性 | 说明 |
|---|---|
| DFlash2 投机解码 | 默认启用,无需配置;加速约 3–3.5 倍(152 vs 42 tok/s),解码分布与自回归无损一致 |
| 262k 长上下文 | 满上下文 KV cache(cq3 量化)单序列可跑通;150k 深度仍可达 ~24 tok/s |
| 思考型推理流 | reasoning_content 与 content 分离输出,流式与非流式均支持 |
| 工具调用 | Qwen 原生 XML 自动解析为 OpenAI tool_calls 格式,/v1/chat/completions 与 /v1/responses 均支持 |
| SSE 流式 | /v1/chat/completions、/v1/responses 均支持流式输出 |
| API Key 认证 | Authorization: Bearer 或 X-API-Key;/health 免认证 |
| OpenAI 兼容 | /v1/models、/v1/chat/completions、/v1/completions、/v1/responses 一应俱全,Codex CLI、openai SDK 即插即用 |
| 单进程架构 | 一次加载同时服务 API 与网页,不重复占显存 |
7. 运维与评测脚本
模型服务之外的辅助脚本(均在 scripts/):
| 脚本 | 用途 |
|---|---|
vram_budget.py | 显存预算核算:python scripts/vram_budget.py 4.0 4(bpw、cq) |
acceptance_check.py | GSM8K 接受长度基准:--draft models/dflash2-exl3 / mtp / none |
long_context_check.py | 全上下文(约 200k token)预填 + 续写压测,输出 tok/s、接受率、显存 |
niah_multikey.py | 多针 NIAH 长上下文检索评测(走本地 API,2n/3n 变体) |
sampled_sanity_check.py | T>0 采样分布一致性检查(DFlash2 vs 自回归) |
concurrency_check.py | 1/2/4/8 并发序列吞吐扫描(单次模型加载) |
sample_telemetry.sh | 每 2 秒采集功耗/温度/显存/内存到 TSV:scripts/sample_telemetry.sh out.tsv |
check_dflash2_history_guard.py | 校验 DFlash2 草稿附加守卫(PR 验证用) |
这些脚本直接加载模型跑基准,运行时会与 7890 服务争用显存,评测前请先停掉服务进程。
8. 日志
| 文件 | 内容 |
|---|---|
notes/api.log | API 服务日志:启动横幅、READY、每次请求的 [http] 访问行、500 异常堆栈 |
notes/webui.log | start.sh 启动网页的日志(Gradio 输出) |
notes/serve.log 等 | 基准评测记录(acceptance/long-context/…) |
判断模型加载完成:日志出现 [serve] READY 且 /health 返回 200。异常请求的堆栈会写入 notes/api.log 末尾(stderr 已显式 flush),报 500 时先看这里。
9. 常见问题(FAQ)
Q1:网页(7860)发消息报 401 Client Error: Unauthorized ... /v1/chat/completions
A:网页代理没有带上与 7890 一致的密钥。把当前 API 的密钥写入 notes/.api_key(或设 API_KEY 环境变量),然后重启 ./start.sh。start.sh 会自动把同一密钥传给两边。
Q2:curl 7890 返回 401
A:/v1/* 需要 Authorization: Bearer <key> 或 X-API-Key: <key>;只有 /health 免认证。确认 key 与 API 进程的 --api-key 一致。
Q3:显存不够 / OOM A:
- 降低
CACHE_TOKENS(如270336 → 16384),KV cache 随之变小,可显著降低显存并加快启动; CQ用 3(3-bit KV cache 最省显存);- 保持单序列(并发每加一路约多占 ~1.2 GB 校验历史);
- 确认没有第二个加载模型的进程在跑(
ps aux | grep serve_openai)。
Q4:页面一直不输出,像卡住了一样
A:模型先输出思考过程(reasoning)再输出答案,是正常的两段式;当前网页已实时显示思考内容。若长时间无任何输出,看 notes/api.log 是否有报错或 500 堆栈。
Q5:两个端口同时跑会不会加倍占显存? A:不会。模型只在 7890 加载一次;7860 是纯 CPU 的 Gradio 代理。
Q6:请求排队等很久 / 多用户同时用
A:服务是单 worker FIFO,一次只跑一个生成任务,长请求会阻塞后面的请求。网页端 concurrency_limit=1 本身串行,接口保持简单可靠;需要并发请在评测场景用 scripts/concurrency_check.py 评估显存与吞吐后再自行改造。
Q7:长上下文(>50k)很慢正常吗? A:正常。预填/深度解码成本随上下文增长;150k 深度约 24 tok/s。小对话(数千 token)内则接近 152 tok/s。
Q8:工具调用返回的 arguments 是 JSON 字符串,怎么执行?
A:客户端解析 tool_calls[].function.arguments(json.loads)后自行调用本地函数,再把结果以 role:"tool"、tool_call_id 对应回传即可。模型返回的 content 已剥离原始 XML。
Q9:如何不让模型调用工具?
A:请求里传 "tool_choice": "none",或不传 tools 字段。
Q10:stream=true 时连接 / 结束标志
A:SSE 以 data: [DONE] 结束;/v1/chat/completions 与 /v1/responses 都遵循 OpenAI 事件格式。/v1/completions 暂不支持流式,会返回 400。
Q11:重启后 notes/api.log 没有报错却一直 500
A:这是旧版服务的表现;当前版本已在 500 时把异常堆栈 flush 进 notes/api.log。若仍只有 [http] 行,确认运行的是最新代码(git status 无未提交的 serve_openai.py 改动之外的变化)后重启。
Q12:CACHE_TOKENS 与 --max-model-len 的关系
A:--max-model-len(默认 262144)是广告给客户端的模型最大长度;--cache-tokens 决定实际分配的 KV cache 容量。两者配合使用:只要 cache-tokens >= max-model-len 就能跑完整上下文;显存吃紧时优先减小 cache-tokens。
Q13:浏览器访问 7860 提示 Internal Server Error
A:看 notes/webui.log。多为依赖版本问题(例如旧版 Gradio 的 theme 参数用法),当前脚本按 Gradio 6.x 适配;版本不符时 pip install -r requirements.txt 升级后重试。
Q14:怎么确认模型真的加载了并处于可用状态?
A:三个信号:日志出现 [serve] READY;curl http://127.0.0.1:7890/health 返回 {"status":"ok"};curl /v1/models 能列出模型且 max_model_len 为 262144。
Q15:密钥丢了/想换
A:改 notes/.api_key(单行,无换行符之外的空白),重启 ./start.sh(API 若由脚本拉起会继承新 key)。若 7890 是手动启动的,需要同时用新 key 重启 API 进程。注意 notes/.api_key 不会提交到 git。
 认证作者