Comfyui AI漫剧生成器
ComfyUI 预装 MiniMax H3,不用下模型、不用装节点,开机就出 16:9 有声视频,声音和人物都可以自己定。
运行环境
ComfyUI + MiniMax H3 音视频生成
装好就能用的 ComfyUI,不用装环境、不用下模型。图片能直接变视频,文字能直接做音乐,是你最好的AI漫剧生成器,生成视频直接带人物声音
开箱即用的 ComfyUI 环境,预装 MiniMax H3(Ref2VA / FL2VA) 音视频生成全链路:
输入「参考图 + 参考音频 + 提示词」,直接产出带声音的视频,支持首尾帧控制、音色锁定、16:9 / 9:16 双画幅。
不需要下载模型、不需要装节点、不需要配环境,开机即可出片。
一、这个镜像能干什么
- 参考图生视频(Ref2VA):1–9 张参考图锁住人物长相、服装、画风,最多 3 段参考音频锁音色
- 首尾帧生视频(FL2VA):给定首帧(可选尾帧)控制构图与运镜,0–2 张图
- 原生带音频:视频与声音同步生成,32kHz 立体声,不是后期配音
- 多画幅:16:9(1344×768)、9:16(768×1344)、1:1,短边 768
- 时长:4–15 秒 / 24fps(单镜头)
- 加速出片:内置 4 步 Turbo LoRA,一条 5 秒片约 60–90 秒出结果
- 附带生图能力:预置 Qwen-Image-Edit,可用于生成/编辑首帧图
典型用途:短剧 / 漫剧分镜、数字人口播、人物一致性创作、带台词的剧情片段,首尾帧生成视频、文字生成音乐、文字生成视频。
二、硬件要求
显卡显存
- 最低 24 GB:需用 int8 量化权重 + 低分辨率
- 推荐 32 GB 及以上(RTX 5090 / A6000 / L20)
系统盘
- 最低 60 GB,推荐 100 GB
- 模型已内置,系统盘只放环境
数据盘
- 最低 50 GB,推荐 100 GB
- 用于出片缓存 + 你自己的参考图 / 音频
带宽
- 按量计费实例即可
- 模型不再下载,开机无需长时间等待
本镜像在 RTX 5090 32G 上实测通过:1344×768 / 20 步 / 5 秒,约 5 分钟一条;864×480 / 4 步,约 68 秒一条。
三、详细部署步骤
步骤 1:选择镜像并创建实例
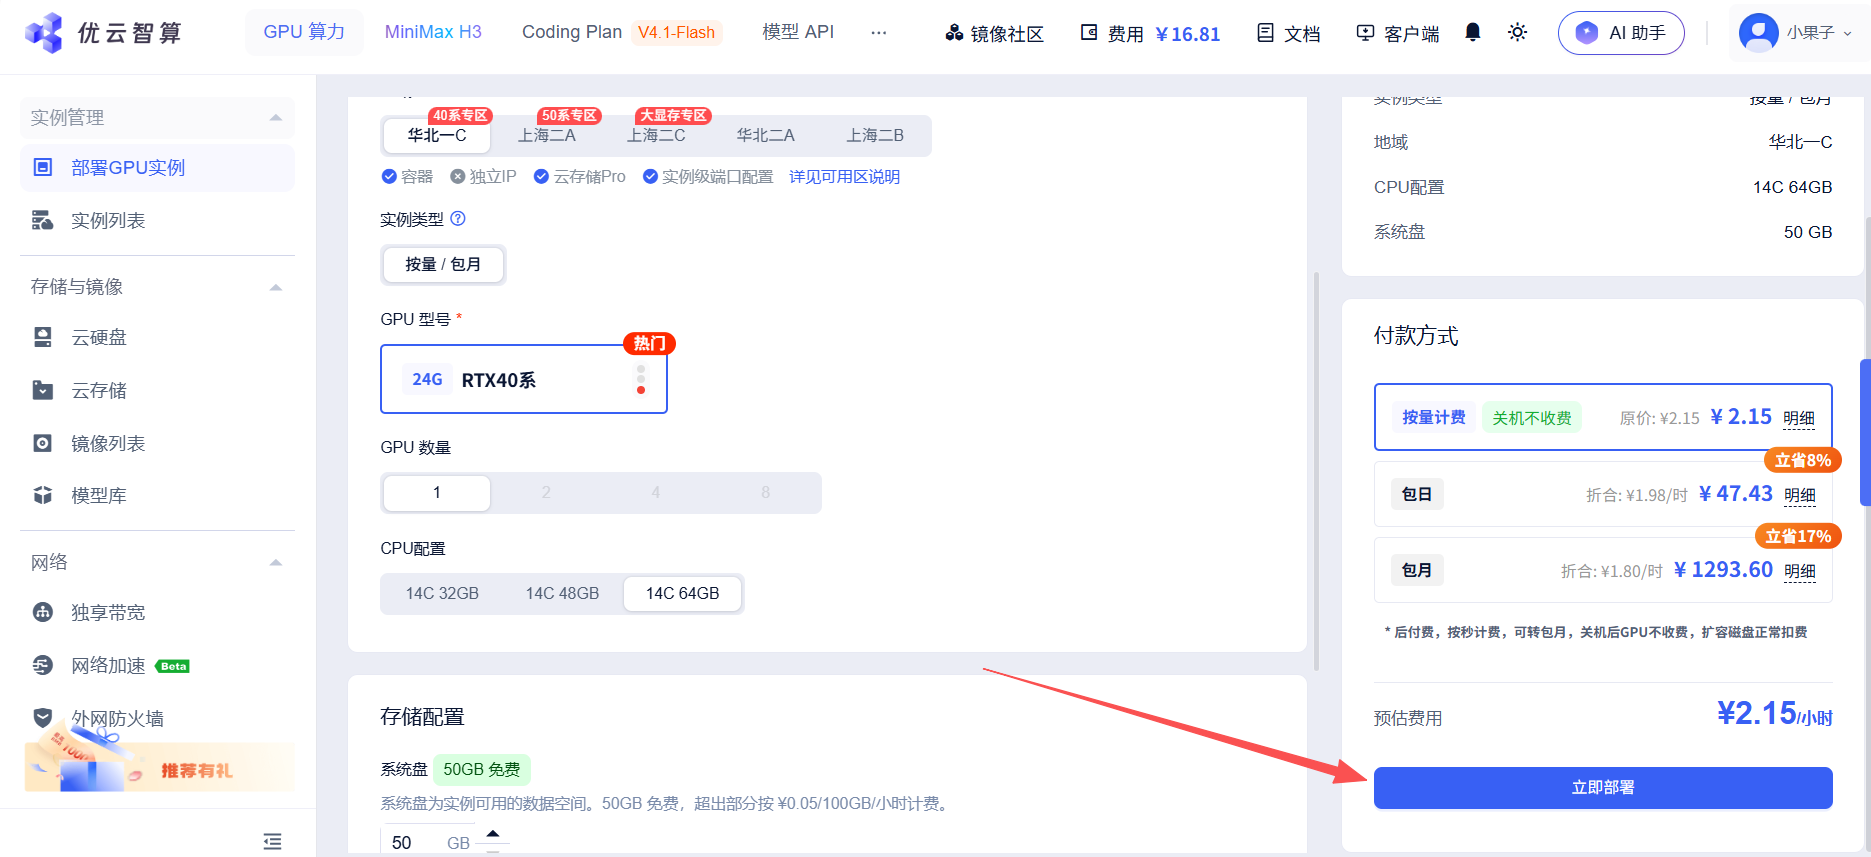
进入 部署 GPU 实例 页面,选择本镜像(Comfyui做漫剧_Minimax),确认实例配置: 地区任选有库存的可用区、实例类型选 容器/按量、GPU 型号选 32G 及以上(如 RTX 5090), 点击右下角 「立即部署」。
步骤 2:开机并获取访问地址
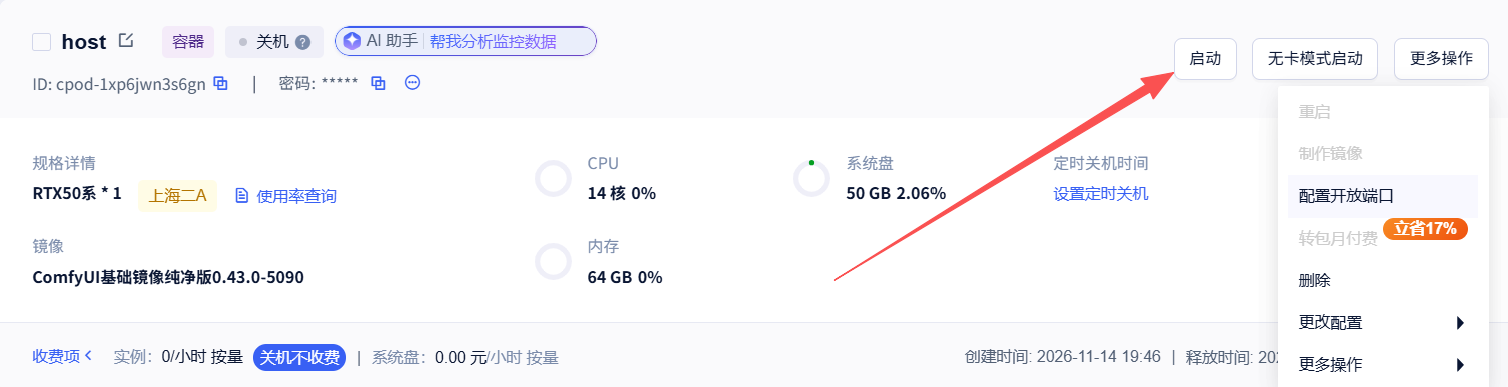
实例创建后约 1–3 分钟进入可启动状态。在实例详情页点击 「启动」, 开机后复制页面上的 公网 IP,ComfyUI 服务监听在 8188 端口。
⚠️ 如果页面提示需要开放端口/安全组,请确保 8188 已放行,否则浏览器访问会超时。
步骤 3:打开 ComfyUI
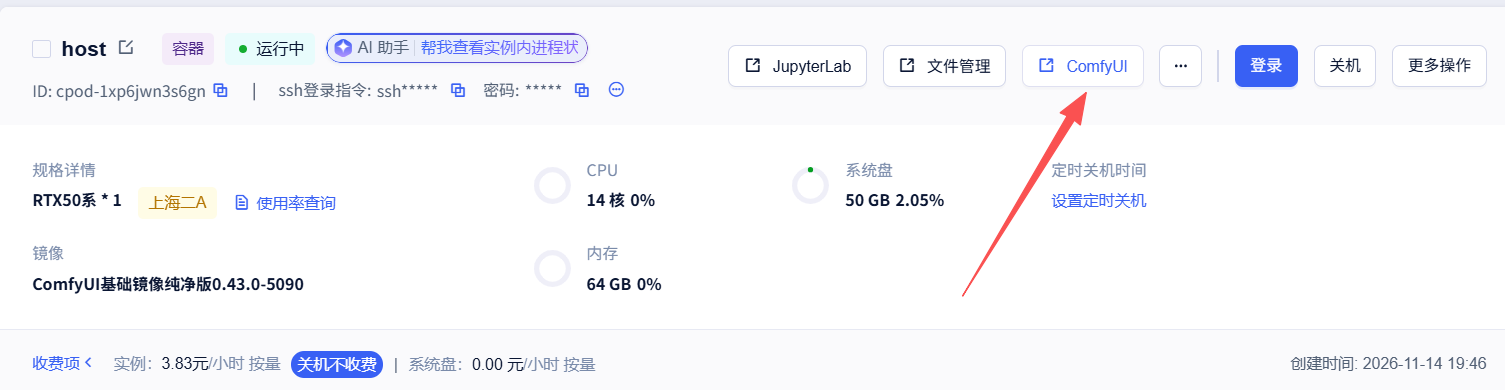
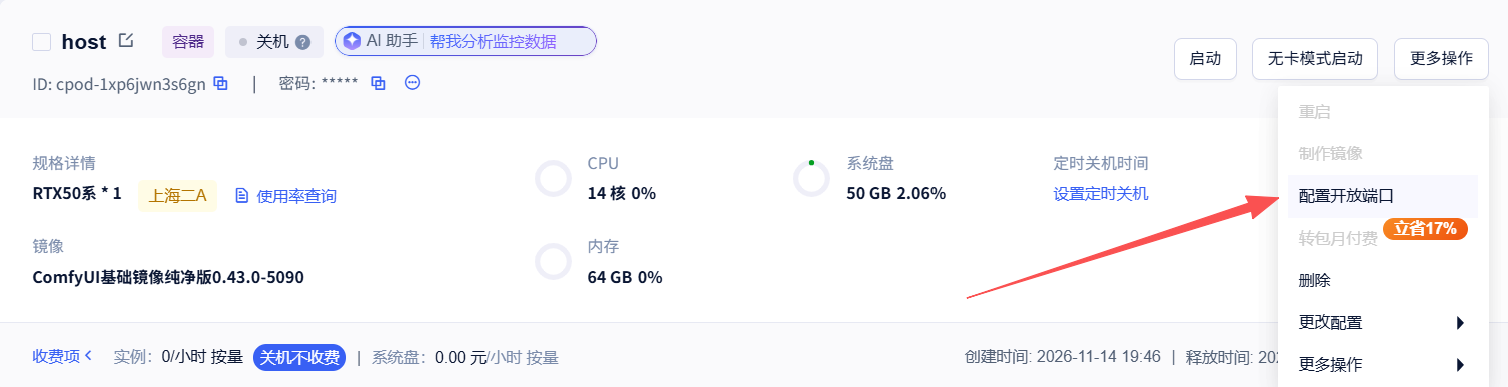
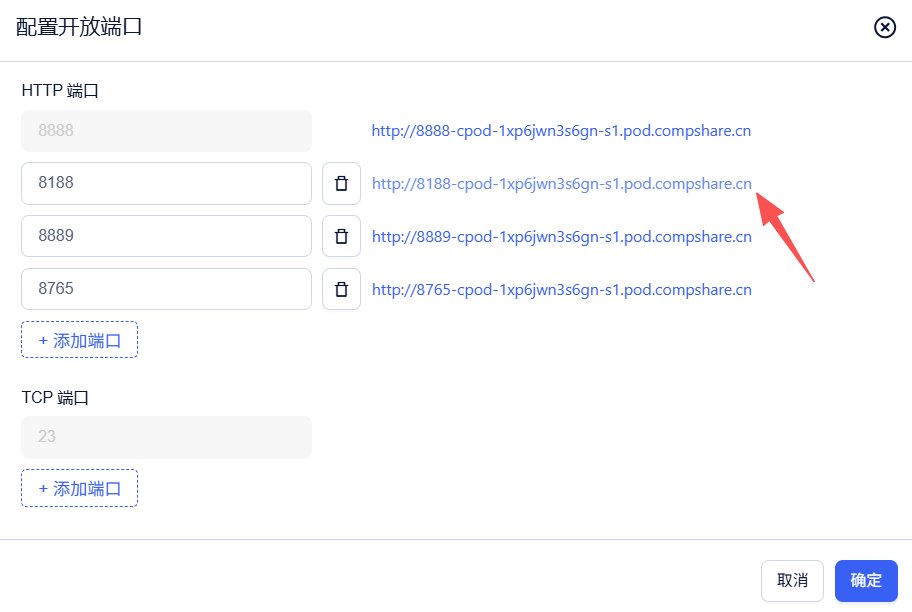 点击comfyui,看到 ComfyUI 的节点画布即表示环境正常,模型已就位,不需要任何额外安装。也可以点击配置开放端口,尾号是8188的那个链接打开。
步骤 4:打开内置工作流
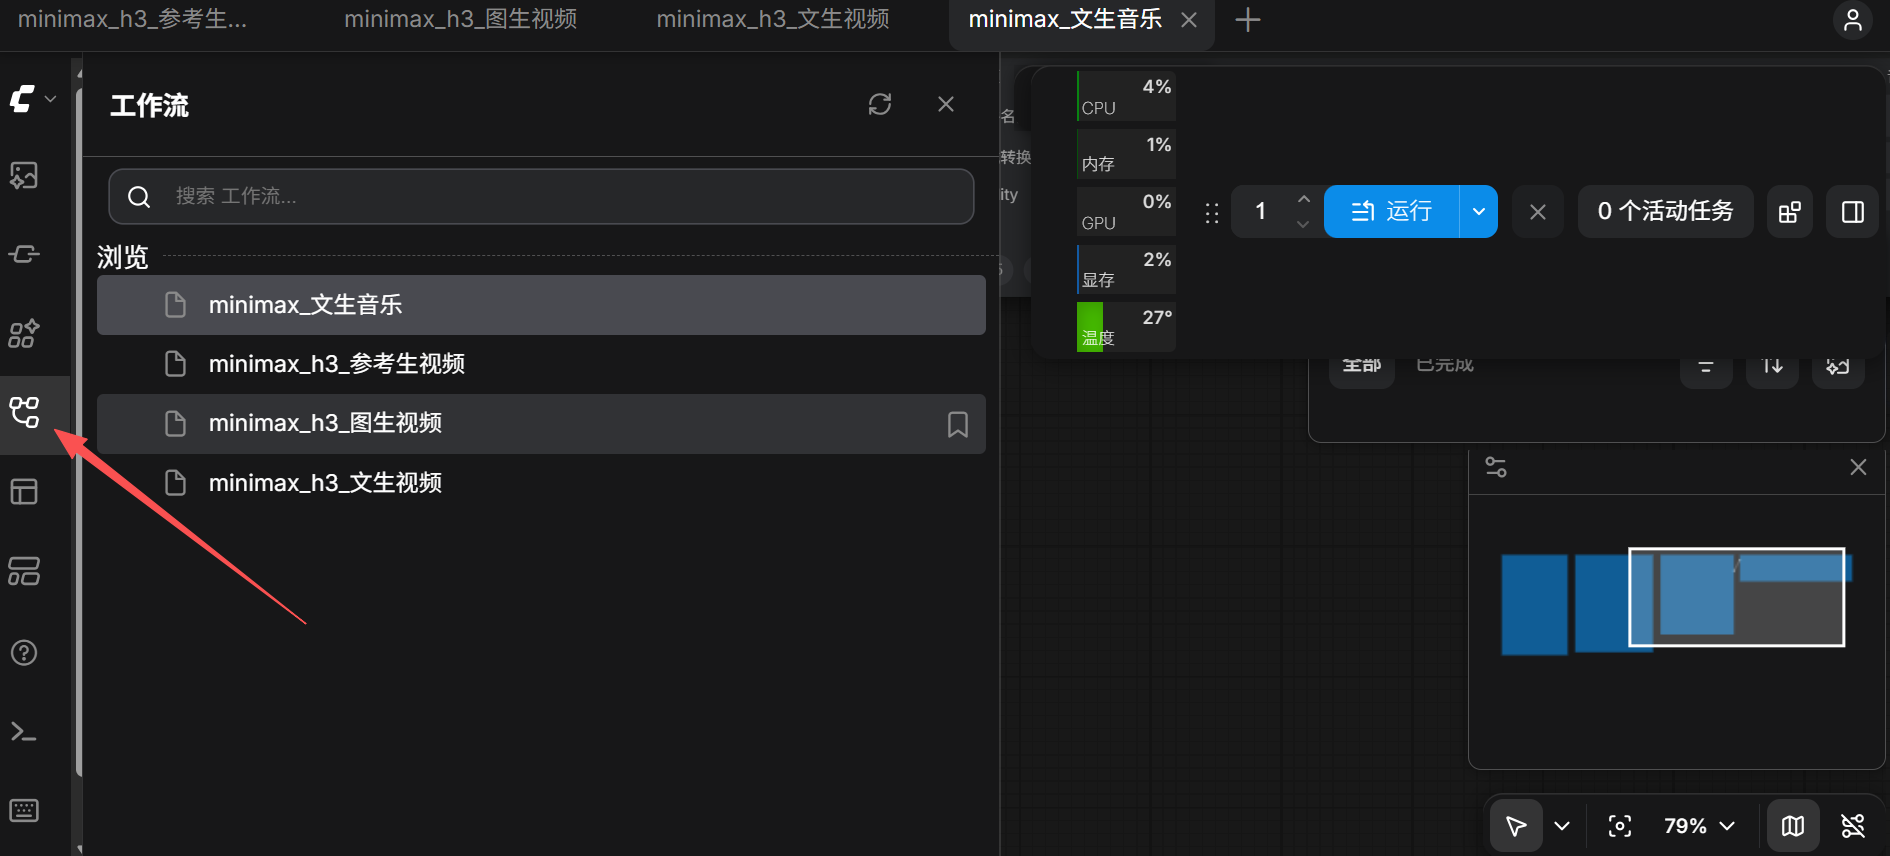
点击 ComfyUI 左侧边栏的「工作流」图标,列表里已预置 4 条可直接使用的工作流:
双击打开工作流,即可看到完整的节点接线图:
- minimax_h3_参考生视频:参考图锁人物 + 参考音频锁音色(做漫剧主用这条)
- minimax_h3_图生视频:首帧(+可选尾帧)生视频,可带音频
- minimax_h3_文生视频:纯文字描述生视频
- minimax_文生音乐:文字描述生成背景音乐
五、出片流程(首尾帧 / 参考生视频)
5.1 载入工作流
左侧边栏「工作流」列表里,双击 minimax_h3_参考生视频(要固定音色、用参考图锁人物时选它)。
5.2 三个输入怎么接
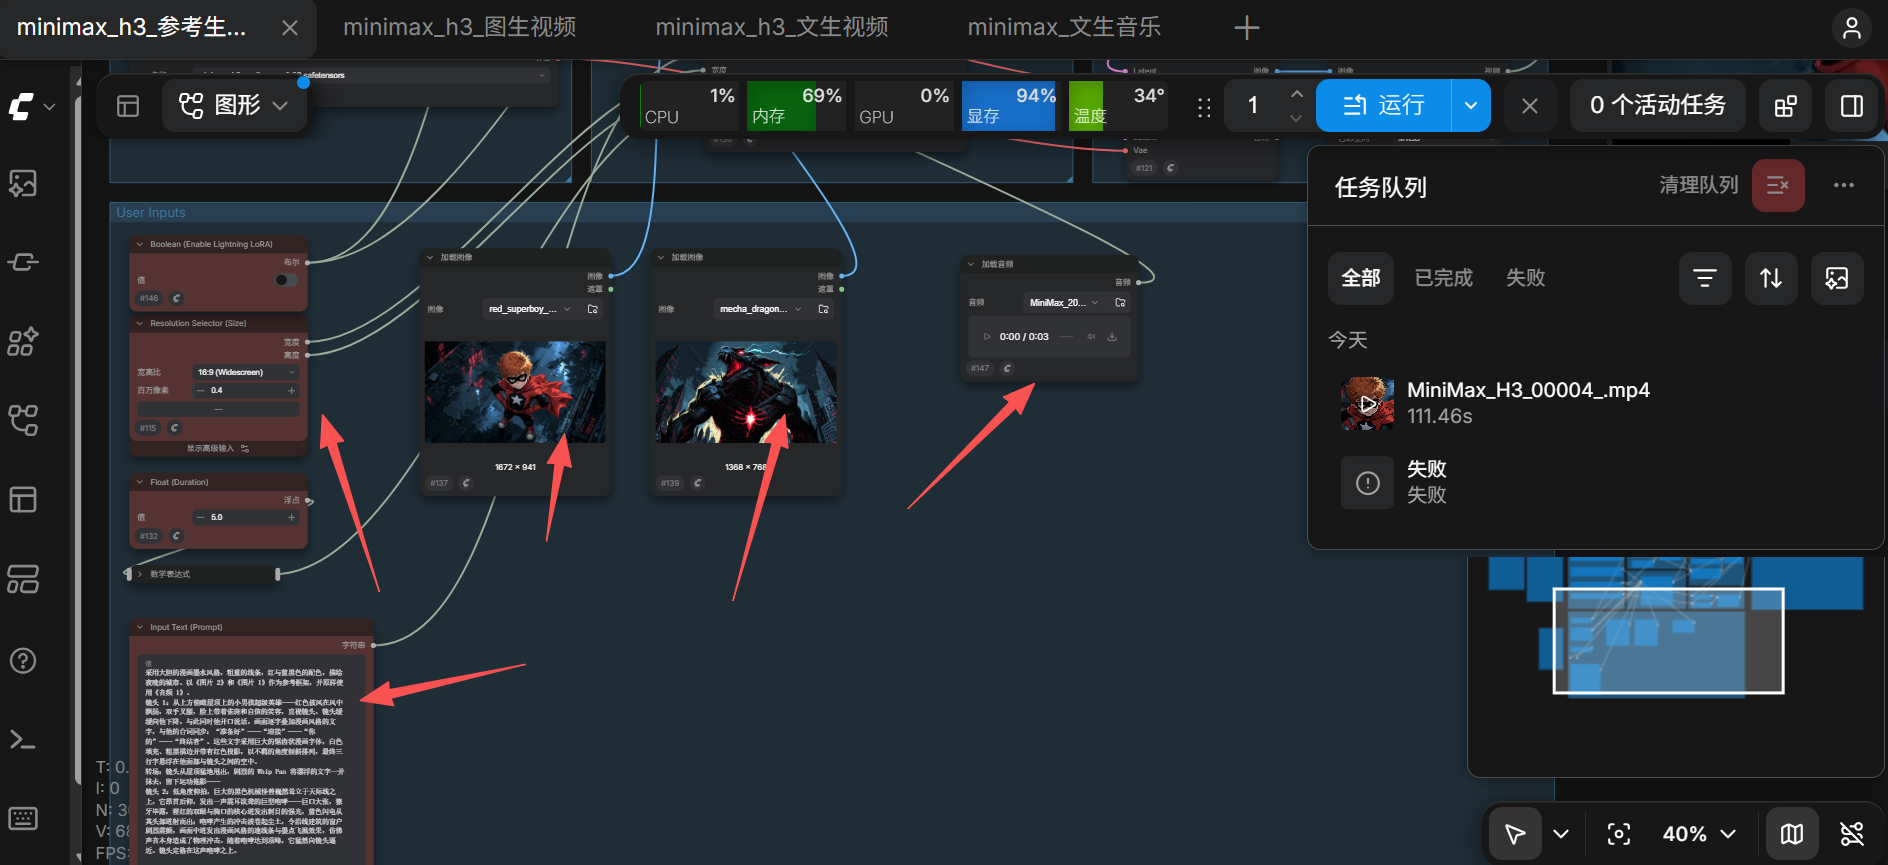
ref_image_0…:接角色定妆图 / 首帧图。建议 1–3 张同一人物不同角度,越清晰越像ref_audio_0:接一段 2–15 秒干净人声。这就是"固定声音",模型沿用该音色- 提示词:接镜头描述。用
<Picture 1>、<Audio 1>引用上面接入的图像与音频
接入音频:在音频里选择本地想要的声音,尽量是英文命名的.mp3格式。
接线顺序 = 提示词里的标签顺序:先接的图是
<Picture 1>,第一段音频是<Audio 1>。
5.3 参数建议
快速验证(试提示词、看走位,便宜)
- 分辨率 / megapixels:
0.40(约 864×480) - 步数 steps:
4(启用 Turbo LoRA) - 参考图像尺寸
ref_image_size:match - 时长:5 秒(124 帧)
- 单条耗时(RTX 5090):约 68 秒
定稿出片(正式交付,别省这一步)
- 分辨率 / megapixels:
0.98(1344×768) - 步数 steps:
20(关闭 LoRA,strength=0) - 参考图像尺寸
ref_image_size:max(保留五官细节,锁脸关键) - 时长:5–10 秒
- 单条耗时(RTX 5090):约 5 分钟
两种模式共用
- 比例:16:9(横屏)或 9:16(竖屏),出片分辨率随之变化,短边固定 768
帧数规则:
length必须满足(length − 5) % 17 == 0。 5 秒 → 124 帧,6 秒 → 141 帧,10 秒 → 243 帧。
帧数规则:
length必须满足(length − 5) % 17 == 0。 5 秒 → 124 帧,6 秒 → 141 帧,10 秒 → 243 帧。
5.4 提示词写法(有效模板)
16:9 写实电影质感,35mm 胶片颗粒。以 <Picture 1> 中人物的长相为准,
五官、脸型、年龄、发型完全一致,不要美化、不要换脸。
人物在室内自然说话,用 <Audio 1> 的音色和语速,说 <Audio 1> 里的台词,一字不改。
镜头缓慢推近,柔和自然光。
overall_soundscape: 安静的室内环境音,人声清晰靠前,无配乐。
三条经验:
- 不要用文字重复描述五官——一旦写"瘦削、颧骨高",模型会按文字重画一张脸,参考图就白给了。
- 标签顺序 = 连线顺序:先接的图是
<Picture 1>,第一段音频是<Audio 1>。 - 台词长度匹配时长:5 秒约 12–15 个字,超出会被截断。
5.5 运行与下载
点右上角 运行 / Run,任务进入右侧队列;完成后视频出现在右侧「任务队列」条目中,点击即可预览、下载。
六、常见问题
① 打开页面提示「缺模型」
- 原因:模板引用了镜像里未包含的权重(通常是 int8 版视频 VAE)。
- 解决:把 VAELoader 换成
minimax_h3_video_vae_fp16.safetensors。
② CUDA out of memory(爆显存)
- 原因:分辨率或时长过高。
- 解决:megapixels 降到 0.40(约 864×480),时长降到 5 秒,
ref_image_size先用match。
③ 生成的人物不像参考图
- 原因:
ref_image_size=match抹掉了五官细节,或提示词里重复描述五官抢了参考图的控制权。 - 解决:改成
max,并删掉提示词里所有五官描述,只写「脸照搬<Picture 1>」。
④ 声音有口音 / 不是想要的音色
- 原因:参考音频本身带口音,或混了背景音。
- 解决:换一段干净的标准音色样本(5–8 秒最佳,无 BGM 无混响)。
⑤ 上传图片 / 音频失败
- 原因:中文文件名。
- 解决:改成英文名(如
voice.mp3、face.png)。
⑥ 加载音频报 [mp3float] Header missing
- 原因:音频文件不是合法 MP3(扩展名被改过,或上传时文件被截断)。
- 解决:本地先确认能正常播放;重新导出为 44.1kHz MP3 或 WAV 再上传,文件名用英文。
⑦ 台词念错 / 自己编词
- 原因:H3 只借音色、不保证逐字复述。
- 解决:画面照常生成,后期用 TTS 原声替换音轨(口型已对齐)。
⑧ 视频末尾被截断
- 原因:视频时长 < 音频时长。
- 解决:视频时长设为音频时长 +1 秒。
⑨ 4 步出片脸糊
- 原因:Turbo LoRA 只保结构、不保细节。
- 解决:定稿阶段用 20 步 + 关闭 LoRA(
strength=0)。