ComfyUI漫剧音视频生成镜像
预装 MiniMax H3:参考图+参考音频一键生成带声音的视频,开机即用无需下载模型,适合 AI 漫剧/短剧生产
运行环境
开箱即用的 ComfyUI 环境,预装 MiniMax H3(Ref2VA / FL2VA) 音视频生成全链路: 输入「参考图 + 参考音频 + 提示词」,直接产出带声音的视频,支持首尾帧控制、音色锁定、16:9 / 9:16 双画幅。 不需要下载模型、不需要装节点、不需要配环境,开机即可出片。
一、这个镜像能干什么
| 能力 | 说明 |
|---|---|
| 参考图生视频(Ref2VA) | 1–9 张参考图锁住人物长相、服装、画风,最多 3 段参考音频锁音色 |
| 首尾帧生视频(FL2VA) | 给定首帧(可选尾帧)控制构图与运镜,0–2 张图 |
| 原生带音频 | 视频与声音同步生成,32kHz 立体声,不是后期配音 |
| 多画幅 | 16:9(1344×768)、9:16(768×1344)、1:1,短边 768 |
| 时长 | 4–15 秒 / 24fps(单镜头) |
| 加速出片 | 内置 4 步 Turbo LoRA,一条 5 秒片约 60–90 秒出结果 |
| 附带生图能力 | 预置 Qwen-Image-Edit,可用于生成/编辑首帧图 |
典型用途:短剧 / 漫剧分镜、数字人口播、人物一致性创作、带台词的剧情片段。
二、硬件要求
| 项 | 最低 | 推荐 | 说明 |
|---|---|---|---|
| 显卡显存 | 24 GB | 32 GB 及以上(RTX 5090 / A6000 / L20) | 24G 需用 int8 量化权重 + 低分辨率 |
| 系统盘 | 60 GB | 100 GB | 模型已内置,系统盘只放环境 |
| 数据盘 | 50 GB | 100 GB | 出片缓存 + 你自己的参考图/音频 |
| 带宽 | — | 按量计费实例即可 | 模型不再下载,开机无需长时间等待 |
本镜像在 RTX 5090 32G 上实测通过:1344×768 / 20 步 / 5 秒,约 5 分钟一条;864×480 / 4 步,约 68 秒一条。
三、快速开始(5 步)
① 创建容器实例 → ② 选本镜像 + 32G 显卡 → ③ 开机
      → ④ 浏览器打开 http://<实例IP>:8188 → ⑤ 载入 R2V 模板,出片
四、详细部署步骤
步骤 1:选择镜像并创建实例
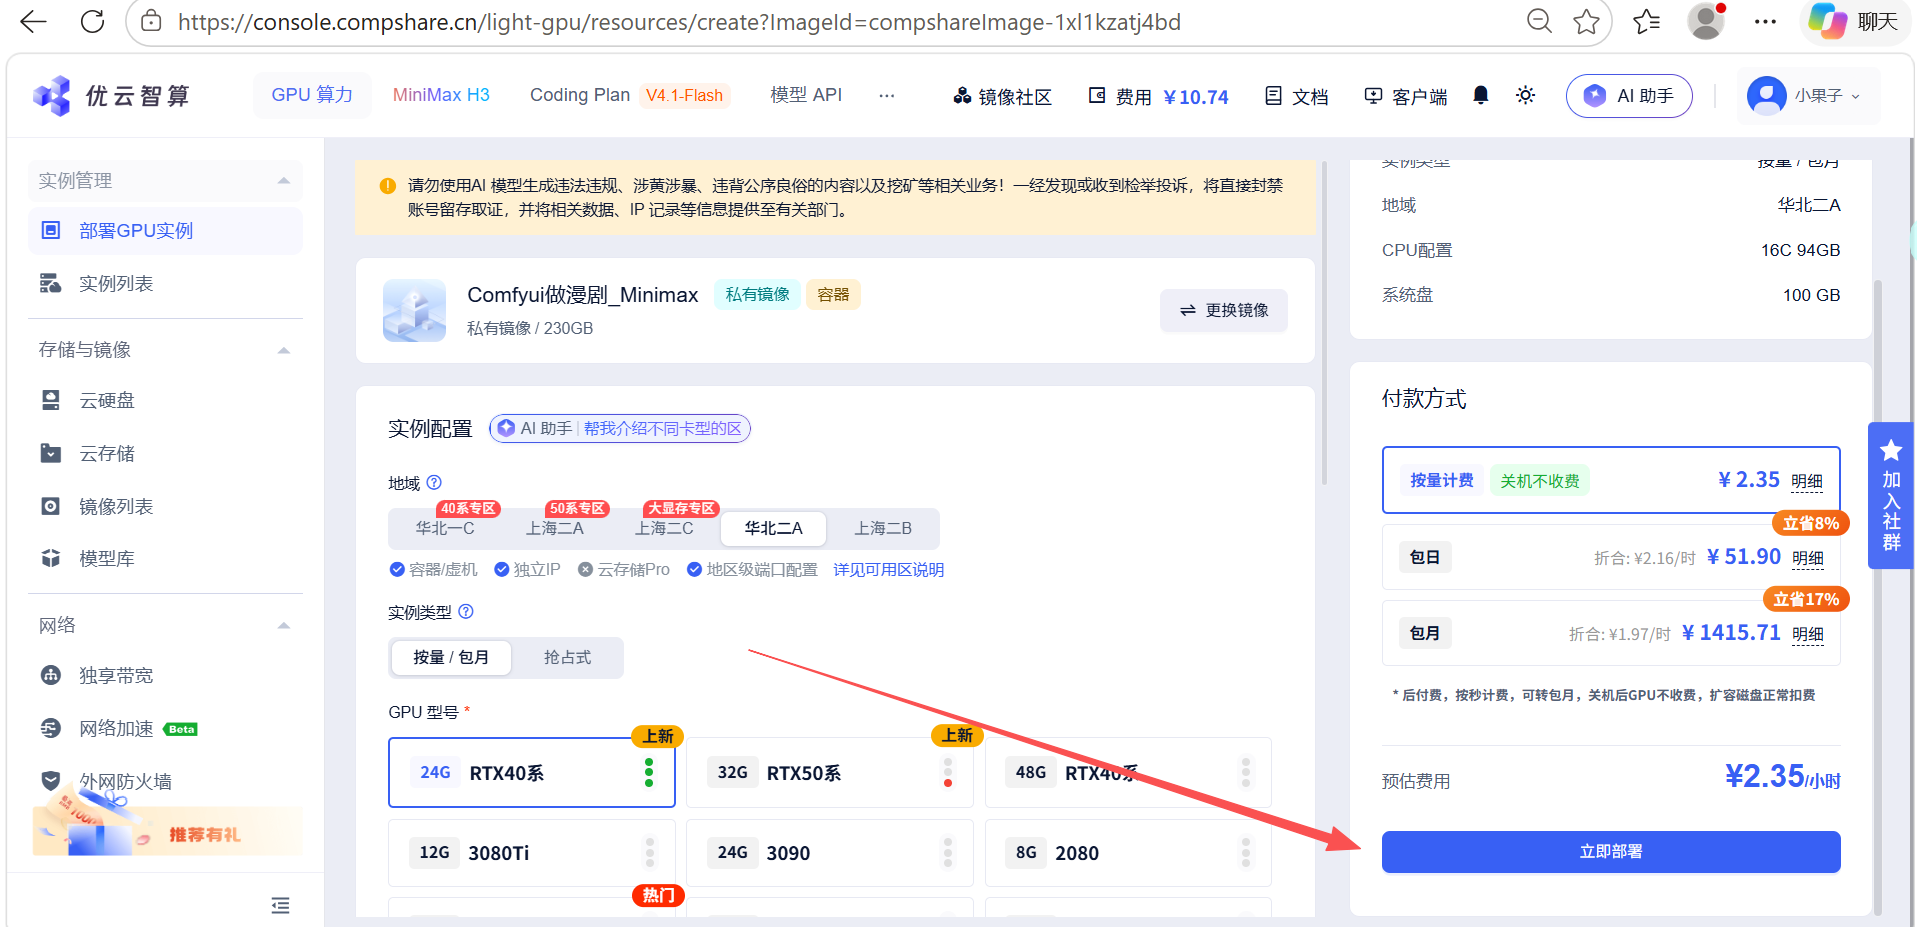
进入 部署 GPU 实例 页面,选择本镜像(Comfyui做漫剧_Minimax),确认实例配置: 地区任选有库存的可用区、实例类型选 容器/按量、GPU 型号选 32G 及以上(如 RTX 5090), 点击右下角 「立即部署」。
步骤 2:开机并获取访问地址
实例创建后约 1–3 分钟进入可启动状态。在实例详情页点击 「启动」, 开机后复制页面上的 公网 IP,ComfyUI 服务监听在 8188 端口。
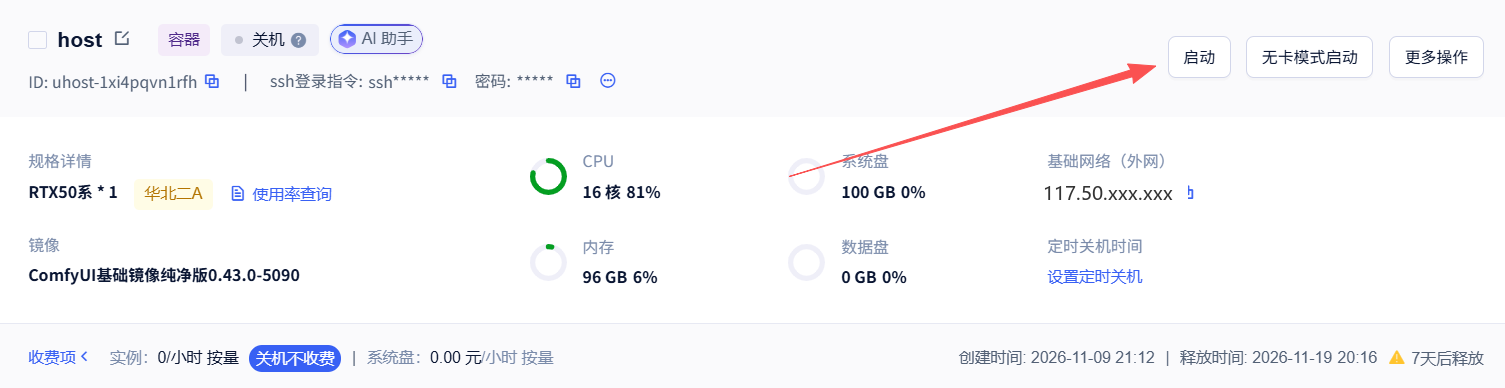
⚠️ 如果页面提示需要开放端口/安全组,请确保 8188 已放行,否则浏览器访问会超时。
步骤 3:打开 ComfyUI
浏览器访问:
http://<你的实例公网IP>:8188
看到 ComfyUI 的节点画布即表示环境正常,模型已就位,不需要任何额外安装。
步骤 4:打开内置工作流
点击 ComfyUI 左侧边栏的「工作流」图标,列表里已预置 4 条可直接使用的工作流:
| 工作流 | 用途 |
|---|---|
| minimax_h3_首尾帧生视频 | 首帧(+可选尾帧)生视频,可带音频 |
| video_minimax_h3_i2v | 图生视频 |
| video_minimax_h3_t2v | 文生视频 |
| audio_minimax_music_3 | 音乐生成 |
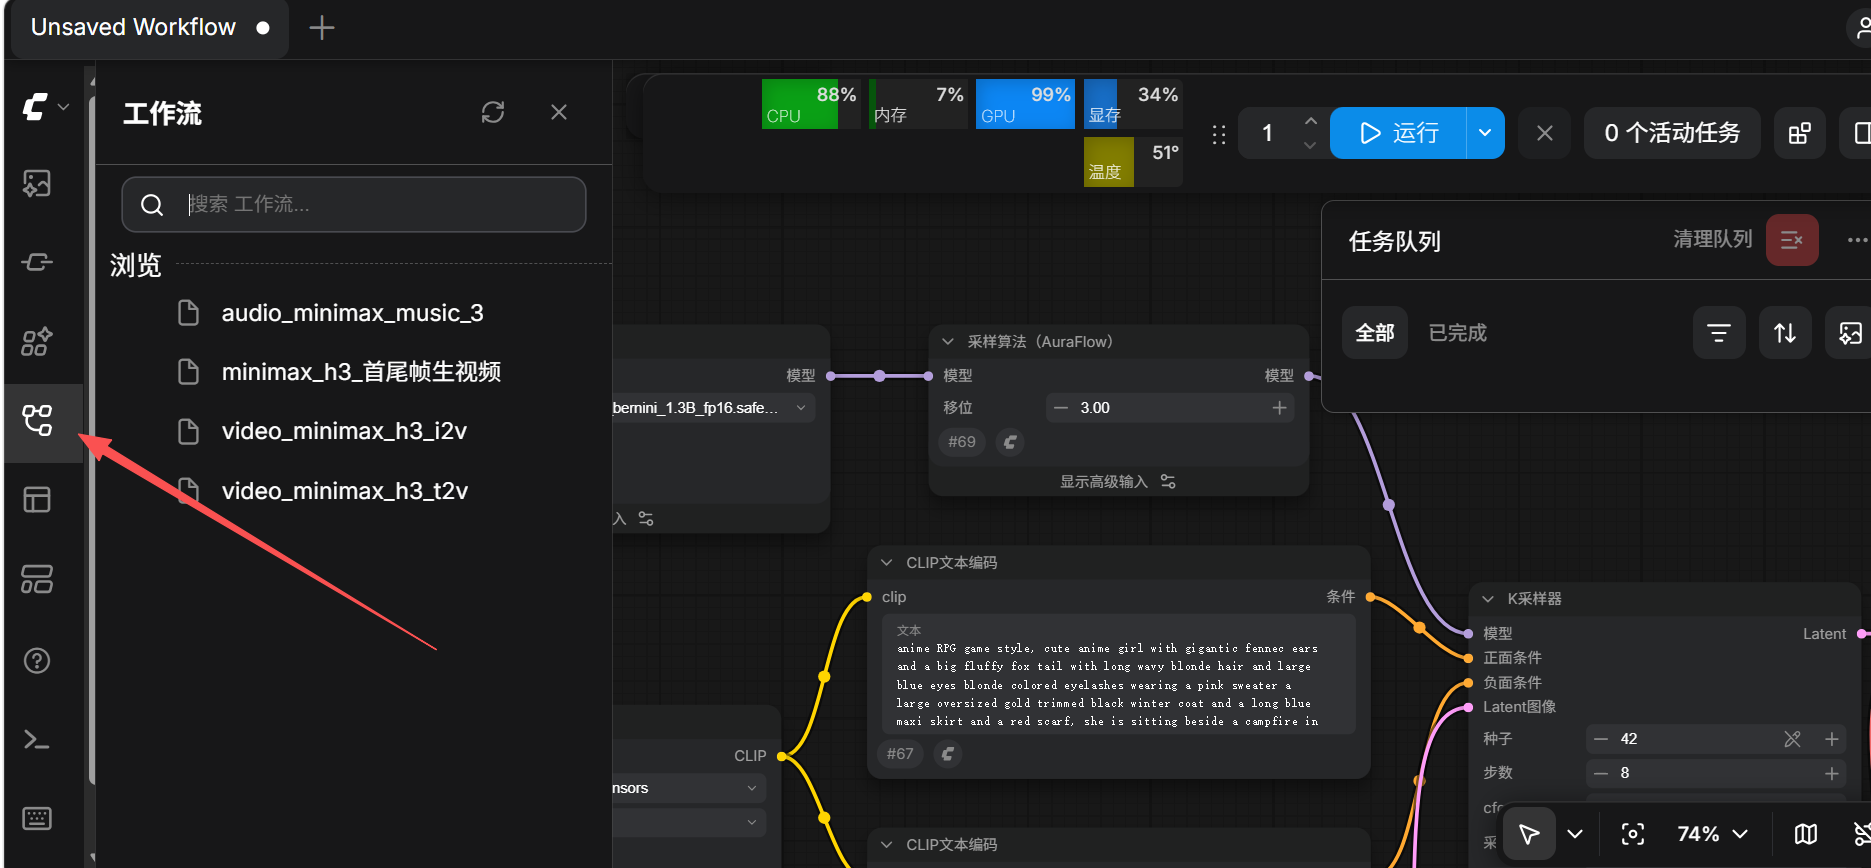
双击打开工作流,即可看到完整的节点接线图:
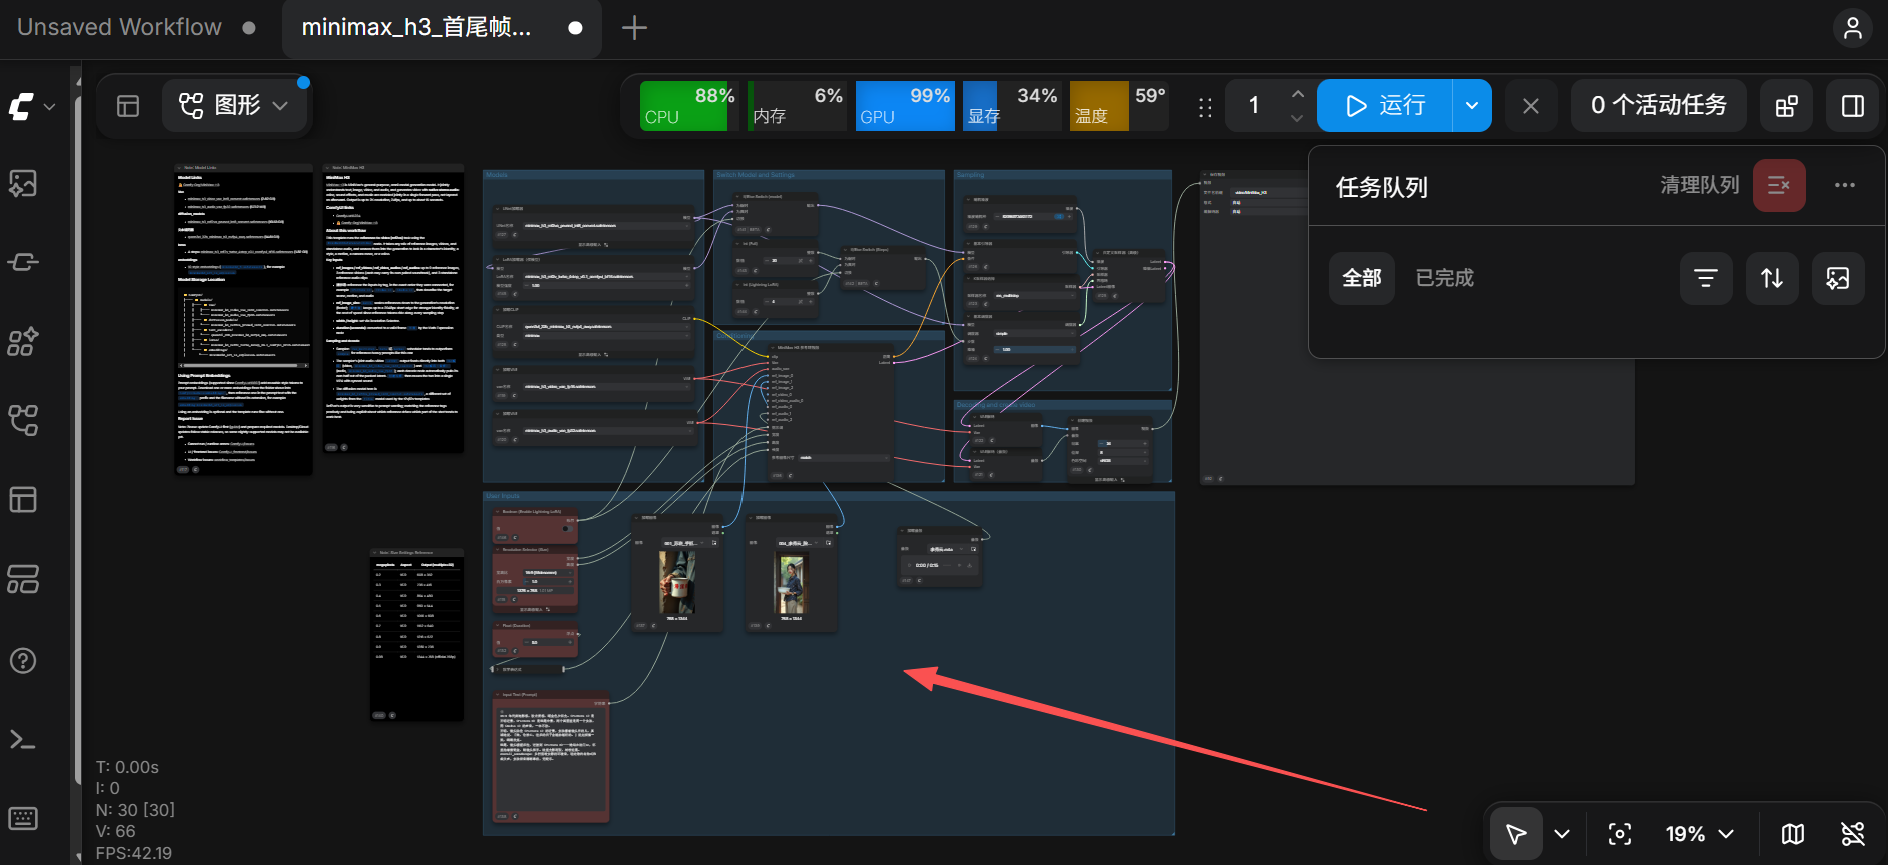
五、出片流程(首尾帧 / 参考生视频)
5.1 载入工作流
左侧边栏「工作流」列表里,双击 minimax_h3_首尾帧生视频(要固定音色、用参考图锁人物时选它,侧边栏样式见上文图 3)。
5.2 三个输入怎么接
| 输入 | 接什么 | 说明 |
|---|---|---|
ref_image_0 … | 角色定妆图 / 首帧图 | 建议 1–3 张同一人物不同角度,越清晰越像 |
ref_audio_0 | 一段 2–15 秒干净人声 | 这就是"固定声音",模型沿用该音色 |
| 提示词 | 镜头描述 | 用 <Picture 1>、<Audio 1> 引用输入 |
接入音频:画布空白处双击 → 搜索 加载音频 / LoadAudio → 添加 →
点击节点上的上传按钮选择文件 → 从 AUDIO 输出拉线到 ref_audios。
接线顺序 = 提示词里的标签顺序:先接的图是
<Picture 1>,第一段音频是<Audio 1>。
5.3 参数建议
| 参数 | 快速验证 | 定稿高清 |
|---|---|---|
| 分辨率 / megapixels | 0.40(约 864×480) | 0.98(1344×768) |
| 比例 | 16:9 / 9:16 | 同左 |
| 步数 steps | 4(Turbo LoRA) | 20(关闭 LoRA,strength=0) |
ref_image_size | match | max(保留细节,锁脸关键) |
| 时长 | 5 秒(124 帧) | 5–10 秒 |
| 单条耗时(5090) | ≈ 68 秒 | ≈ 5 分钟 |
帧数规则:
length必须满足(length − 5) % 17 == 0。 5 秒 → 124 帧,6 秒 → 141 帧,10 秒 → 243 帧。
5.4 提示词写法(有效模板)
16:9 写实电影质感,35mm 胶片颗粒。以 <Picture 1> 中人物的长相为准,
五官、脸型、年龄、发型完全一致,不要美化、不要换脸。
人物在室内自然说话,用 <Audio 1> 的音色和语速,说 <Audio 1> 里的台词,一字不改。
镜头缓慢推近,柔和自然光。
overall_soundscape: 安静的室内环境音,人声清晰靠前,无配乐。
三条经验:
- 不要用文字重复描述五官——一旦写"瘦削、颧骨高",模型会按文字重画一张脸,参考图就白给了。
- 标签顺序 = 连线顺序:先接的图是
<Picture 1>,第一段音频是<Audio 1>。 - 台词长度匹配时长:5 秒约 12–15 个字,超出会被截断。
5.5 运行与下载
点右上角 运行 / Run,任务进入右侧队列;完成后视频出现在右侧「任务队列」条目中,点击即可预览、下载。
六、常见问题
| 现象 | 原因 | 解决 |
|---|---|---|
| 打开页面提示 缺模型 | 模板引用了未包含的权重 | 把 VAELoader 换成 minimax_h3_video_vae_fp16.safetensors |
| CUDA out of memory | 分辨率/时长过高 | megapixels 降到 0.40,时长降到 5 秒,ref_image_size 用 match |
| 生成的人物不像参考图 | ref_image_size=match 或提示词重复描述五官 | 改 max,并删掉提示词里的五官描述 |
| 声音有口音 / 不是想要的音色 | 参考音频本身带口音 | 换一段干净的标准音色样本(5–8 秒最佳) |
| 上传图片/音频失败 | 中文文件名 | 改成英文名(如 voice.mp3、face.png) |
| 台词念错 / 自己编词 | H3 只借音色、不保证逐字复述 | 画面照常生成,后期用 TTS 原声替换音轨(口型已对齐) |
| 视频末尾被截断 | 视频时长 < 音频时长 | 视频时长设为音频 +1 秒 |
| 4 步出片脸糊 | Turbo LoRA 只保结构不保细节 | 定稿阶段用 20 步 + 关闭 LoRA |
七、目录与端口
| 项 | 值 |
|---|---|
| ComfyUI 端口 | 8188 |
| 访问地址 | http://<公网IP>:8188 |
| 输出目录 | ComfyUI output/(页面右侧队列可直接下载) |
| 模型位置 | ComfyUI models/ 下对应子目录,模型下拉框可直接选择 |
八、合规提示
- 参考音频请使用本人录制或已获授权的声音,不要使用影视剧、他人短视频中的音源。
- 生成人物形象请确保不侵犯他人肖像权;商用前请确认素材版权。
- 发布到短视频平台时,请按平台要求标注 AI 生成内容。
九、版本记录
| 版本 | 日期 | 说明 |
|---|---|---|
| v1.0 | 2026-11 | ComfyUI + MiniMax H3(Ref2VA / FL2VA)+ 4 步 Turbo LoRA + Qwen-Image-Edit;已内置全部权重与官方模板 |
开箱即用,无需下载模型。 如遇问题,请在本镜像页面留言,附上 ComfyUI 报错截图与显卡型号。