IndexTTS2.5最强AI音频工作台
IndexTTS2.5最强AI音频工作台 支持音色克隆| 语气克隆|多角色对话|方言|多语言|批量生成
运行环境
框架版本
CUDA版本
13.2
应用
JupyterLab: 8888
自定义开放端口
9005
支持卡型
RTX50系RTX40系
+6
使用教程
1. 打开工作台
启动实例后,打开平台提供的 9000 端口访问地址。页面显示启动提示时,请等待环境检查完成,随后进入工作台。
首次生成需要加载模型,耗时较长,后续使用相同模型生成会更快。
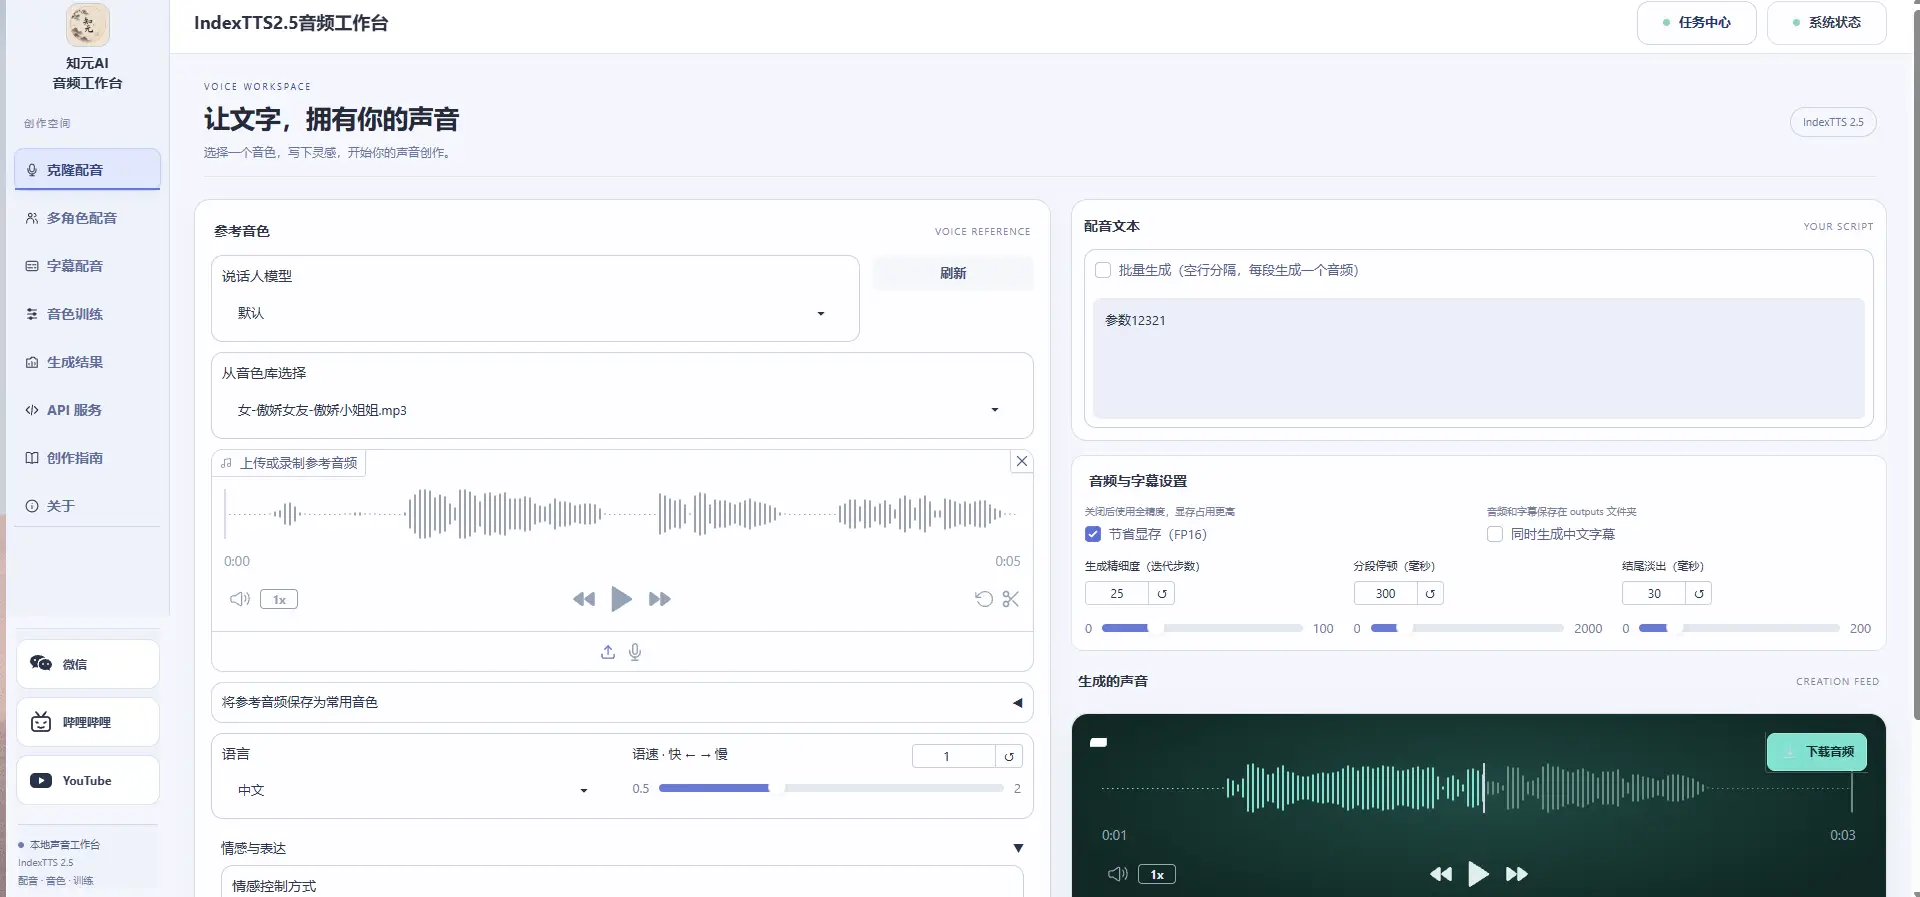
2. 克隆配音
- 在左侧选择 克隆配音。
- 说话人模型选择 默认,或选择已训练的音色模型。
- 从音色库选择参考音频,也可以上传或录制音频。建议使用约 10 秒、单人说话、无背景音乐的清晰素材。
- 输入需要配音的文字,选择对应语言。
- 根据需要调整语速、情感、分段停顿等参数,首次使用建议保持默认。
- 点击 生成语音,完成后在「生成的声音」区域试听、下载。
上传的参考音频可以保存为常用音色,方便下次直接选择。
3. 调整情感
在「情感控制方式」中选择:
- 与音色参考音频相同:使用参考声音中的情感。
- 使用情感参考音频:上传或选择另一段音频作为情感参考。
- 使用情感向量控制:调整喜悦、愤怒、悲伤等情感强度。
- 使用情感描述文本控制:输入情感描述,例如“温柔、平静地讲述故事”。
4. 批量生成
勾选 批量生成,使用空行分隔文本,每段会生成一个独立音频:
欢迎来到知元AI音频工作台。

这是第二段需要生成的配音内容。

感谢收听,我们下期再见。
点击生成后,任务依次执行。可在顶部 任务中心 查看进度,请勿重复点击提交。
5. 多角色配音
进入 多角色配音,按以下格式填写文本:
[小知]: 欢迎来到我们的音频工作台。
[小元]: 我们可以使用不同的声音进行对话。
在角色设置中填写相同的角色名,为每个角色选择参考音色,然后生成对话音频。
6. 字幕配音
进入 字幕配音,上传 .srt 字幕文件,选择音色并生成。程序会逐条生成语音,对齐字幕时间轴。
7. 音色训练
进入 音色训练,按照页面顺序完成:
输入中文名称 → 上传素材 → 音频切分 → 识别转录 → 检查文本 → 提取特征 → 开始训练。
训练完成后,返回克隆配音页面,刷新说话人模型列表,选择对应名称使用。
8. 查看与下载作品
进入 生成结果,搜索或选择作品,查看配音文本、试听并下载音频。启用中文字幕生成后,可在输出目录中找到对应字幕文件。
顶部 系统状态 可查看 CPU、内存、GPU 和显存占用情况。